
 语音小管家
语音交互和语音通信依赖清晰、可分辨的输入信号。真实环境中的风扇、道路、键盘等背景噪声会掩盖语音,扬声器回放进入麦克风会形成回声,多人同时讲话则会造成语音混叠。降噪、声学回声消除(AEC)和语音分离分别处理这三类问题,直接影响语音识别、唤醒与对话、会议通话以及语音克隆的稳定性。
语音增强也助力到语音大模型的数据工程环节。原始音视频在进入转写、切分、说话人标注、语音—文本对齐和训练之前,先完成质量检测与增强,可减少噪声、回声和重叠语音向标注与训练环节的传递。保留原始音频、增强音频及处理元数据,既能提升可用样本比例,也便于追溯、复评与重新处理。
| 现实声音问题 | 对应能力 | 直接影响 |
| 背景噪声 | 语音降噪 DNS | 识别、唤醒、对话与语音克隆参考音频 |
| 扬声器回声 | 回声消除 AEC | 双讲通信、会议拾音与远端听感 |
| 多人重叠说话 | 语音分离 BSS | 说话人标注、会议转写与训练样本构建 |
▎本次上新模型
Qwen Audio 团队在语音开源生态上持续投入:一方面在魔搭社区(ModelScope)上开源开放了一系列先进的语音模型,为业界提供丰富的 AI 资源与技术支撑;另一方面作为 FunAudioLLM、CosyVoice、FunASR、3D-Speaker、Qwen-Audio-Agent 等开源社区的主要发起者与维护者,积极推动语音技术的共享与创新。语音增强相关模型下载量在 ModelScope 开源社区已超千万,此次进一步新增高效的单通道语音分离和可解释型端到端回声消除模型。
| 模型 | 处理任务 | 核心结构 | 工程价值 |
| FLASepformer | 单通道语音分离 | Gated Focused Linear Attention;包含 FLA-SepReformer 与 FLA-TFLocoformer | 线性复杂度处理长序列,降低推理时间与显存占用 |
| JAEC 16K | 声学回声消除 | 神经 TDE + 神经 LP,形成可解释处理链路 | 可解释、低延迟,适合实时通话与会议前端 |
▎FLASepformer 高效语音分离
FLASepformer 面向长序列语音分离。它以 Focused Linear Attention 和门控模块将注意力计算复杂度从 O(N²) 降为 O(N),形成 FLA-SepReformer 与 FLA-TFLocoformer 两种结构;论文在 WSJ0-2Mix、WHAM!、WHAMR! 和 Libri2Mix 等数据集上进行了验证。
在论文的 RTX A800、30 秒混合音频设置下,FLA-SepReformer-T/B/L 的推理速度分别达到对应 SepReformer 基线的 2.29 倍、1.91 倍和 1.49 倍,GPU 显存占用分别为 15.8%、20.9% 和 31.9%,同时保持有竞争力的分离性能。
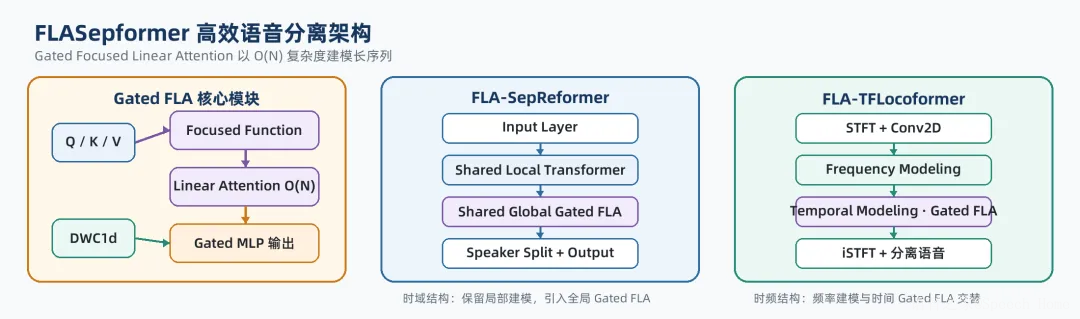
(图 1:Gated FLA 模块、FLA-SepReformer 与 FLA-TFLocoformer 结构)
▎JAEC 可解释型回声消除
JAEC 为可解释型的端到端 AEC 模型。时延估计 TDE 与线性处理 LP 均由神经网络实现:TDE 网络估计远端参考与麦克风信号的相对时延并完成对齐,LP 网络估计线性回声并完成抵消;可观察的时延与线性处理过程便于通信链路调试。
当前开源的 16 kHz 版本每次处理 160 个采样点(10 ms),固定算法延迟 352 个采样点(22 ms),输出 TDE+LP 前端结果,暂不包含非线性处理 NLP 网络。
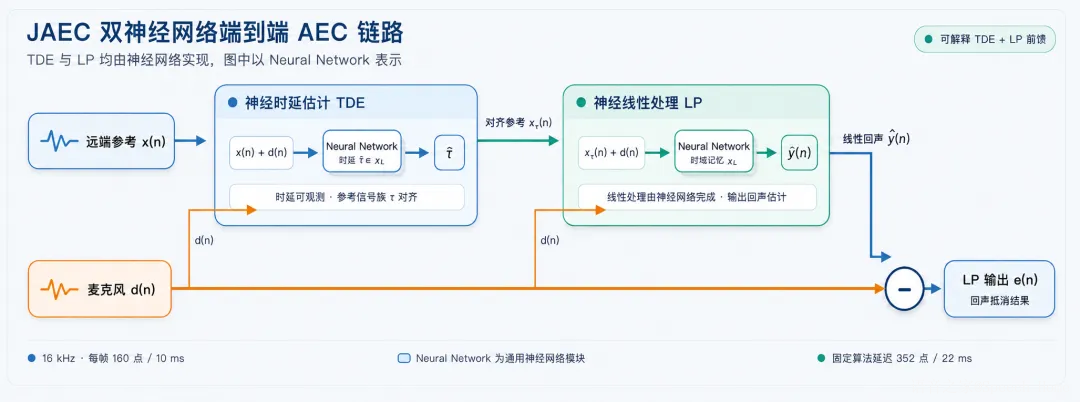
(图 2:JAEC 双神经网络 TDE+LP 处理链路)▎系列开放模型与能力一览语音增强系列模型能力覆盖语音分离、语音降噪与声学回声消除。下表汇总本文涉及的模型、核心能力及开放资源。不同模型的采样率、输入信号和实时性约束不同,选择时应以模型卡和业务评测结果为准。
| 模型 | 核心能力与特点 |
| FLASepformer 8k | 单通道语音分离;Gated Focused Linear Attention 将长序列注意力复杂度降至 O(N),兼顾分离性能、推理速度与显存占用 |
| JAEC 16k | 声学回声消除;TDE 与 LP 均由神经网络实现,组成可解释链路,固定算法延迟 22 ms |
| ZipEnhancer 16k | 单麦语音降噪;基于 Zipformer 的双路径降采样—升采样结构与多损失训练,适合识别、语音克隆和离线清洗 |
| DFSMN ANS 48k | 48 kHz 实时语音降噪;Deep-FSMN 建模时序记忆,支持流式处理与 ONNX 导出,适合会议和端侧通信 |
| FRCRN 16k | 单麦语音增强;频率递归与复数域 cIRM 建模,兼顾长距离频率关系和时间动态,适合复杂噪声与批量清洗 |
| MossFormer2 8k | 单通道语音分离;融合 Transformer 的长程建模与基于 FSMN 的无循环连接递归模块,处理细粒度时序模式 |
| DFSMN AEC 16k | 声学回声消除;时延补偿、线性自适应滤波与 DFSMN 相位敏感掩码残余回声抑制,面向实时通信 |
▎语音增强进入语音大模型数据工程
对语音大模型而言,增强模型的价值同样体现在数据入口。它们可以在 VAD、ASR、说话人日志和语音—文本对齐之前先清理信号:FLASepformer 拆分重叠说话人,JAEC 抵消回放链路产生的回声,降噪模型抑制环境噪声,从而降低错误向标注、配对和训练数据传播的概率。
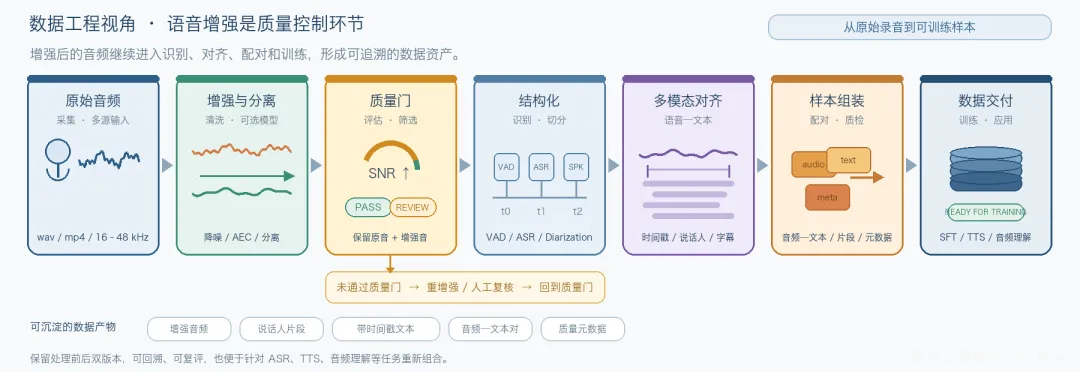
(图 3:语音增强作为数据入口的质量控制环节)
工程实践中建议保留原始音频、增强音频、模型版本、质量分数和处理日志。质量门未通过的样本可重新增强或转人工复核,避免不可逆清洗。
▎应用场景
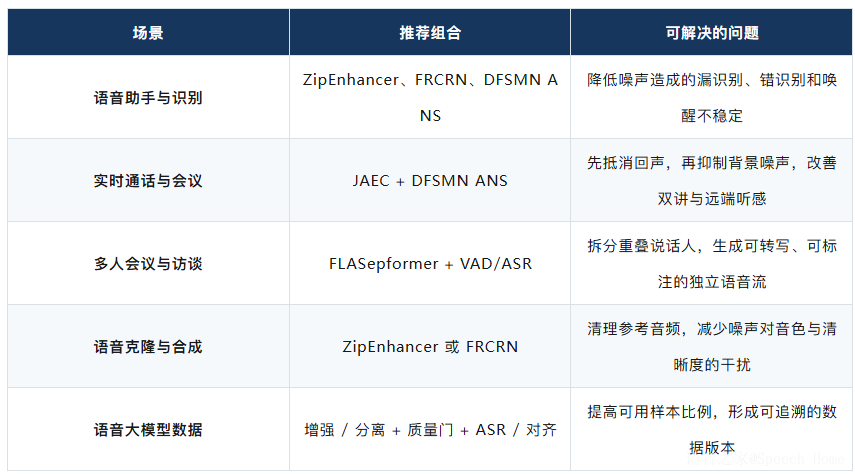
▎公开应用与项目案例
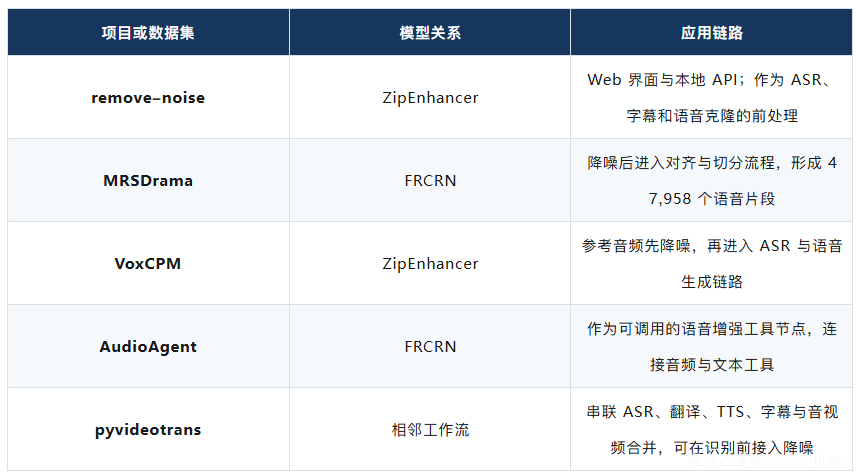
公开项目已经把语音增强接入本地工具、语音合成、数据集生产和音频智能体。下表保留模型关系明确或可直接衔接的代表性案例;部署前应核对许可证、模型版本和采样率。
▎离线降噪 API 与 Skill
面向离线音频文件处理,ClawHub 上已有由社区开发者发布的 fun-denoise Skill,可通过命令行或 Python 接口调用百炼 fun-audio-denoising API,将降噪接入录音清洗、ASR 前处理、播客制作和会议录音优化流程。该 Skill 支持 wav、mp3、aac 等主流格式,并可返回音频质量评分、有效语音时长等元数据。
from denoise_cli import denoise_audio
result = denoise_audio(
    input_path="noisy_recording.wav",
    output_path="clean_audio.wav"
)
if result["success"]:
print(f"降噪完成!音频质量评分: {result['output_info']['voice_quality']}")▎模型获取与生态
目前,系列中的多款模型已在 ModelScope 公开发布,模型页面提供模型卡片、示例音频和推理代码。部分模型支持流式处理和 ONNX 导出,也可与 ClearerVoice-Studio 等开源语音处理平台衔接。
从论文中的先进方法,到可以下载和调用的模型,再到可嵌入多模态数据工程的语音前端,开放资源正在缩短研究成果进入实际应用的路径。FLASepformer 与 JAEC 分别补充高效语音分离和可解释回声消除能力。
随着语音理解、音视频生成和多模态大模型持续发展,训练和评测对语音数据质量的要求会进一步提高。让录音更清晰、让重叠说话人可分离、让音频与文本准确对齐,是语音增强模型在大模型数据工程中的直接价值。
欢迎研究者和开发者前往 ModelScope 下载模型、复现结果,也期待社区在真实业务场景中反馈问题、共建语音增强的开源生态。
参考资料(正文涉及的模型、论文、项目与工具链接统一汇总如下):
学术论文
[1] H. Wang, Y. Jiang, G. Qiao, P. Shi, and B. Tian, “FLASepformer: Efficient Speech Separation with Gated Focused Linear Attention Transformer,” In Proc. Interspeech 2025, pp. 1468-1472, 2025.
https://doi.org/10.21437/Interspeech.2025-1315
[2] H. Wang and B. Tian, “ZipEnhancer: Dual-Path Down-Up Sampling-based Zipformer for Monaural Speech Enhancement,” In Proc. IEEE ICASSP 2025, pp. 1-5, 2025. https://doi.org/10.1109/ICASSP49660.2025.10888703
[3] Y. Jiang, B. Tian, H. Wang, S. Zhao, B. Ma, D. Chen, and X. Li, “E2E-AEC: Implementing An End-To-End Neural Network Learning Approach for Acoustic Echo Cancellation,” In Proc. IEEE ICASSP 2026, pp. 14617-14621, 2026. https://doi.org/10.1109/ICASSP55912.2026.11464951
[4] S. Zhao, B. Ma, K. N. Watcharasupat, and W.-S. Gan, “FRCRN: Boosting Feature Representation Using Frequency Recurrence for Monaural Speech Enhancement,” In Proc. IEEE ICASSP 2022, pp. 9281-9285, 2022. https://doi.org/10.1109/ICASSP43922.2022.9747578
[5] S. Zhao, Y. Ma, C. Ni, C. Zhang, H. Wang, T. H. Nguyen, K. Zhou, J. Q. Yip, D. Ng, and B. Ma, “MossFormer2: Combining Transformer and RNN-Free Recurrent Network for Enhanced Time-Domain Monaural Speech Separation,” In Proc. IEEE ICASSP 2024, pp. 10356-10360, 2024. https://doi.org/10.1109/ICASSP48485.2024.10445985
[6] S. Zhang, M. Lei, Z. Yan, and L. Dai, “Deep-FSMN for Large Vocabulary Continuous Speech Recognition,” In Proc. IEEE ICASSP 2018, pp. 5869-5873, 2018.https://doi.org/10.1109/ICASSP.2018.8461404
[7] S. Zhang, Z. Wang, J. Sun, Y. Fu, B. Tian, Q. Fu, and L. Xie, “Multi-Task Deep Residual Echo Suppression with Echo-Aware Loss,” In Proc. IEEE ICASSP 2022, pp. 9127-9131, 2022.https://doi.org/10.1109/ICASSP43922.2022.9746733
[8] Z. Wang, Y. Na, B. Tian, and Q. Fu, “NN3A: Neural Network Supported Acoustic Echo Cancellation, Noise Suppression and Automatic Gain Control for Real-Time Communications,” In Proc. IEEE ICASSP 2022, pp. 661-665, 2022. https://doi.org/10.1109/ICASSP43922.2022.9746306
模型权重
FLASepformer:https://modelscope.cn/models/iic/speech_flatsepreformer_separation_temporal_8k_base_libri2mix100
JAEC 16k:https://modelscope.cn/models/iic/speech_jaec_aec_16k
ZipEnhancer 16k:https://modelscope.cn/models/iic/speech_zipenhancer_ans_multiloss_16k_base
DFSMN ANS 48k:https://modelscope.cn/models/iic/speech_dfsmn_ans_psm_48k_causal
FRCRN 16k:https://modelscope.cn/models/iic/speech_frcrn_ans_cirm_16k
MossFormer2 8k:https://modelscope.cn/models/iic/speech_mossformer2_separation_temporal_8k
DFSMN AEC 16k:https://modelscope.cn/models/iic/speech_dfsmn_aec_psm_16k
开源应用与项目
remove-noise 一键语音降噪工具:https://github.com/jianchang512/remove-noise
MRSDrama 数据集:https://arxiv.org/abs/2504.20630
VoxCPM:https://github.com/OpenBMB/VoxCPM
AudioAgent:https://openreview.net/pdf/d4e787ae8b1b2e52936958d15b6dffa8ec9fef1d.pdf
pyvideotrans 视频翻译工具:https://github.com/jianchang512/pyvideotrans
fun-denoise Skill:https://clawhub.ai/songguocola/skills/fun-denoise
