夸克健康大模型万字调研报告:国内首个!透视主任医师级「AI大脑」背后的深度工程化

7月23日,夸克健康大模型在业界引起广泛关注:其成功通过了中国12门核心学科的主任医师笔试评测,成为国内首个完成此项专业考核的AI大模型。这一成果不仅凸显了AI在严肃医疗和C端的应用潜力,也引发了行业对其背后技术逻辑与工程实践的深入探讨。…
17 0 0

7月23日,夸克健康大模型在业界引起广泛关注:其成功通过了中国12门核心学科的主任医师笔试评测,成为国内首个完成此项专业考核的AI大模型。这一成果不仅凸显了AI在严肃医疗和C端的应用潜力,也引发了行业对其背后技术逻辑与工程实践的深入探讨。…
来源丨量子位 李沐老师终于带着他的手搓语音大模型教程回归了,一千万小时音频数据训练的TTS,效果秒杀一众商业&开源的TTS。 本期视频不讲论文,李沐老师来手把手教大家怎样玩转他们团队最新研发的Higgs Audio V2模型,不仅能处理文本…
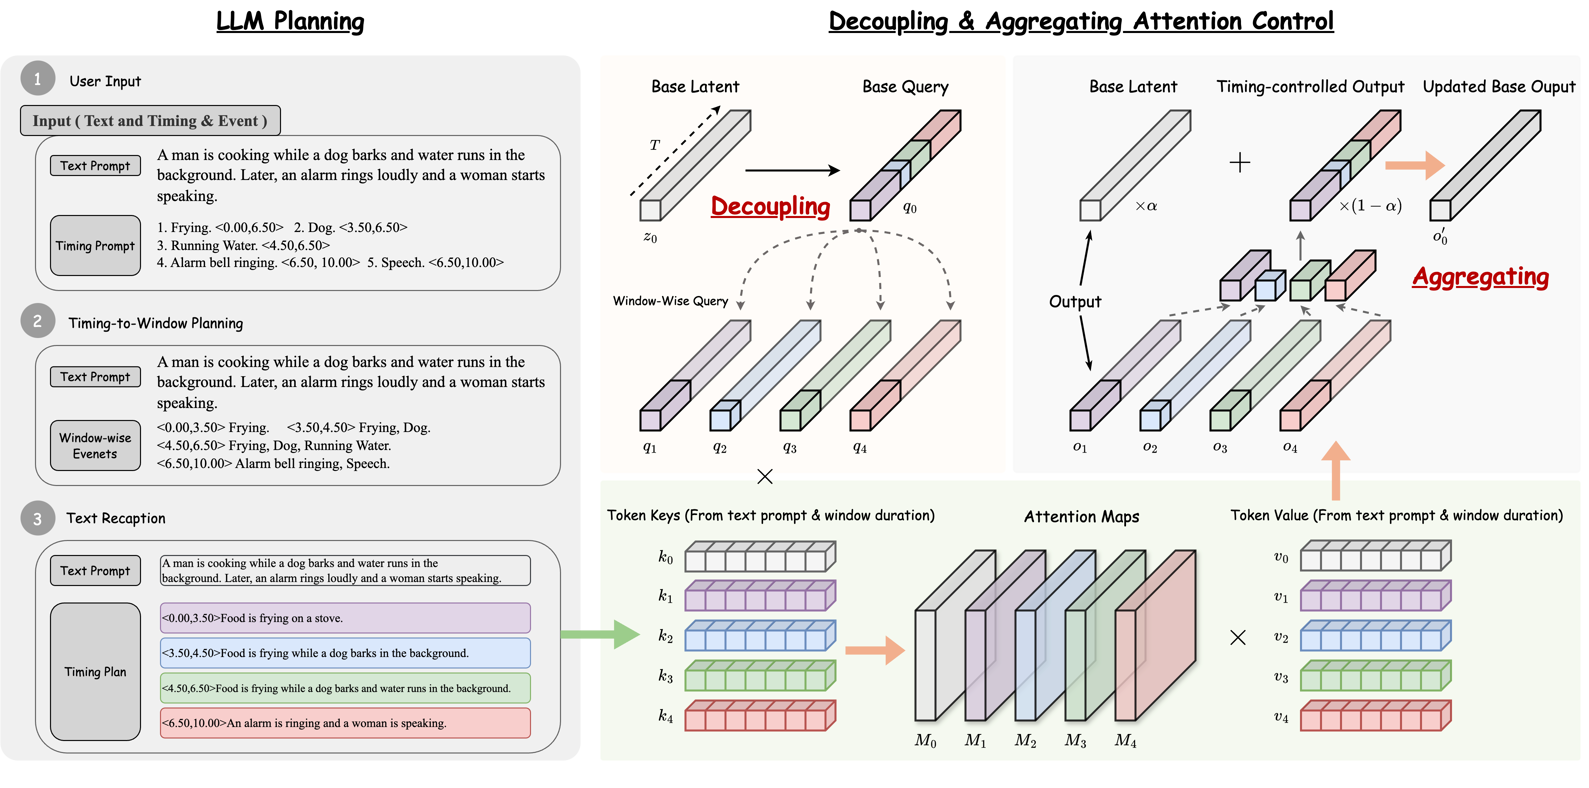
文生音频系统(Text-to-audio generation, T2A)在生成模型的持续发展下取得了显著的进展。然而,由于精确时间对齐的音频-文本数据对在质量和数量上的限制,现有 T2A 系统在面对包含精确时间控制的复杂文本提示时表现仍然…
这可不是什么未来科技的遥远设想,而是Tesla车主 Kim 与其车载 AI Grok 之间的一次真实互动。在即将开始线上会议前,仅凭一句指令,Grok 就能理解用户意图、规划充电路径、选择充电设施,并自主执行整个补能过程。这种跨越“人—车—…
当前视频到音频(Video-to-Audio, V2A)模型可以从视觉输入中生成逼真的背景音频,但它们大多忽略了语音在视频音轨中的关键组成部分。近期,西工大音频语音与语言处理研究组(ASLP@NPU)联合巨人网络、University of…
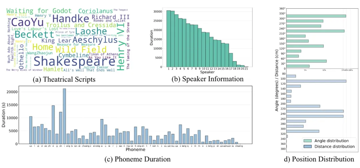
多模态沉浸式空间戏剧生成旨在基于多模态提示,创建具有戏剧韵律的连续多说话人双耳语音,在增强现实(AR)、虚拟现实(VR)等领域具有潜在应用。这项任务需要基于多模态输入同时对空间信息和戏剧韵律进行建模,且数据收集成本较高。 为此,浙江大学的学…
总部位于加利福尼亚州旧金山的语音人工智能平台 Deepgram 宣布推出 Deepgram Saga,这是一款专为开发者设计的语音操作系统,旨在消除现代开发中频繁切换工具、寻找信息的「隐形税」,让开发者能够专注于构建,而非琐碎的操作。Sag…
