INTERSPEECH 2026 论文预讲会由中国中文信息学会、CCF语音对话与听觉专委会、深圳市人工智能学会、语音之家发起,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2026 录用论文的作者进行报告交流。
INTERSPEECH 2026 论文预讲会邀请到香港中文大学(深圳)SMIIP Lab在6月29日、6月30日分别做两期专场分享,本文介绍第二场相关内容,欢迎大家预约观看。
实验室概况
香港中文大学(深圳)人工智能学院语音及多模态智能信息处理实验室,Speech and Multimodal Intelligent Information Processing (SMIIP)Lab, 致力于智能语音处理,多模态行为信号分析与理解这两个研究领域,PI为李明老师。智能语音处理领域研究方向:多说话人及抗干扰对话系统,生成式语音增强与提取,多模态具身听觉与对话系统,音频水印与隐私保护;多模态行为信号分析与理解领域研究方向:面向行为评估的多模态大模型后训练,面向行为干预的AI智能体。实验室目前招收博后,研究助理,27年博士生,硕士生等多种职位,欢迎感兴趣的同学联系,mingli369@cuhk.edu.cn。
实验室主页:https://smiip-mli.github.io
第三期-香港中文大学(深圳)SMIIP Lab【第二场】
时间:6月30日(周二)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
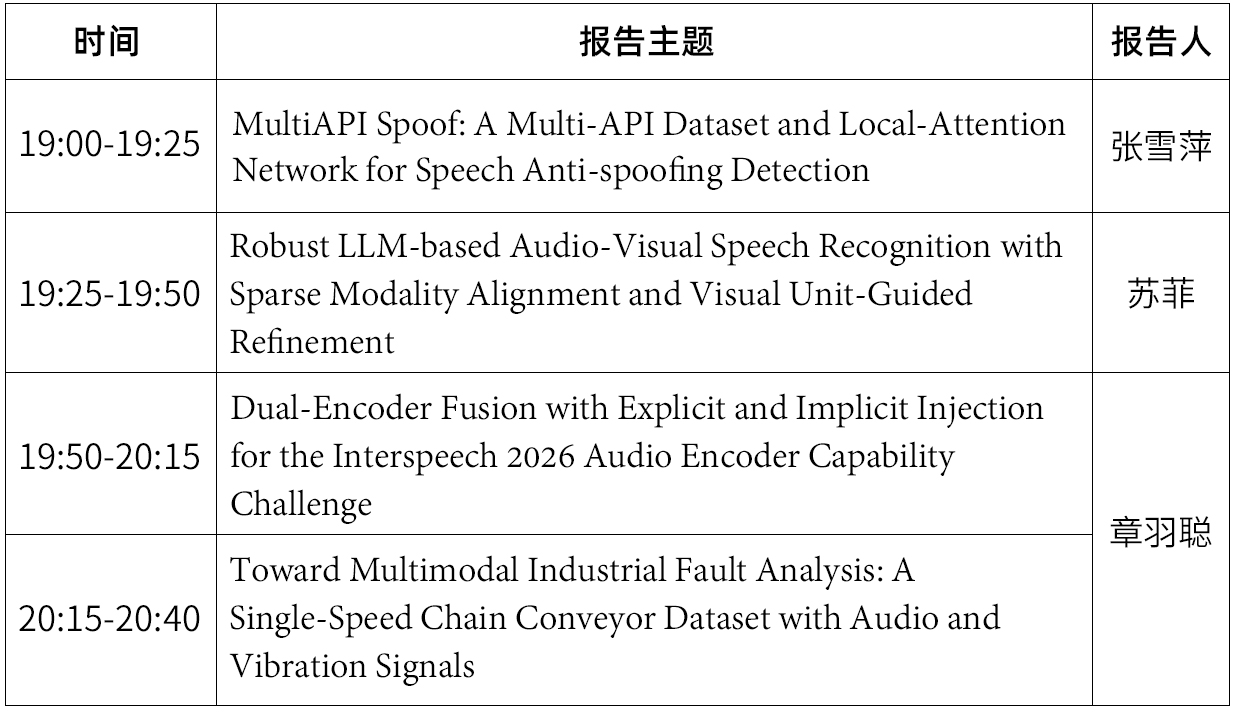
嘉宾&主题
嘉宾简介:张雪萍,昆山杜克大学语音及多模态智能信息处理实验室研究助理,硕士毕业于武汉理工大学计算机科学与技术。研究方向为语音伪造检测。作为主要贡献者在ICASSP、Interspeech、ICME等国际会议发表论文6篇,并担任ICME ESDD2 挑战赛主要组织者。
分享主题:MultiAPI Spoof: A Multi-API Dataset and Local-Attention Network for Speech Anti-spoofing Detection
作者信息:Xueping Zhang, Zhenshan Zhang, Yechen Wang, Linxi Li, Liwei Jin, Ming Li
论文单位:昆山杜克大学、香港中文大学(深圳)、OfSpectrum
数据集demo:https://xuepingzhang.github.io/MultiAPI-Spoof-Dataset/
数据集下载:https://drive.google.com/file/d/1d1MCt6ZYKv90XZic4_KvOD67RDoi2m5-/view?usp=sharing
代码:https://github.com/XuepingZhang/MultiAPI-Spoof
论文链接:https://smiip-mli.github.io/assets/pdf/2026/01/Interspeech_2026_MulitiAPI.pdf
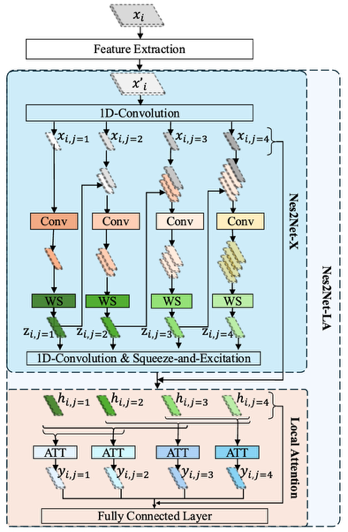
论文介绍:现有的语音反欺骗基准测试依赖于一组有限的公开模型,这与商业系统使用各种各样、通常是专有API的真实场景存在显著差距。为了解决这些局限性,我们推出了MultiAPI Spoof,这是一个全新的多API语音反欺骗数据集,旨在同时用于反欺骗检测和API级源追踪。与以往专注于少数合成系统的数据集不同,MultiAPI Spoof包含来自30个不同API生成的音频,其中包括商业TTS服务、开源语音模型和TTS网站。该数据集涵盖了约230小时的欺骗语音。基于MultiAPI Spoof数据集,我们的贡献如下:1. 我们证明了先前研究基准测试与真实欺骗场景之间存在差距;将我们的API数据集添加到训练中可以提高现有基准测试的性能。2. 此外,如右图所示,我们提出了一种基于Nes2Net的新型反欺骗检测方法,即Nes2Net-LA。通过在嵌套模块之间集成局部注意力模块,Nes2Net-LA 增强了局部上下文建模和细粒度欺骗特征提取,从而提高了鲁棒性和判别能力。Nes2Net-LA 在多个反欺骗基准测试中均取得了最先进的性能。3. 最后,我们引入了 API 追踪任务,旨在识别欺骗音频的生成 API,并为细粒度的来源归属建立基准。
嘉宾简介:苏菲,武汉大学计算机学院三年级博士研究生,研究方向为多模态音视频语音识别等。以第一作者发表Interspeech、ICME等国际会议论文,多项成果发表于ICME、Interspeech、ICPR等CCF推荐会议;获得MISP、ChatCLR、CNVSRC等挑战赛奖项,以及第七届中国研究生人工智能创新大赛三等奖等,在多模态语音智能领域取得了较好的研究成果。
分享主题:Robust LLM-based Audio-Visual Speech Recognition with Sparse Modality Alignment and Visual Unit-Guided Refinement
作者信息:Fei Su, Cancan Li, Juan Liu, Wei Ju, Hongbin Suo, and Ming Li
论文单位:武汉大学、香港中文大学(深圳)、OPPO
论文链接:https://smiip-mli.github.io/assets/pdf/2026/01/Interspeech_2026_sufei.pdf
代码链接:https://github.com/yakumo72/AVUR-LLM
论文介绍:
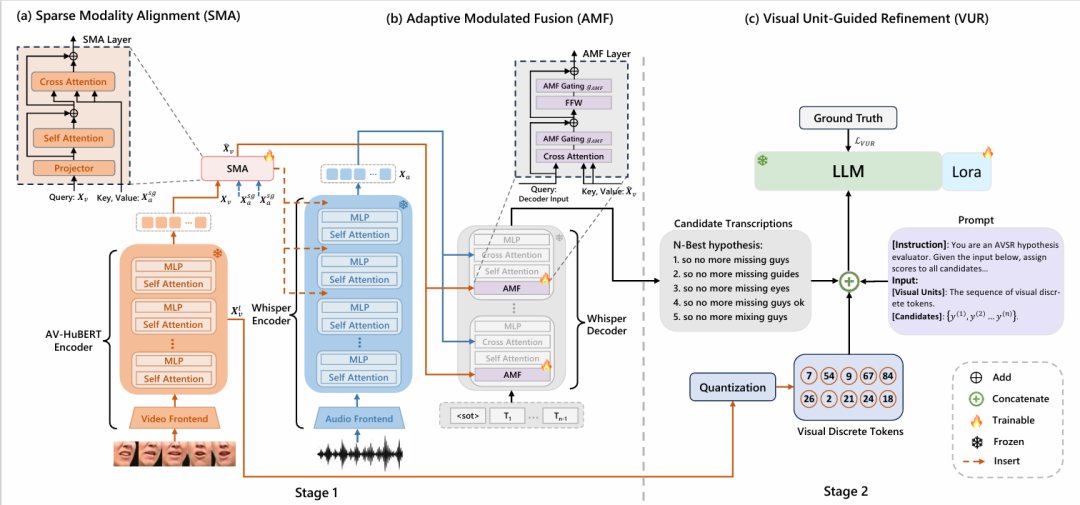
本文提出了一种基于大语言模型的鲁棒音视频语音识别方法。针对现有大语言模型音视频语音识别系统存在跨模态对齐不足、视觉信息利用不充分以及噪声环境下鲁棒性受限等问题,提出稀疏模态对齐机制,在保持预训练音频模型稳定性的同时实现音视频特征的有效交互;设计自适应调制融合策略,根据声学信息可靠性动态调节视觉信息的引入强度,增强模型在复杂噪声场景下的识别能力;进一步提出视觉单元引导优化方法,将视觉离散单元作为提示信息引入大语言模型,从而充分利用视觉语义信息提升识别性能。实验结果表明,我们的方法能够有效提升音视频语音识别系统在干净和噪声环境下的识别准确率,在公开基准数据集上取得了优于现有主流方法的性能表现,展现出良好的识别性能和鲁棒性。
嘉宾简介:章羽聪,武汉大学计算机学院三年级博士研究生,香港中文大学(深圳)语音及多模态智能信息处理实验室研究实习生。研究方向为异常声音事件检测、音频理解等,目前以一作身份在Interspeech、ICASSP、CSL等国际期刊会议上发表论文9篇。
论文题目1:Dual-Encoder Fusion with Explicit and Implicit Injection for the Interspeech 2026 Audio Encoder Capability Challenge
作者信息:Yucong Zhang, Zhang Chen, Juan Liu, Wei Ju, Hongbin Suo, Ming Li
论文单位:武汉大学、香港中文大学(深圳)、OPPO、昆山杜克大学
模型链接:
https://huggingface.co/yucongzh/explicit_fusion
https://huggingface.co/yucongzh/implicit_fusion
论文链接:https://smiip-mli.github.io/assets/pdf/2026/01/Interspeech_2026_zhang26AECC.pdf
论文介绍:
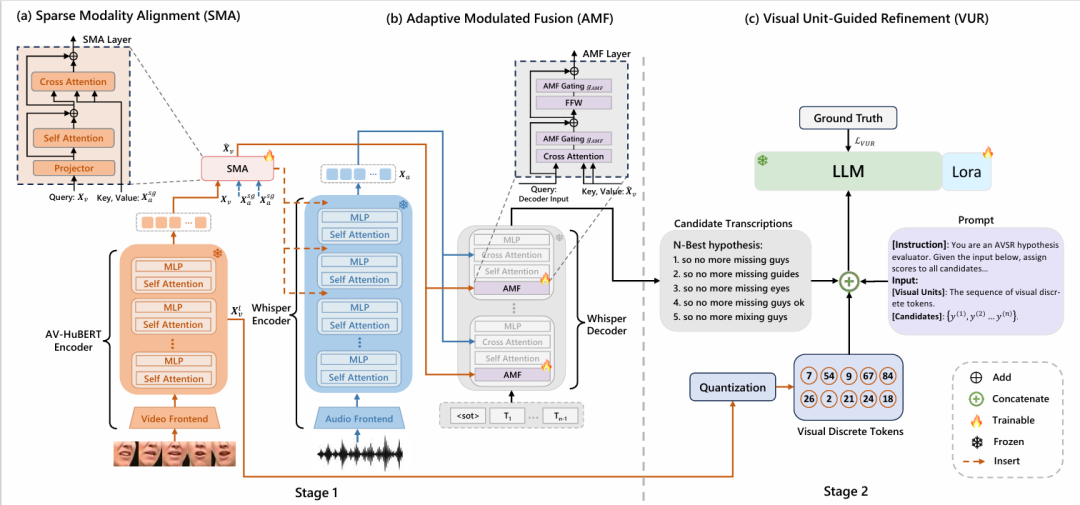
图 1 双编码器 Softmax 门控残差融合框图
在大音频语言模型中,音频编码器负责将原始波形转换为语言模型能够处理的特征表示,其能力会直接影响后续的音频分类与理解表现。然而,不同预训练音频编码器由于预训练数据不同可能会具有不同的表示偏好:Whisper 经过大规模语音转写训练,更擅长捕捉语音内容与语言语义;Dasheng 采用大规模掩码音频建模,则能够提供更丰富的环境声、音乐和通用声学信息。
基于两者的互补性,我们围绕一个核心问题展开研究:如何将不同音频编码器的互补能力,稳定地转化为跨任务性能增益?论文首先比较了多种双编码器融合方式,包括:
- 特征拼接:直接拼接 Whisper 和 Dasheng 的输出特征;
- Mixture-of-Experts 路由:根据输入动态选择不同的融合专家;
- Softmax 门控残差融合:逐帧学习两路编码器的融合权重,并通过残差连接保留两路原始信息;
- STFT 频谱残差分支:从原始波形中补充预训练编码器可能弱化的声学信息。
实验发现,Mixture-of-Experts 虽然能够在部分任务中取得较高的单项结果,但训练和路由过程更加敏感。相比之下,Softmax 门控残差融合在不同任务之间表现得更加稳定。加入轻量级 STFT 分支后,模型在环境声、音乐和语音命令等声学驱动任务上获得了进一步提升。
在确定基础融合框架后,论文进一步研究了两种互补信息注入机制:
- 隐式注入:先利用 LoRA 在 AECC 训练数据上适配 Dasheng,再冻结 Whisper 和 Dasheng,仅训练融合模块。该方法不显式区分共享信息与互补信息,而是让 Dasheng 在任务数据中自动学习更合适的表示;
- 显式注入:使用 Whisper 特征预测 Dasheng 中可以被解释的共享成分,再将无法预测的残差视为互补信息,并通过残差能量约束和去相关正则进行注入。
实验覆盖环境声、音乐、情感、说话人、语言识别、语音识别和音频语言理解等多类任务。结果表明:
- 隐式注入在 Track A 音频分类任务中取得了更高、更稳定的整体分数;
- 显式注入在更多单项任务上获得最佳结果,并在 Track B 音频理解任务中取得最高总体表现。
- 这项工作说明,双编码器融合的关键可能并不只是简单增加编码器数量,而在于识别、保留并有控制地注入编码器之间真正非冗余的互补信息。
论文题目2:Toward Multimodal Industrial Fault Analysis: A Single-Speed Chain Conveyor Dataset with Audio and Vibration Signals
作者信息:Zhang Chen*, Yucong Zhang*, Xiaoxiao Miao, Ming Li
论文单位:昆山杜克大学、香港中文大学(深圳)、武汉大学
数据集Demo链接:https://yucongzh.github.io/SSCC-Dataset
数据集下载链接:https://drive.google.com/drive/folders/1FxJBwPrZy21SBwPBI5rCoRAEEEnD6r7E
Benchmark链接:https://github.com/yucongzh/SSCC-Fault-Benchmark
论文链接:https://smiip-mli.github.io/assets/pdf/2026/01/Interspeech_2026_zhang26SSCC.pdf
论文介绍:
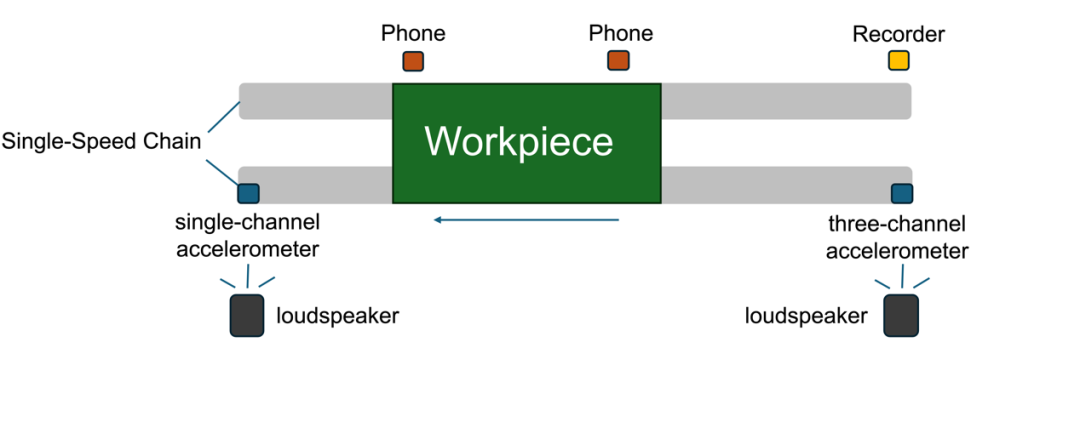
图 1 系统布局与传感器配置示意图
现有工业故障诊断数据集大多集中于轴承、电机等单一机械部件,通常只包含振动或音频中的一种信号模态,并主要采集于较为理想的实验室环境。这类数据虽然推动了数据驱动故障分析的发展,但难以充分反映真实生产线中的系统耦合、工况变化、多传感器差异与复杂环境噪声。针对这些问题,我们构建并发布了一个面向系统级工业故障分析的单速链式输送机多模态数据集——SSCC Dataset。与传统的单部件故障数据集不同,SSCC 以完整的链式输送系统为研究对象,关注故障在电机、链条、导轨和输送结构之间的传播与耦合。
数据集具有以下特点:
- 多模态采集:同时包含三路音频信号和四路振动信号,共七个采集通道;
- 多种采集设备:音频分别由专业录音设备、iPhone 和 Android 手机采集,以保留真实的设备和麦克风差异;
- 多工况覆盖:包含五种输送速度、三种负载水平,以及干净和噪声两类采集环境;
- 真实工厂噪声:噪声并非后期直接叠加,而是先在真实工厂中采集,再通过实验现场的扬声器进行物理重放,使其与设备声学传播和传感器响应自然耦合。
数据集覆盖正常运行状态和四类具有代表性的输送机故障:
- Lean:导轨偏移;
- Dry:链条润滑不足;
- Loose:两侧链条过度松动;
- Screwdrop:螺丝等异物掉入链条轨道,造成局部碰撞、阻塞或卡滞。
所有设备均进行同步采集,并将连续信号切分为 5 秒片段。最终数据集共包含 6,669 个多通道样本,每个样本均带有运行速度、负载、噪声状态和故障类型等条件信息。
为了支持可复现的模型比较,论文进一步设计了两类标准化评测任务:
- 无监督故障检测:训练阶段只使用正常样本,并通过跨速度测试评估模型识别未见工况和异常状态的能力;
- 有监督故障分类:在条件级别划分训练集和测试集,完整隔离特定速度及部分故障工况,从而降低相邻片段泄漏导致的虚高结果。
在基准实验中,论文使用统一的逐通道 kNN 框架,对 BEATs、CED、Dasheng、EAT、ECHO 和 FISHER 等预训练音频编码器进行了评估。该设置不额外训练复杂分类器,能够更直接地比较不同编码器的表示质量。实验揭示了音频和振动信号之间明显的任务互补性:
- 在无监督故障检测中,音频信号整体可能具有更强的异常区分能力;
- 振动信号可能更擅长捕捉螺丝掉落等故障产生的瞬态机械冲击;
- 音频信号可能更容易识别链条松动带来的摩擦声与周期性异响;
- 在多数预训练编码器上,融合音频和振动能够获得比单一模态更高的故障分类性能。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。