INTERSPEECH 2026 论文预讲会由中国中文信息学会、CCF语音对话与听觉专委会、深圳市人工智能学会、语音之家发起,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2026 录用论文的作者进行报告交流。
INTERSPEECH 2026 论文预讲会第八期邀请到武汉大学智能声学与语音处理实验室做本次会议的专场分享,欢迎大家观看。
实验室概况
武汉大学智能声学与语音处理实验室Intelligent Acoustics and Speech Processing Lab (IASP-Lab)致力于通过人工智能和声学技术的创新,推动语音交互和声学感知的智能化发展,赋能新一代通信和智能交互应用。
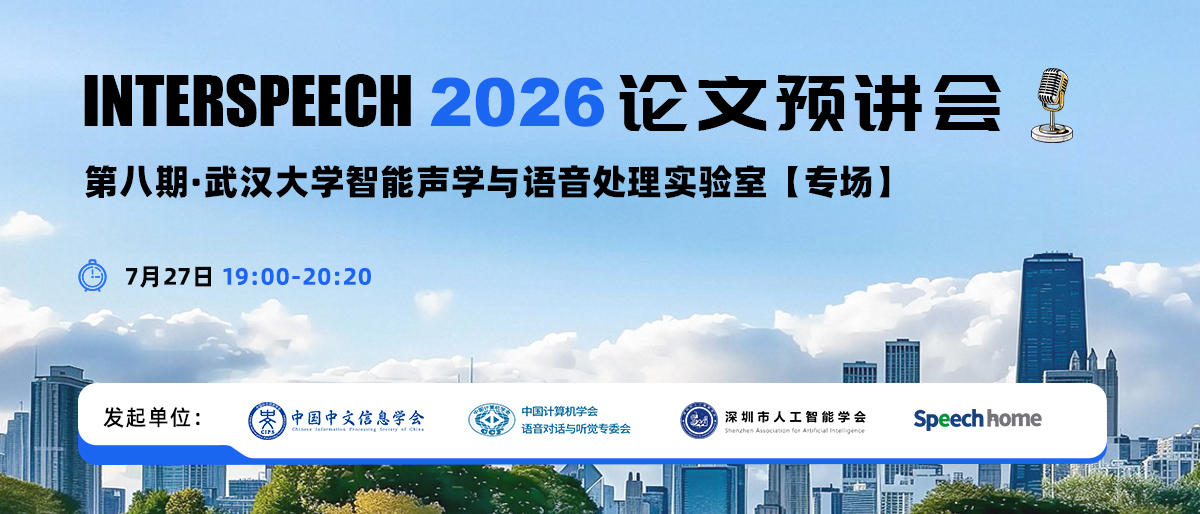
第八期-武汉大学智能声学与语音处理实验室【专场】
时间:7月27日(周一)19:00 ~ 20:20
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
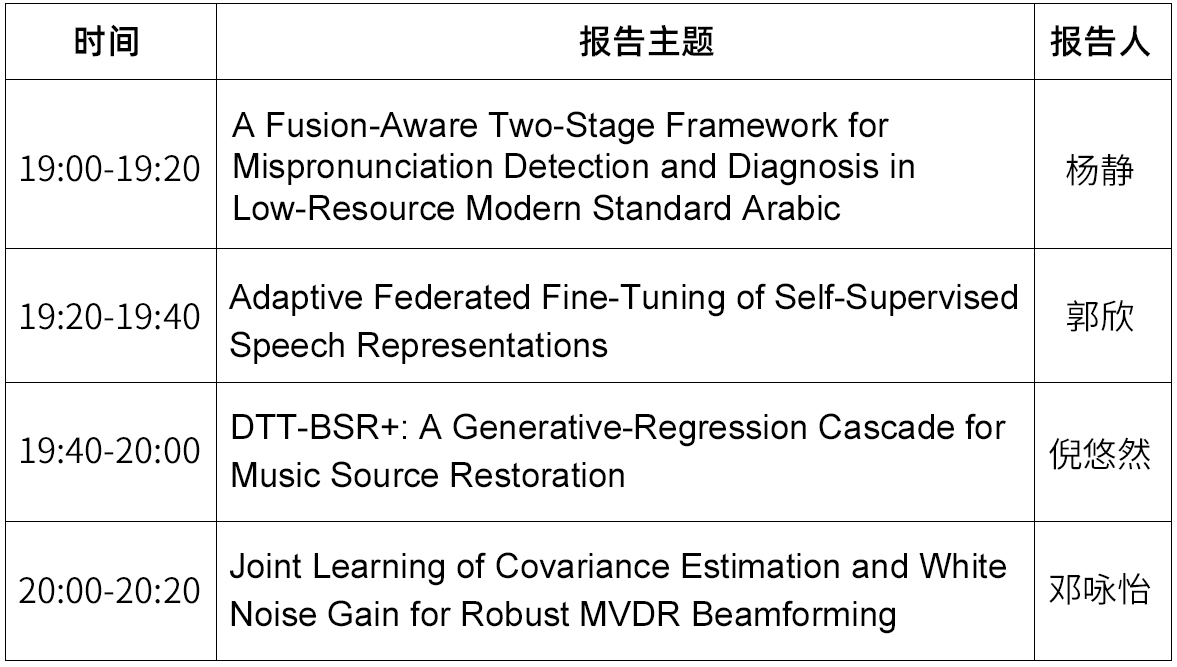
嘉宾&主题
嘉宾简介:杨静,就读于武汉大学电子信息学院,二年级硕士研究生,导师为黄公平教授。主要研究方向为模拟人类偏好的感知评估方法及其在强化学习中的应用,以第一作者身份在ICASSP会议发表论文一篇,并在多项国际挑战赛中取得优异成绩:包括Interspeech 2026 IqraEval.2 阿拉伯语发音评估挑战赛冠军、Biodcase 鸟类计数挑战赛冠军,以及 ICASSP 2026 Cadenza 歌词可懂度预测挑战赛季军。
报告题目:A Fusion-Aware Two-Stage Framework for Mispronunciation Detection and Diagnosis in Low-Resource Modern Standard Arabic
摘要:现代标准阿拉伯语(MSA)的发音错误检测与诊断(MDD)对于计算机辅助发音训练至关重要,但长期受限于数据稀缺以及合成数据与真实数据之间的域差距。针对这一挑战,本文提出了一种两阶段端到端框架。在模型架构上,我们将大规模多语言预训练编码器与因果时序卷积网络(TCN)相结合,利用其局部归纳偏置保留细粒度的声学细节,避免全局上下文对发音错误的过度平滑。在训练策略上,设计了分层两阶段范式:首先利用母语者发音与合成错误数据学习通用的声学映射,随后在少量真实学习者数据上进行自适应微调,从而有效缓解合成与真实数据间的域偏移,并防止模型过拟合。此外,在推理阶段引入多检查点预测融合与 N-gram 语言模型重打分机制,进一步提升了系统在未见数据上的预测稳定性。在 IqraEval.2 挑战赛的 QuranMB.v2 盲测集评估中,该系统取得了 0.7201 的 F1 分数,较官方基线相对提升 63.1%,位列挑战赛榜首。本研究验证了所提方法在低资源场景下的有效性,并为其他数据稀缺语言的发音评估提供了具有可扩展性的参考方案。
论文链接:https://arxiv.org/abs/2606.24086
嘉宾简介:郭欣,就读于武汉大学电子信息学院,四年级本科生,导师为黄公平教授。主要研究方向为声源定位与语音自监督模型的联邦微调,以第一作者身份在 INTERSPEECH 2026 发表论文一篇,并在 BioDCASE 2026 多通道音频对齐挑战赛中获得冠军。
报告题目:Adaptive Federated Fine-Tuning of Self-Supervised Speech Representations
摘要:自监督语音模型在语音识别、关键词识别等任务中表现突出,但在联邦学习场景下进行模型微调时,常面临设备算力差异大、任务复杂度不同、边缘端显存受限等问题。传统全模型联邦微调策略容易导致低资源客户端训练负担过重,并产生明显的掉队者效应。针对这一挑战,本文提出一种基于早期退出机制的自适应联邦微调框架。该方法将静态 SSL 骨干网络转换为弹性多分支架构,并在中间层插入轻量化预测头,使不同客户端能够根据自身硬件约束和任务复杂度动态选择最大训练深度。在局部训练阶段,低资源设备只需执行到预设深度的前向与反向传播,从而降低计算和显存开销;在服务端聚合阶段,模型采用深度感知的层级部分聚合机制,对不同深度的模型更新进行独立加权融合。实验结果表明,该框架在 ASR、关键词识别等五项语音任务中均保持出色性能,相比全模型微调最高可降低 43.27% 的边缘端显存开销,有效提升了异构联邦学习环境下语音模型适配的灵活性与效率。
论文链接:https://arxiv.org/abs/2603.21888
嘉宾简介:倪悠然,就读于武汉大学电子信息学院,三年级本科生,导师为黄公平教授。主要研究方向为语音增强、音源分离和多语种说话人日志。已以第一作者及合作者身份在INTERSPEECH、ICASSP发表论文。在ICASSP 2026MSR Challenge、Biodcase鸟类计数挑战赛等国际挑战赛中获季军、冠军。
报告题目:DTT-BSR+: A Generative-Regression Cascade for Music Source Restoration
摘要:音乐源恢复任务不仅需要从混合音频中分离不同乐器或人声干音,还需要逆向处理压缩、混响、均衡、动态范围控制等非线性制作效果。针对现有方法难以同时保持语义一致性与波形级重建精度的问题,本文提出一种名为DTT-BSR+的两阶段级联音乐源恢复系统。该方法将语义分布拟合与波形级信号重建解耦:第一阶段利用 DTT-BSR 分离器,从退化混合音频中生成符合干净声源先验分布的初步原始声源信号估计;第二阶段采用改进版 Demucs 纯回归网络 Demucs-L,以第一阶段输出为输入,并通过联合时域 L1 损失和多分辨率 STFT 损失进行优化,进一步提升局部波形细节的重建质量。实验结果表明,DTT-BSR+ 在所有八种乐器原始声源信号上的多梅尔信噪比 MMSNR 均优于单阶段 DTT-BSR 基线,并在人声、吉他、合成器、贝斯和鼓五种干音上超过当前先进的 X-LANCE MSR 系统。此外,本文还通过分解 FAD-CLAP 指标,揭示了信号重建精度与语义分布拟合之间可能存在的隐性权衡,为未来面向不同干音类型的音乐源恢复系统设计提供了参考。
论文链接:https://arxiv.org/abs/2606.24127
嘉宾简介:邓咏怡,就读于武汉大学电子信息学院通信工程专业,主要研究方向为麦克风阵列信号处理、鲁棒波束形成与语音增强,已在 INTERSPEECH、ICASSP、IEEE Transactions on Instrumentation and Measurement 等语音与声信号处理领域国际会议及期刊发表或录用论文多篇。主持武汉大学珞珈本科生创新研究基金项目,围绕复杂噪声与混响环境下的麦克风阵列鲁棒波束形成开展研究,项目结题获评优秀。曾获 IEEE Signal Processing Cup 2026 全球冠军、2025年“声华杯”全国声学技术大赛全国冠军,并在多项国际语音与声信号处理挑战赛中取得优异成绩。
报告题目:Joint Learning of Covariance Estimation and White Noise Gain for Robust MVDR Beamforming
摘要:最小方差无失真响应(MVDR)波束形成器凭借较强的噪声抑制能力和对目标信号的无失真保持特性,被广泛应用于多通道语音增强。然而在实际应用中,其性能容易受到麦克风自噪声和阵列失配的影响。现有方法通常依赖固定且人工调节的白噪声增益(WNG)阈值或对角加载,在未知或时变声学条件下往往难以获得最优性能。本文提出一种数据驱动的 MVDR 波束形成框架,利用深度神经网络自适应估计 WNG 约束。该网络联合预测用于协方差矩阵估计的时频噪声掩蔽以及随频率变化的 WNG 阈值,从而实现对鲁棒性与指向性的动态调节。此外,本文将可微分的鲁棒 MVDR 层嵌入所提框架,实现端到端优化。实验结果表明,与传统采用固定 WNG 阈值的 MVDR 方法相比,所提方法能够持续提升语音质量和可懂度。
论文链接:https://arxiv.org/abs/2606.24137
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。