INTERSPEECH 2026 论文预讲会由中国中文信息学会、CCF语音对话与听觉专委会、深圳市人工智能学会、语音之家发起,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2026 录用论文的作者进行报告交流。
INTERSPEECH 2026 论文预讲会第四期邀请到萨里大学视觉语音与信号处理中心做本次会议的专场分享,欢迎大家观看。
实验室概况
萨里大学视觉与语音与信号处理中心(Centre for Vision, Speech and Signal Processing, CVSSP)是一个以机器感知、音视频信号处理和多模态人工智能为核心的研究中心。中心目前由英国皇家工程院院士 Adrian Hilton 教授领衔,在计算机视觉、音频与视频处理、以人为本人工智能等方向具有长期研究积累,并形成了具有国际影响力的音视频机器感知研究团队。
CVSSP 的机器听觉与音频信号处理方向在 Wenwu Wang 教授、Philip Jackson 教授等学者的带领和推动下,围绕语音、音乐、环境声音与声学场景等音频信号开展研究,涉及音频增强、分离、定位、检测、识别、场景理解、空间音频分析以及生成建模等任务。团队关注复杂真实环境下的音频感知、声学建模与智能音频处理问题,研究成果服务于语音通信、沉浸式音频、音视频理解和多模态智能等应用场景。
第四期-萨里大学视觉语音与信号处理中心【专场】
时间:7月10日(周五)19:00 ~ 20:00
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
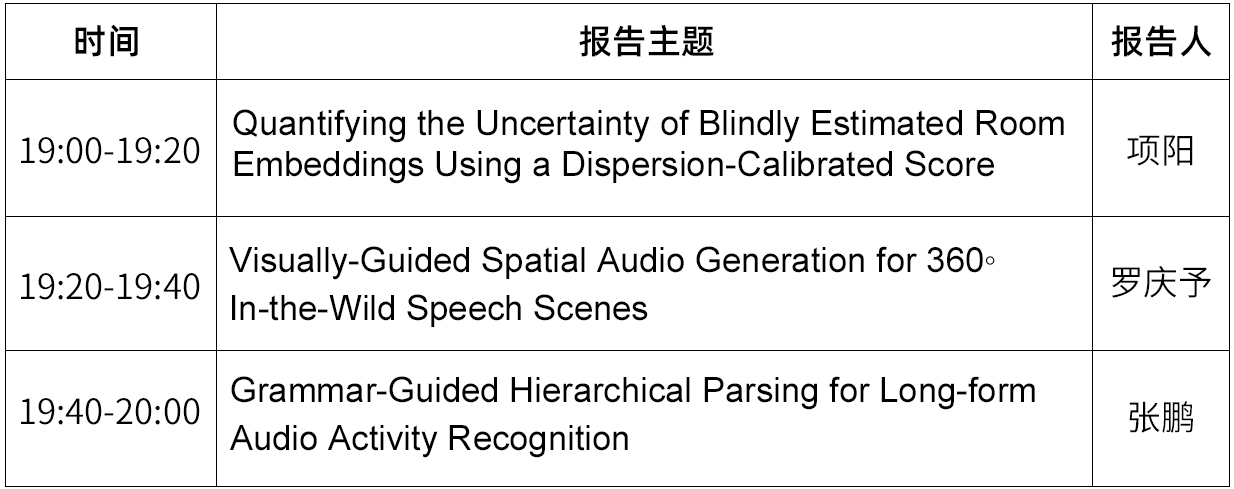
嘉宾&主题
嘉宾简介:项阳,萨里大学视觉语音与信号处理中心2025级博士研究生,师从Philip Jackson 和王文武教授,主要研究方向为盲估计房间冲激响应估计与不确定性建模。
报告题目:Quantifying the Uncertainty of Blindly Estimated Room Embeddings Using a Dispersion-Calibrated Score
摘要:
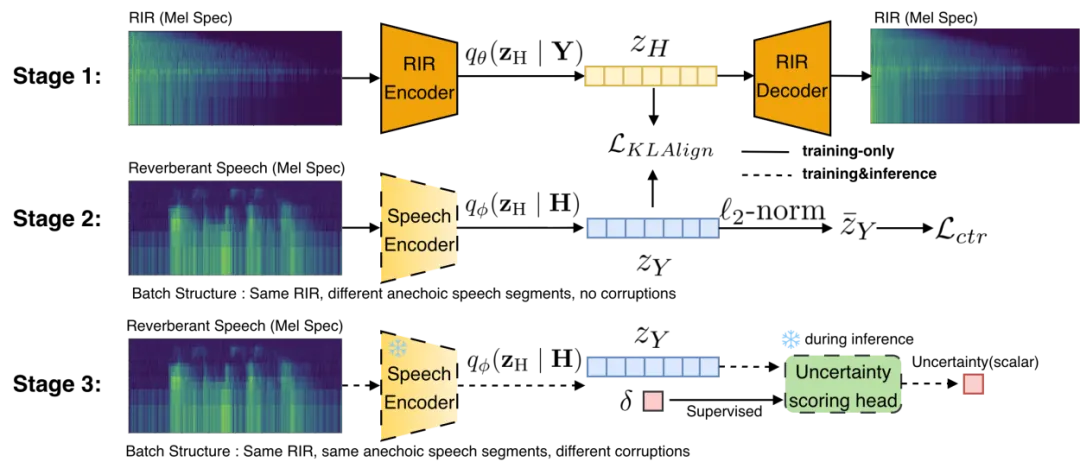
图1:整体训练流程分为三个阶段。第一阶段训练 RIR-VAE,获得 RIR 潜在空间中的后验均值和方差。第二阶段冻结 RIR-VAE,并利用多正样本对比学习和 KL 对齐,使语音嵌入与 RIR 后验空间对齐。第三阶段冻结语音编码器,训练一个标量不确定度预测头,用嵌入离散度作为监督信号。
基于混响语音提取的房间嵌入(room embeddings)往往不可靠:即便说话人、房间及声源-接收器几何布局保持不变,语音内容和录音质量的退化也可能改变嵌入表示,从而降低下游任务的性能。我们提出了一种框架,能够在无需下游任务监督的情况下,从混响语音中学习对语音内容变化具有鲁棒性的房间嵌入,并同时获取表示层面的不确定性评分。该嵌入被锚定于结构化房间脉冲响应(RIR)的潜在空间,并通过基于 Kullback-Leibler (KL) 散度对齐的多视图数据结构进行训练;此外,引入多正样本对比项进一步增强了鲁棒性。我们利用由信号失真引起的嵌入分布离散度来校准轻量级不确定性预测头,并采用基于排序的目标函数对其进行优化。无论是在波形层面还是频谱图层面出现失真,该评分均能与表示的离散度保持一致,从而实现有效的选择性预测,且在推理阶段仅需单段语音输入。
论文链接:https://Yang990913.github.io/Interspeech2026_paper.pdf
嘉宾简介:罗庆予,萨里大学视觉语音与信号处理中心2025级博士研究生,师从Philip Jackson 和王文武教授,研究方向为空间音频生成。
报告题目:Visually-Guided Spatial Audio Generation for 360◦ In-the-Wild Speech Scenes
摘要:
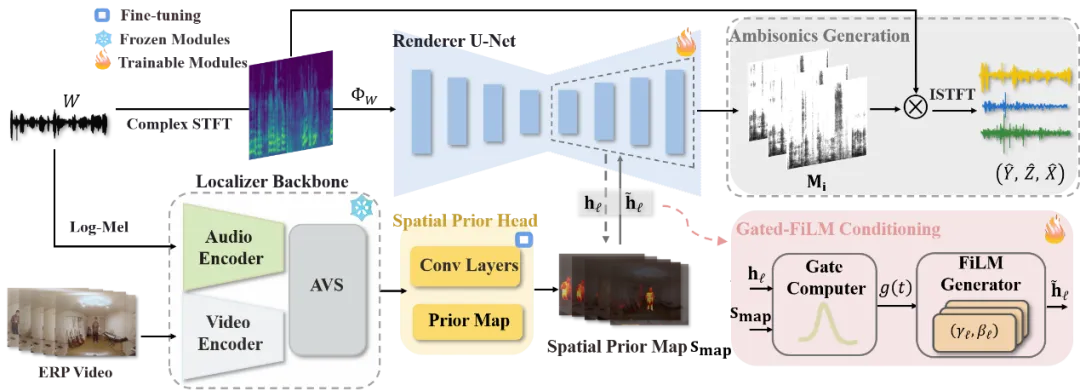
图 2:所提出的 Localizer–Renderer 框架概览,用于视觉引导的 FOA 空间音频重建。
本文研究真实 360° 语音视频中的视觉引导空间音频重建问题。给定时间对齐的 360° 视频和全向音频轨道,模型需要恢复缺失的 FOA 方向分量。为此,我们构建了面向真实语音场景的 YT-SPEECH 视频–FOA 数据集,并提出两阶段 Localizer–Renderer 框架:Localizer 从音视频内容中估计逐帧空间先验,Renderer 则在复数频谱域中重建方向声道。我们还设计了基于置信度的门控机制,以降低不可靠空间线索对生成结果的影响。实验表明,该方法在重建质量、空间准确性和语音感知质量方面均优于消融模型和已有方法。
论文链接:https://spatial-audio-demo.github.io/demos/assets/pdf/Interspeech_2026_luo.pdf
Demo链接:https://spatial-audio-demo.github.io/demos/
嘉宾简介:张鹏,萨里大学视觉语音与信号处理中心2025级博士研究生,师从王文武教授,研究方向为音视联合场景理解。
报告题目:Grammar-Guided Hierarchical Parsing for Long-form Audio Activity Recognition
摘要:
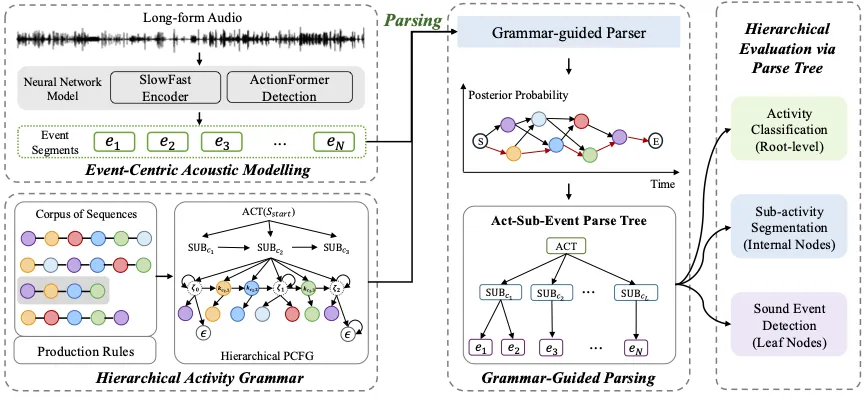
图 1 展示了本文的语法引导层次化解析框架:以声事件检测结果为输入,结合层次活动语法生成 Act–Sub–Event 解析树,实现长时音频的多层级识别与评估。
现实生活中的日常活动通常持续时间较长,在音频记录中表现为连续而复杂的声音过程,其中包含从细粒度声音事件到子活动、再到整体活动的多层级结构。然而,现有音频识别研究多关注短音频片段或孤立事件,难以充分建模长时活动中的时序关系与层级依赖。针对这一问题,本文提出一种语法引导的层次化解析框架。该方法以声音事件检测结果为基础,构建层次活动语法(HAG),通过语法约束和声学证据进行联合推理,生成可解释的 Act–Sub–Event 解析树。该方法无需额外使用子活动或活动级监督信息,初步验证了在长时音频中进行结构化理解的可行性,也为后续长时音频活动识别研究提供了新思路。
论文链接:https://arxiv.org/abs/2606.27965
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。