INTERSPEECH 2026 论文预讲会由中国中文信息学会、CCF语音对话与听觉专委会、深圳市人工智能学会、语音之家发起,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2026 录用论文的作者进行报告交流。
INTERSPEECH 2026 论文预讲会第九期邀请到国防科技大学并行与分布计算全国重点实验室做本次会议的专场分享,欢迎大家观看。
实验室概况
国防科技大学并行与分布计算全国重点实验室是一所以高性能计算、并行体系结构与分布式系统为核心的研究机构。在并行与分布处理体系结构、系统软件、算法与应用、性能评测等方向拥有长期深厚积累,并形成了具有国际影响力的高性能计算与分布式处理研究团队。
实验室积极营造开放合作的学术氛围,与英国、德国、新加坡、香港等国家和地区的高校及研究所建立长期合作关系,并承办APPT、ICCNMC、GCC、SRDS等系列国际学术会议,研究人员频繁赴国内外讲学交流,持续推动并行与分布计算领域的学术前沿发展。在人才培养方面,实验室指导的学生在全国数模竞赛、挑战杯、ACM程序设计竞赛及Altera设计大赛中屡获佳绩,为国家输送了大批高层次创新型人才。
第九期-国防科技大学并行与分布计算全国重点实验室【专场】
时间:8月3日(周一)19:00 ~ 20:15
形式:线上
议程:每位嘉宾分享30分钟(含5分钟QA)
嘉宾&主题
嘉宾简介:徐齐胜,国防科技大学计算机学院2024级计算机科学与技术专业博士研究生,研究方向为音频信号处理、水下声学目标识别及持续学习算法。
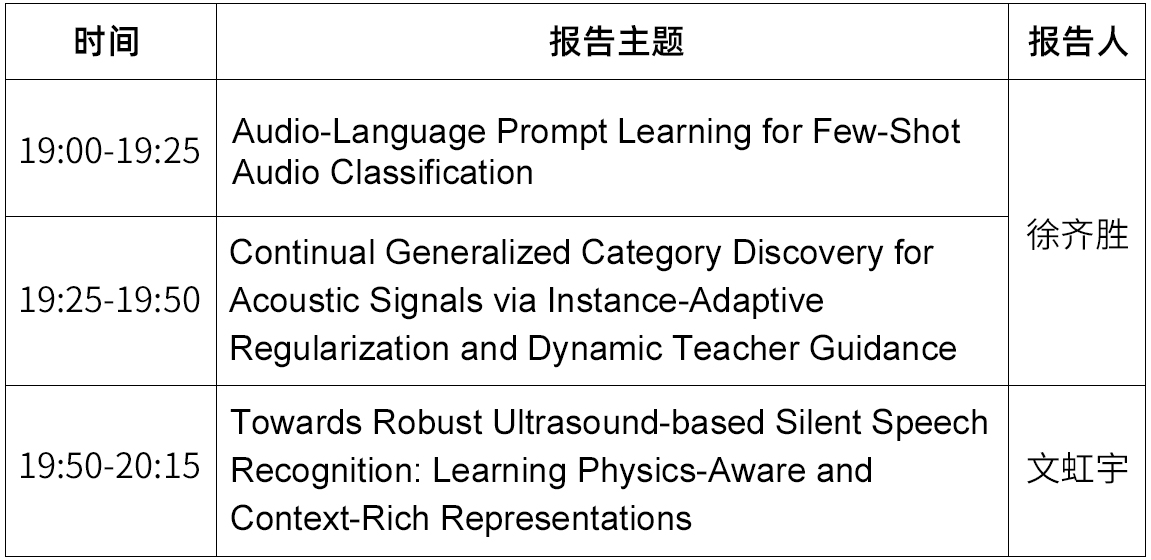
报告题目1:Audio-Language Prompt Learning for Few-Shot Audio Classification
摘要1:音频语言模型(ALMs)在标准音频分类任务中展现出 强大的泛化能力,但其小样本适应性仍受限于以文本为中 心的提示学习方式——这种方式无法充分优化音频编码 器,并难以区分声学特征相似类别之间的细微差异。这种 以文本为主导的适应机制导致不同模态间的优化失衡,并 限制了ALMs在低数据场景下的判别能力。为解决这一局限,我们提出MALP框架:一个多模态提示学习框架,可 同步优化音频专属提示、文本专属提示及共享提示。具体 而言,MALP首先实现模态特定适应以捕捉音频与文本的 互补特性,随后引入共享提示以增强跨模态对齐性同时保 持模态特异性判别能力。在11个基准数据集上的实验表 明,该框架相较于多项强基线模型均取得显著提升:相对 于CoOp平均提升7.21%,相对于CoCoOp提升4.80%,相对 于PALM提升1.77%。消融实验进一步证实了音频特异性 提示与共享提示的互补作用,验证了多模态提示学习在少 样本音频分类任务中的有效性。
报告题目2:Continual Generalized Category Discovery for Acoustic Signals via Instance-Adaptive Regularization and Dynamic Teacher Guidance
摘要2:现实环境中的声学感知系统必须持续适应不断涌现的新声音类别,而人工标注往往不可获取或成本过高。这促使了连续广义类别发现(Continual Generalized Category Discovery, C-GCD)问题的提出,即要求模型在保留对已学习类别识别能力的同时,能够从无标签流式数据中自主发现新声音类别。尽管近年来C-GCD框架在计算机视觉领域已展现出可观成果,但我们发现,直接将其迁移至声学信号会因复杂的时频模式、更强的类别重叠以及被放大的基类偏差而遭受严重的性能退化。为应对上述挑战,我们提出了一种面向音频的新型C-GCD框架,该框架引入实例自适应正则化机制以平衡探索与巩固,并结合GMM驱动的自适应阈值选择策略和EMA更新的动态教师模型,以稳定增量阶段中的伪标签生成。在LibriSpeech和ShipsEar数据集上的实验表明,本方法在新类别发现和旧类别保留两方面均持续优于现有最优基线。特别是在目标数据集ShipsEar上,本方法取得了74.14%的累计平均准确率,较原始Happy框架提升了4.84个百分点,凸显了其在持续开放世界声学学习中的有效性。
嘉宾简介:文虹宇,国防科技大学硕士二年级研究生,研究方向为超声舌成像与无声语音识别。
报告题目:Towards Robust Ultrasound-based Silent Speech Recognition: Learning Physics-Aware and Context-Rich Representations
摘要:无声语音识别(Silent Speech Recognition, SSR)旨在从非声学生物信号中解码语言意图,其中超声舌成像(Ultrasound Tongue Imaging, UTI)作为一种关键的非侵入性模态。然而,成像伪影和复杂的时间依赖关系使得从UTI序列中提取鲁棒特征颇具挑战。为解决这些问题,我们提出了一种用于学习物理感知和丰富上下文表示的框架。具体而言,采用时间聚类策略对序列进行下采样,同时保留关键上下文信息,并辅以物理感知的数据增强,以增强模型对成像扰动的鲁棒性。此外,利用时间掩蔽以及融合3D卷积网络和双向循环层的混合架构,以促进时空表示学习。我们的方法显著优于基线模型,验证了建模物理一致性和结构完整性对于推进基于UTI的鲁棒无声语音识别至关重要。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。