
 语音小管家
近期,微软、中科大、港中大(深圳)、浙大等机构联合发布了一种全新的TTS系统——NaturalSpeech 3,它从语音数据的“表示”和“建模”两个角度出发,利用创新的属性分解扩散模型和属性分解语音神经编码器 FACodec,在零样本情况下合成高质量、具有表现力的语音。Amphion目前已经支持NaturalSpeech 3的核心组件——FACodec,并且已发布其预训练模型。
NaturalSpeech 3 论文链接:https://arxiv.org/pdf/2403.03100.pdf
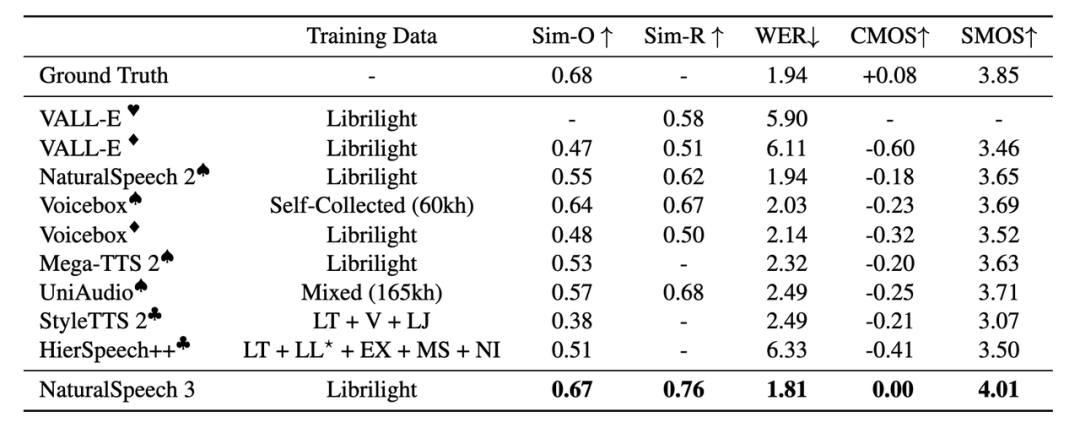
传统TTS系统因训练数据集有限,难以支持高质量的零样本语音合成。而最近的研究通过扩大语料库和模型规模,虽有所进步,但在声音质量、相似性和韵律方面仍未达到理想水平。
NaturalSpeech 3提出一种全新思路,通过将语音分解成不同属性(如内容、韵律、音色和声学细节),并设计了属性分解神经语音编解码器(FACodec)来对不同的子空间进行重构,有效地降低了语音建模难度,从而大大提高了语音合成的质量和自然度。除此之外,NaturalSpeech 3还提出了一种创新的分解扩散模型来生成语音属性,进一步提升了语音生成的质量。
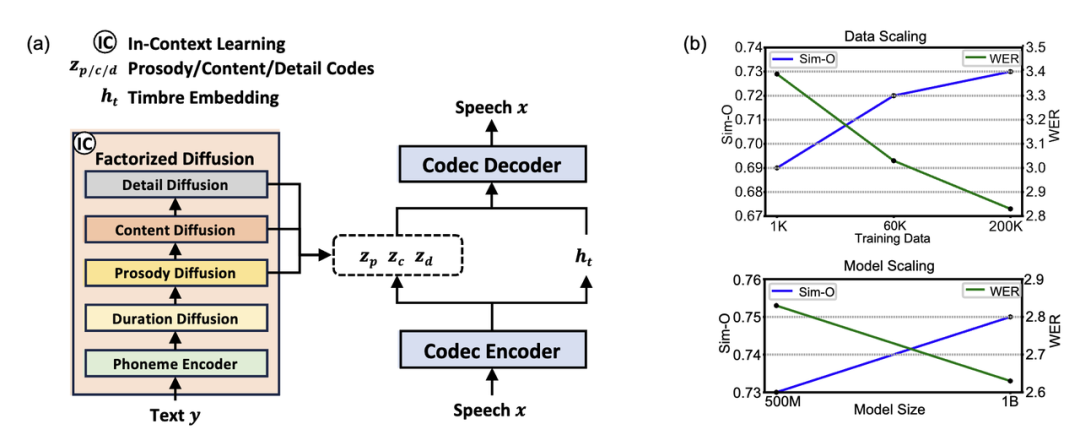
NaturalSpeech 3 系统概览
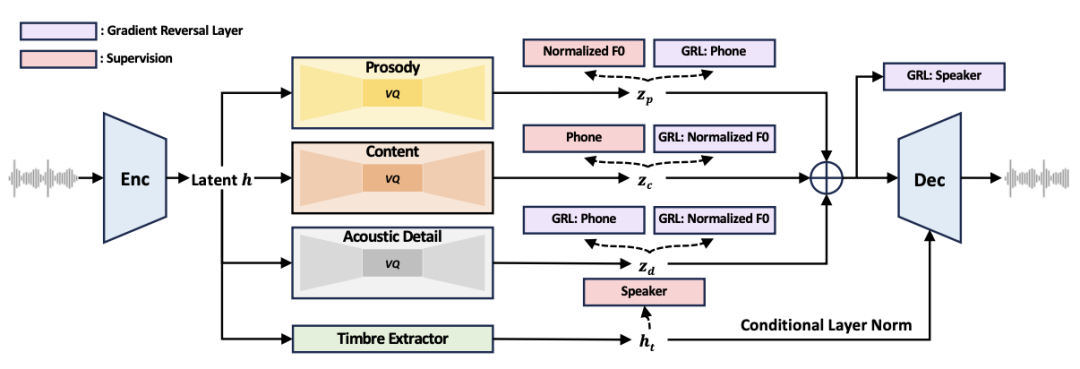
NaturalSpeech 3 核心组件:FACodec
