
 西工大音频语音与语言处理研究组
人类语音传达丰富的情感,不同地区和文化的人们在情感表达上既有相似之处又展现独特风采。多语种情感语音合成(Multilingual Emotional Speech Synthesis)的目标是为每位说话人提供多语言且情感丰富的表达能力,尤其是当原始说话人仅使用单一语言且表达单一情感时。然而,实现多语种情感语音合成面临着外语口音、语音内蕴含的因素交织以及情感表达多样性的挑战。
最近,西工大音频语音与语言处理研究组(ASLP@NPU)与喜马拉雅合作的论文“METTS: Multilingual Emotional Text-to-Speech by Cross-Speaker and Cross-Lingual Emotion Transfer”在语音研究领域顶级期刊IEEE/ACM Transactions on Audio, Speech and Language Processing (TASLP)上发表,该论文针对上述问题开展了深入研究。通过在不同尺度上建模语种无关和语音特定的情感表达,解耦了语音中的不同因素,并引入了基于文本的情感匹配;实现了让单语种说话人能够自然而丰富地表达双语情感。现对该论文进行简要的解读和分享。
论文题目:METTS: Multilingual Emotional Text-to-Speech by Cross-Speaker and Cross-Lingual Emotion Transfer
作者列表:朱新发,雷怡,李涛,张雍茂,周鸿斌,卢恒,谢磊
发表期刊:IEEE/ACM Transactions on Audio, Speech and Language Processing
合作单位:喜马拉雅
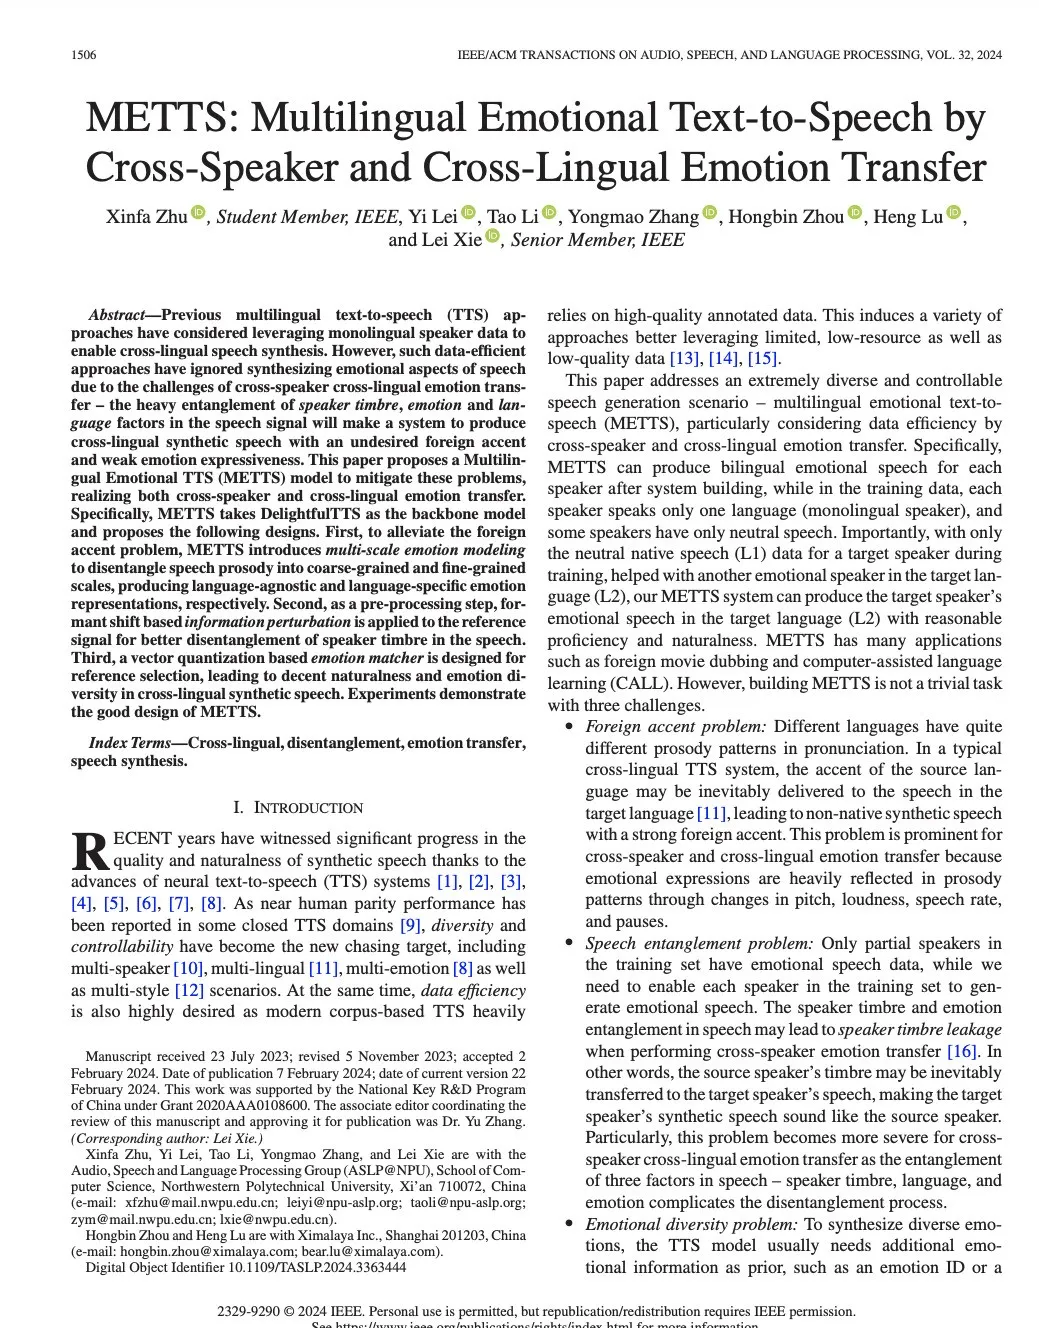
发表论文截图
外语口音问题:不同语种的发音方式千差万别。在跨语种合成语音时,说话人原始语种的发音方式会影响“第二语言”的表达,导致外语口音问题,尤其在情感表达复杂的情境下更为严重。 因素纠缠问题:语音合成中,语种发音特点、说话人音色和情感表达高度耦合。在迁移其他人的情感表达时,很容易同时迁移说话人音色,导致合成语音音色发生变化。 情感表达的多样性与控制问题:在合成情感语音时,通过情感ID或参考语音控制情感是可行的。然而,人类情感表达丰富多样,因此合成多样化的情感语音并灵活控制生成语音的情感是一项巨大的挑战。
为了解决这些挑战,本文在DelightfulTTS [4]架构基础上,实现了一个多语种情感语音合成(METTS)系统。我们引入多尺度的情感建模来解决口音问题,通过粗粒度表征建模语言不可知的情感表达,细粒度表征建模语言特定的情感表达。通过在多尺度的建模中引入信息扰动的方法,成功解耦了说话人音色。最后,我们设计了基于矢量量化的情感匹配器,使其能够基于文本匹配合适的情感表达。相比情感ID,这一匹配器提升了情感表达的多样性;相比参考语音,避免了人工选择的弊端。通过这些设计,METTS实现了从参考语音中合成迁移情感表达(METTS-REF)和根据文本匹配情感表达(METTS-ID)。METTS在中英数据上进行了广泛的实验和评估,结果表明METTS在多语种情感语音合成方面取得了显著成就。
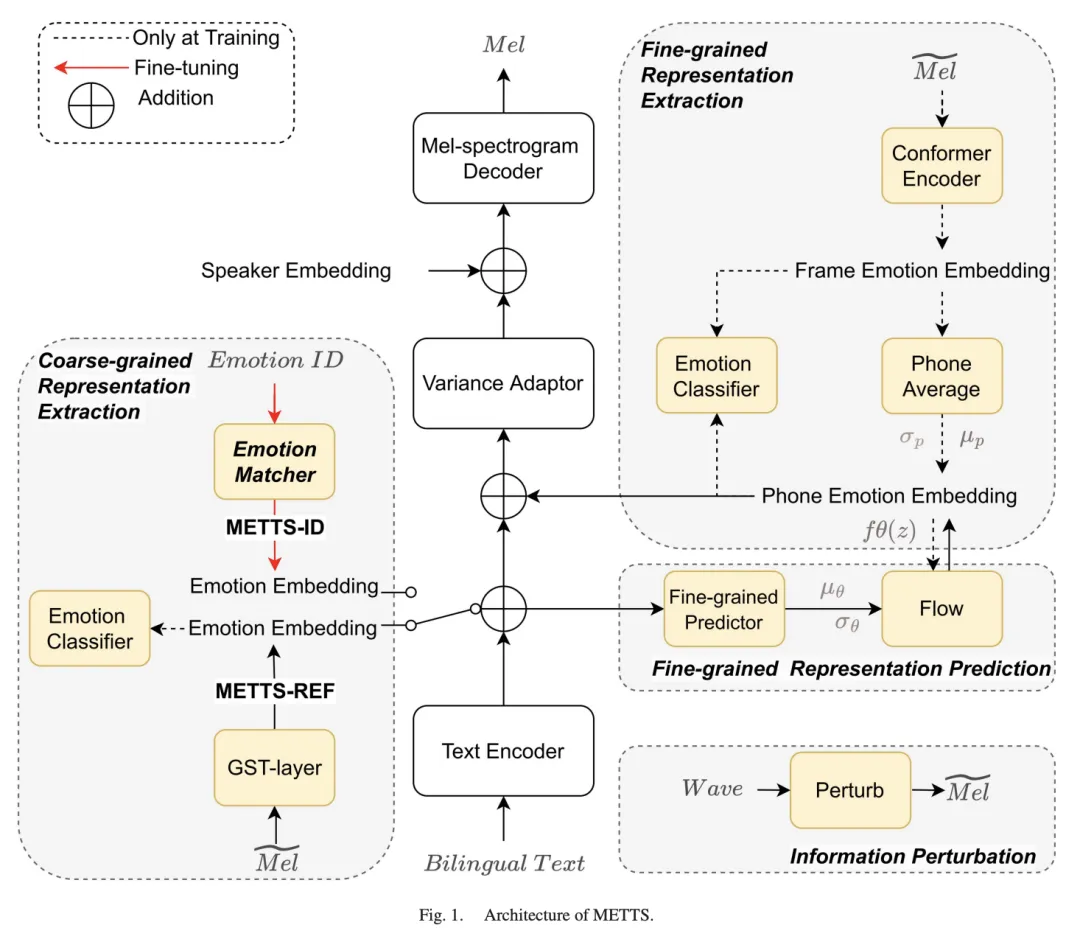
图1 本文模型结构
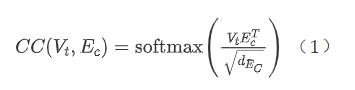
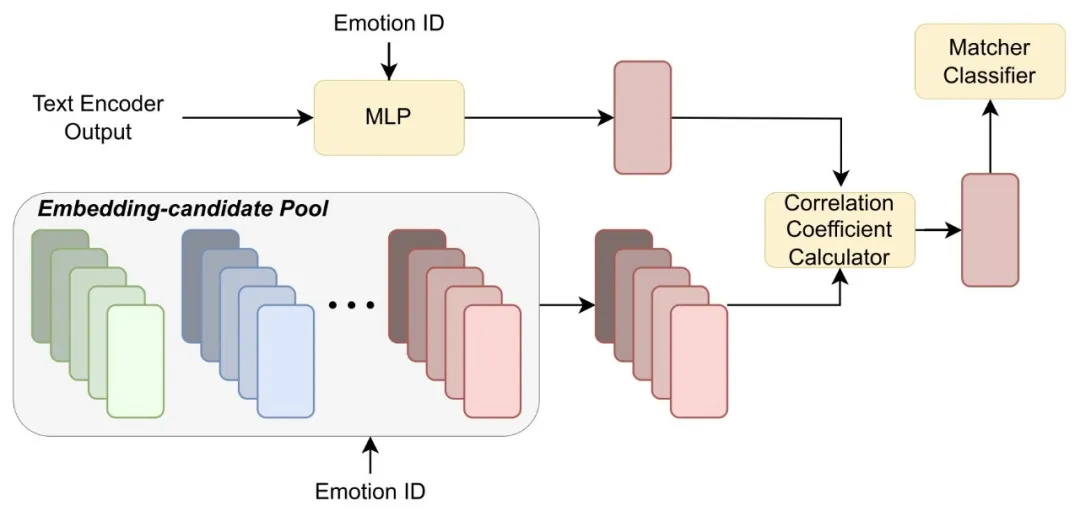
方法流程:METTS系统分为预训练、微调和推理三个部分。
步骤一:预训练。以公式(2)为目标训练METTS-REF。
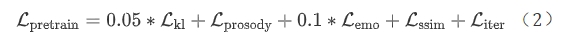
步骤二:微调。提取训练集内音频组粒度表征,矢量量化,以公式(3)为目标微调METTS-ID。
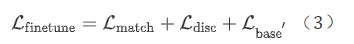
实验数据:1)中文数据集,共有两位说话人,七种情感表达,总计时长约21小时。2)英文数据集,共有两位说话人,只有中性的情感表达,总计时长约20小时。数据具体分布如表1所示。
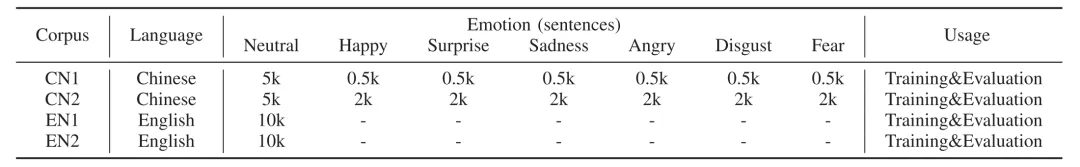
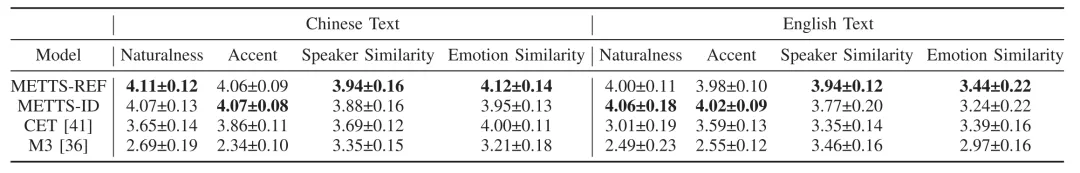
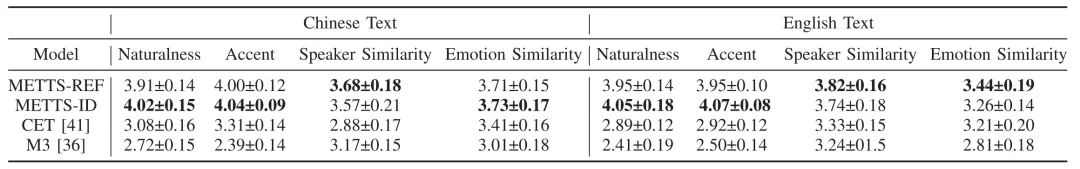
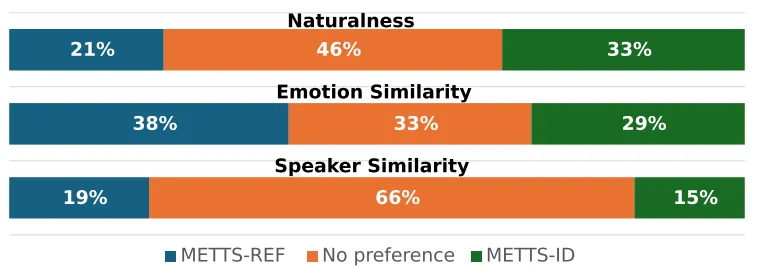
图3 METTS-REF与METTS-ID的偏好测试
客观测试:客观测试包含两个方面——字/词错误率和说话人余弦相似度。表4与表5的结果可以看出,提出的METTS系列取得了最高的说话人余弦相似度。在字错误率上CET取得了最佳的结果,显示其中文情感迁移的强大能力,然而其在英文上取得了较差的结果。相比之下,METTS取得了更平衡的表现;这说明其合成的语音清晰可懂。
表4 中文说话人字错误率、说话人余弦相似度客观测试结果(MOS)
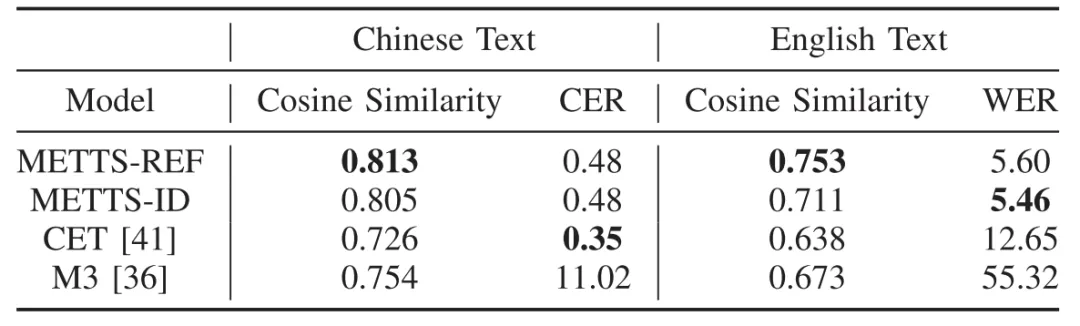
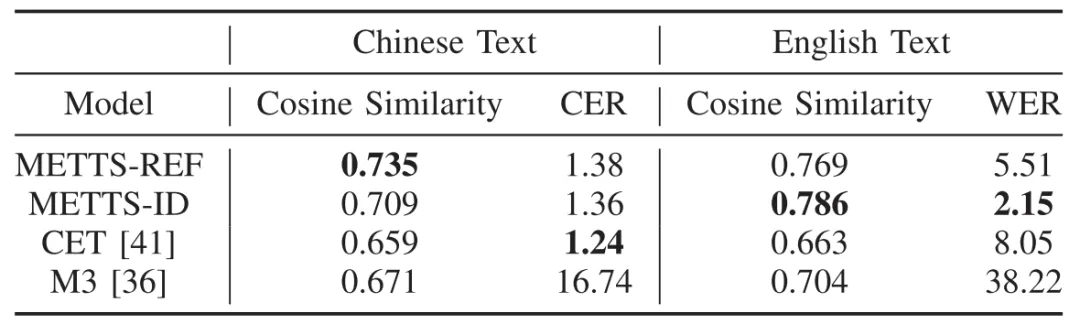
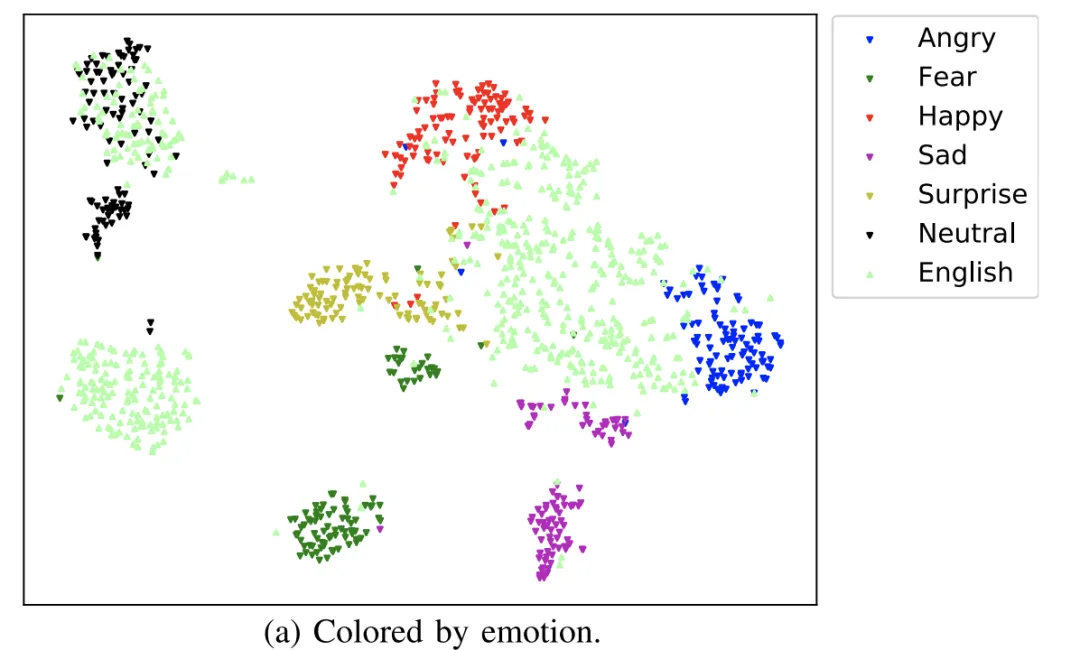
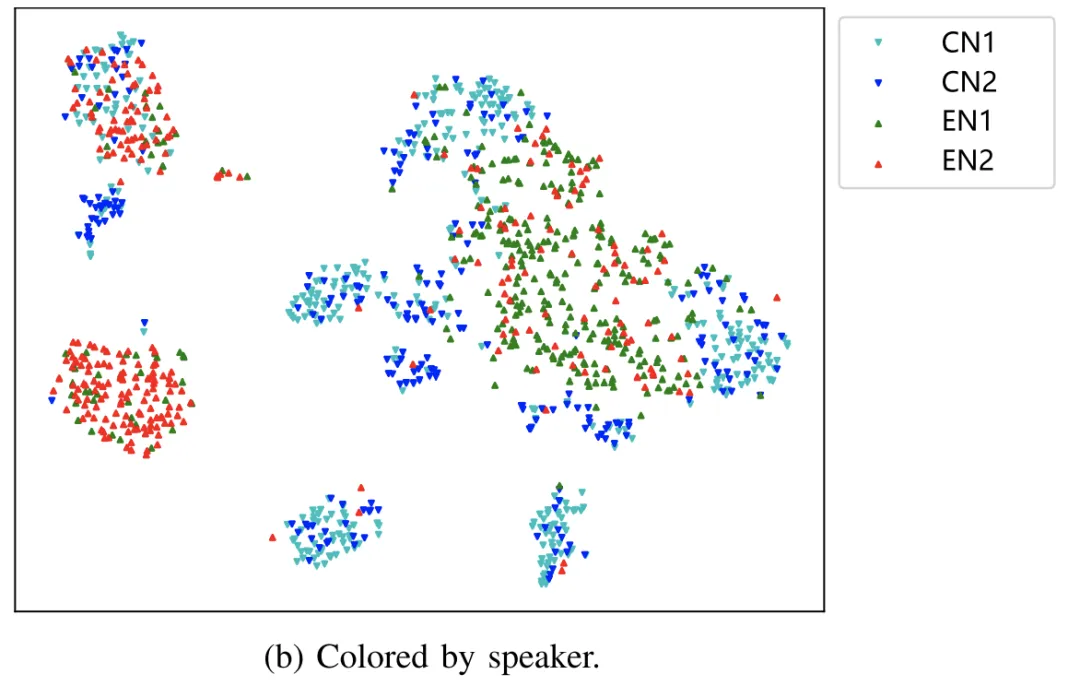
表6 METTS-REF消融实验结果(中文说话人)
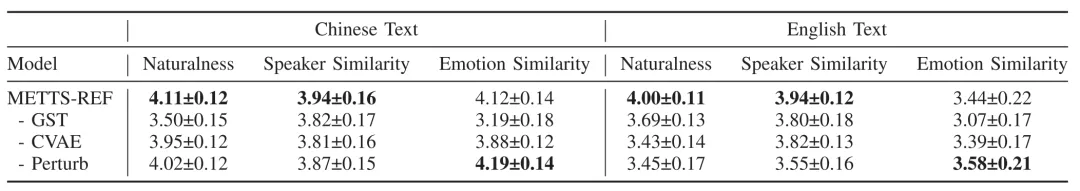
表7 METTS-REF消融实验结果(英文说话人)
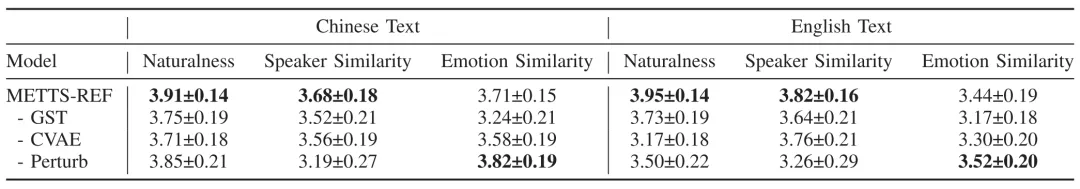
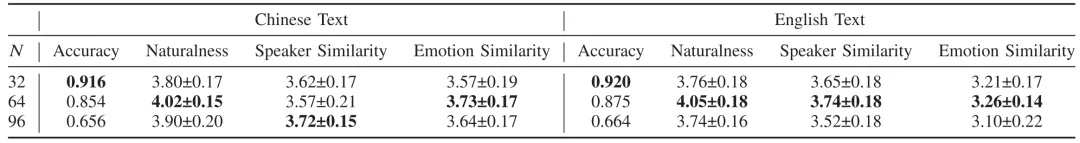
表8 METTS-ID消融实验结果(中文说话人)
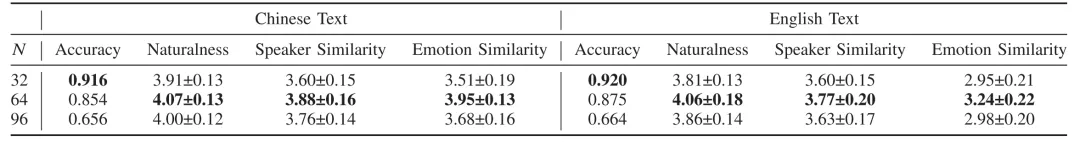
表9 METTS-ID消融实验结果(英文说话人)
[1] Y. Lei, S. Yang, X. Wang, and L. Xie, “MsEmoTTs: Multi-scale emotion transfer, prediction, and control for emotional speech synthesis,” IEEE/ACM Trans. Audio, Speech, Lang. Process., vol. 30, pp. 853–864, 2022.
[2] Y. Ren, X. Tan, T. Qin, Z. Zhao, and T. Liu, “Revisiting over-smoothness in text to speech,” in Proc. 60th Annu. Meeting Assoc. Comput. Linguistics, 2022, pp. 8197–8213.
[3] D. Min, D. B. Lee, E. Yang, and S. J. Hwang, “Meta-style speech: Multispeaker adaptive text-to-speech generation,” in Proc. 38th Int. Conf. Mach. Learn., 2021, pp. 7748–7759.
[4] Y. Liu et al., “DelightfulTTs: The Microsoft speech synthesis system for blizzard challenge 2021,” 2021, arXiv:2110.12612.
[5] Y. Wang et al., “Style tokens: Unsupervised style modeling, control and transfer in end-to-end speech synthesis,” in Proc. 35th Int. Conf. Mach. Learn., 2018, pp. 5167–5176.
[6] X. Zhu, Y. Lei, K. Song, Y. Zhang, T. Li, and L. Xie, “Multi-speaker expressive speech synthesis via multiple factors decoupling,” in IEEE International Conference on Acoustics, Speech and Signal Processing ICASSP 2023, Rhodes Island, Greece, June 4-10, 2023. IEEE, 2023, pp. 1–5.
[7] P. Wu et al., “Cross-speaker emotion transfer based on speaker condition layer normalization and semi-supervised training in text-to-speech,” 2021, arXiv:2110.04153.
[8] Z. Shang, Z. Huang, H. Zhang, P. Zhang, and Y. Yan, “Incorporating cross speaker style transfer for multi-language text-to-speech,” in Proc. 22nd Annu. Conf. Int. Speech Commun. Assoc., 2021, pp. 1619–1623.
