
 语音小管家
近日,INTERSPEECH 2024会议发出了审稿结果通知,语音及语言信息处理国家工程研究中心智能语音信息处理团队共17篇论文被会议接收,论文方向涵盖语音识别、语音合成、语音编码、话者识别、语音增强、情感识别、声音事件检测等,各接收论文简介见后文。
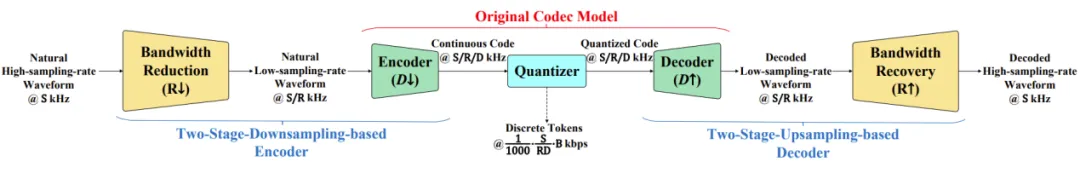
A Low-Bitrate Neural Audio Codec Framework with Bandwidth Reduction and Recovery for High-Sampling-Rate Waveforms
论文作者:艾杨,鲁叶欣,江晓航,盛峥彦,郑瑞晨,凌震华
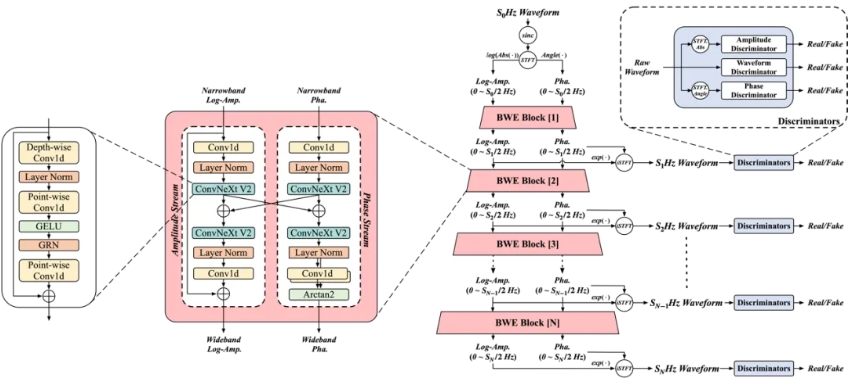
Multi-Stage Speech Bandwidth Extension with Flexible Sampling Rate Control
论文作者:鲁叶欣,艾杨,盛峥彦,凌震华
论文单位:中国科学技术大学
论文简介:
BiVocoder: A Bidirectional Neural Vocoder Integrating Feature Extractionand Waveform Generation
论文作者:杜荟鹏,鲁叶欣,艾杨,凌震华
论文单位:中国科学技术大学
论文简介:
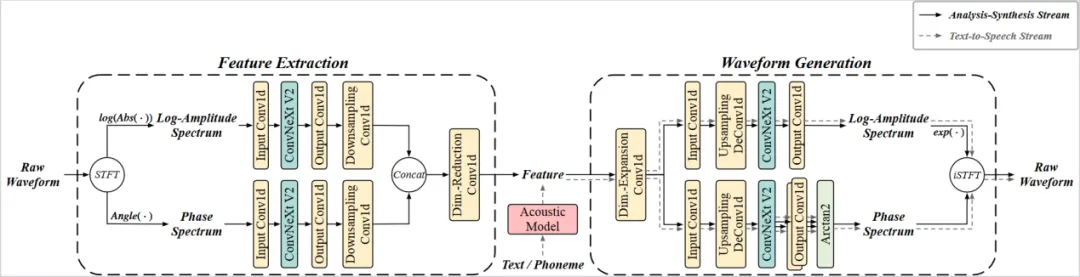
本文提出了一种新颖的双向神经网络声码器,名为BiVocoder,能够在短时傅里叶变换(STFT)域内进行特征提取和波形生成。对于特征提取,BiVocoder将从短时傅里叶变换提取的幅度和相位谱作为输入,通过卷积神经网络将它们转换为长帧移和低维特征。由此提取的特征适用于声学模型的直接预测,支持其在文本转语音(TTS)任务中的应用。对于波形生成,BiVocoder通过对称网络从特征中恢复幅度和相位谱,然后进行逆短时傅里叶变换以重构语音波形。实验结果表明,我们提出的BiVocoder在综合考虑合成语音质量和推断速度方面,比一些基线声码器表现更好。
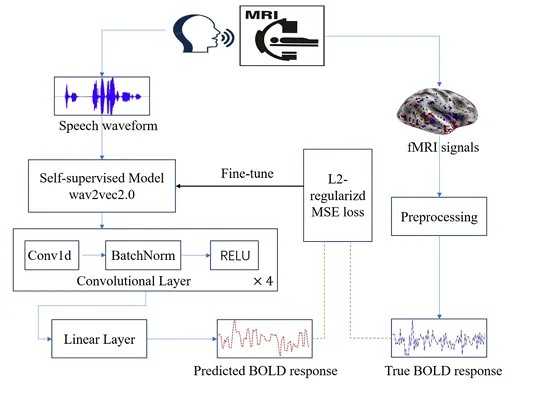
Refining Self-Supervised Learnt Speech Representation using Brain Activations
论文作者:李恒宇,梅康迪,刘朝辞,艾杨,陈丽萍,张结,凌震华
论文单位:中国科学技术大学
论文简介:
Asynchronous Voice Anonymization Using Adversarial Perturbation On Speaker Embedding
论文作者:王瑞,陈丽萍,Kong Aik Lee,凌震华
论文单位:中国科学技术大学,香港理工大学
论文简介:
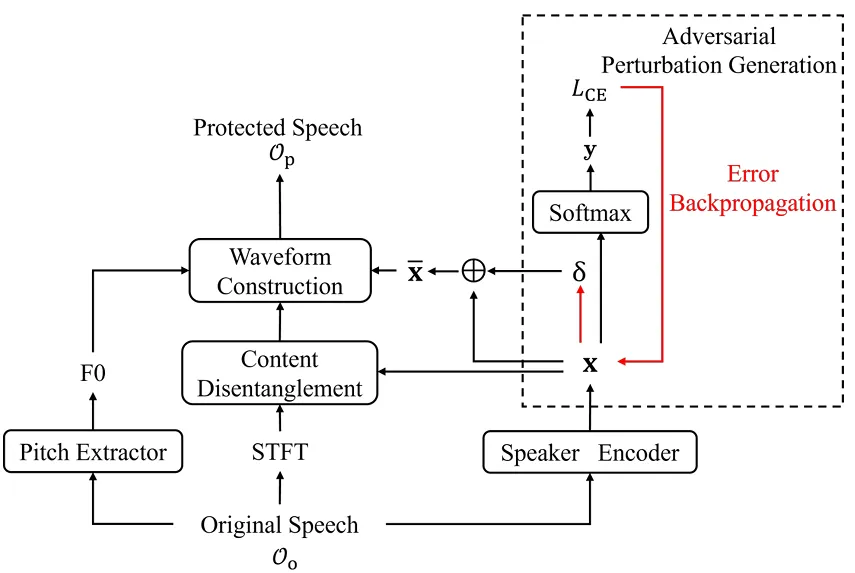
Demo语音:https://voiceprivacy.github.io/asynchronous-voice-anonymization/
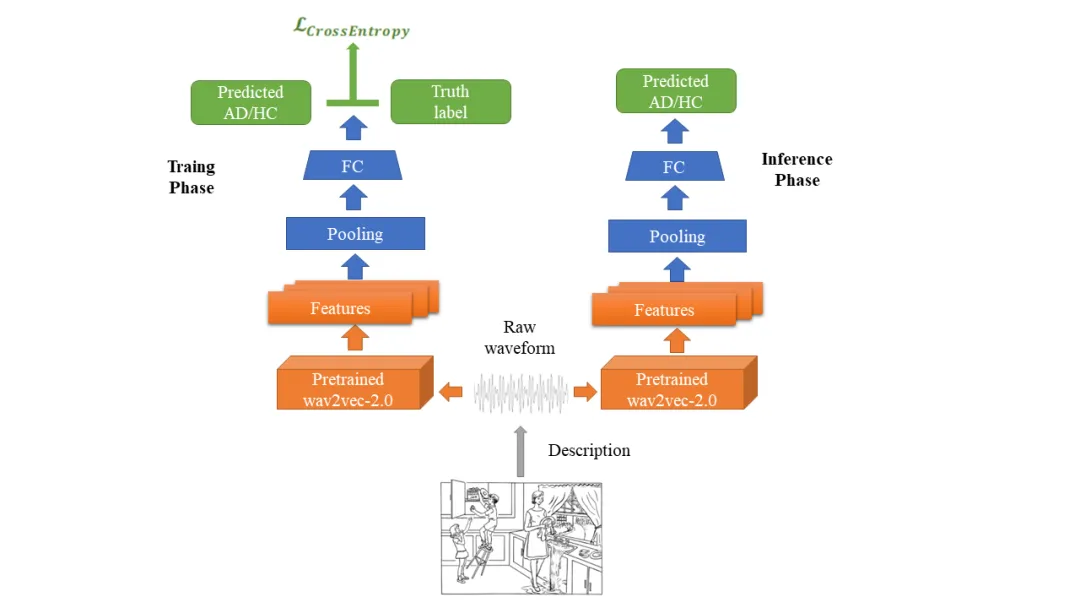
Clever Hans Effect Found in Automatic Detection of Alzheimer's Disease through Speech
MAT-SED: AMasked Audio Transformer with Masked-Reconstruction Based Pre-training for Sound Event Detection
论文作者:蔡鹏飞、宋彦、李康、宋皓宇、Ian McLoughlin
论文单位:中国科学技术大学、澳大利亚国立大学、新加坡理工大学
论文简介:
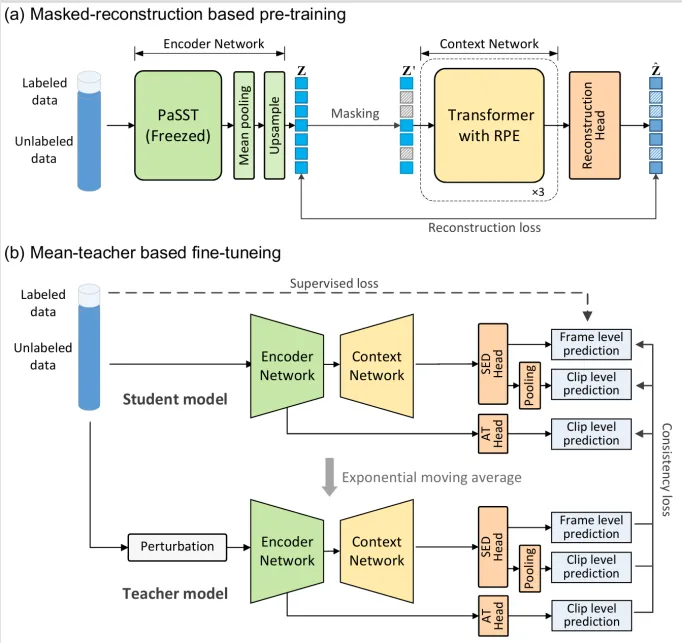
在近期的DCASE竞赛中,利用预训练Transformer编码器的声音事件检测方法展现了优异的性能。然而,受限于标注数据的匮乏,现有方法在建模声音事件的时间依赖性时,仍需依赖基于RNN的结构。在本研究中,我们提出了一种完全基于Transformer的声音事件检测模型MAT-SED。MAT-SED使用基于掩码重建的任务进行预训练。具体来说,我们采用使用相对位置编码的Transformer架构代替传统的RNN结构,构成上下文网络,并通过自监督的掩码重建任务进行预训练。之后,编码器和上下文网络以半监督的方式进行联合微调。此外,我们还使用了一种全局-局部特征融合策略,以增强模型对声音事件的定位能力。在DCASE2023任务4的评估中,MAT-SED取得了0.587/0.896的PSDS1/PSDS2,超过了当前最先进的声音事件检测系统。
An Effective Local Prototypical Mapping Network for Speech Emotion Recognition
论文作者:奚宇轩、宋彦、戴礼荣、宋皓宇、Ian McLoughlin
论文单位:中国科学技术大学、澳大利亚国立大学、新加坡理工大学
论文简介:
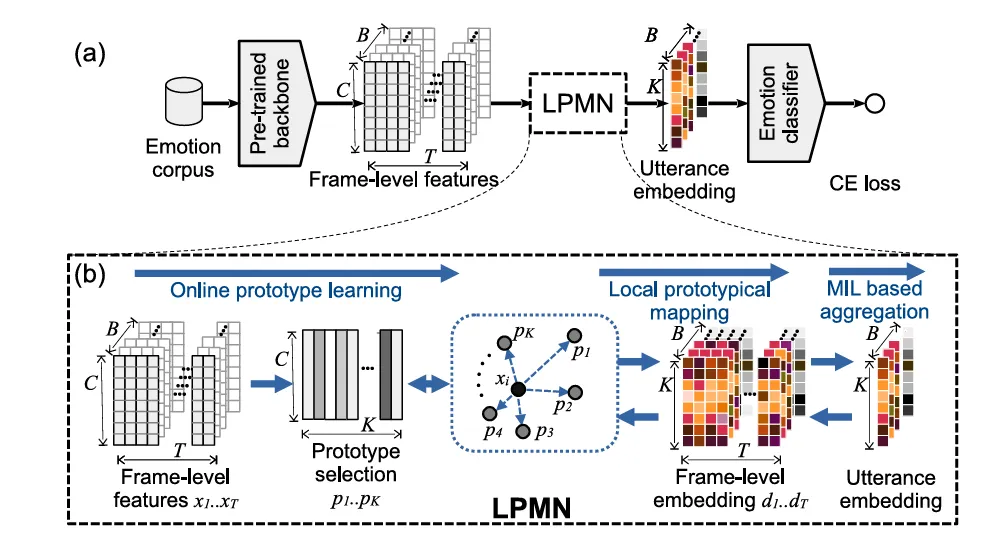
现有语音情感识别系统通常使用段级的情感标注进行优化。但情感作为一种复杂的心理学现象,其表达往往不局限于单一的、静态的段级标签。本文提出了一种局部原型映射网络(local prototypical mapping network,LPMN)来对帧级情感方差进行建模,更好地利用一句话中局部信息的差异来提高性能。具体而言,我们首先构建一个原型集合,用以表征从预训练的特征提取器得到的复杂帧级特征。接着基于多实例学习算法,通过特征和原型之间的相似性度量来选择最能代表情感的映射,从而获得段级嵌入,进行情感分类。原型可以使用量化损失和情感分类损失进行联合优化。最后,我们在后处理阶段进一步提出了一种原型选择方案,选择与情感相关的原型,以减少不相关因素造成的干扰。我们在IEMOCAP和MER2023数据集上进行了实验,证明了LPMN的有效性。
DB-PMAE: Dual-Branch Prototypical Masked AutoEncoder with locality for domain robust speaker verification
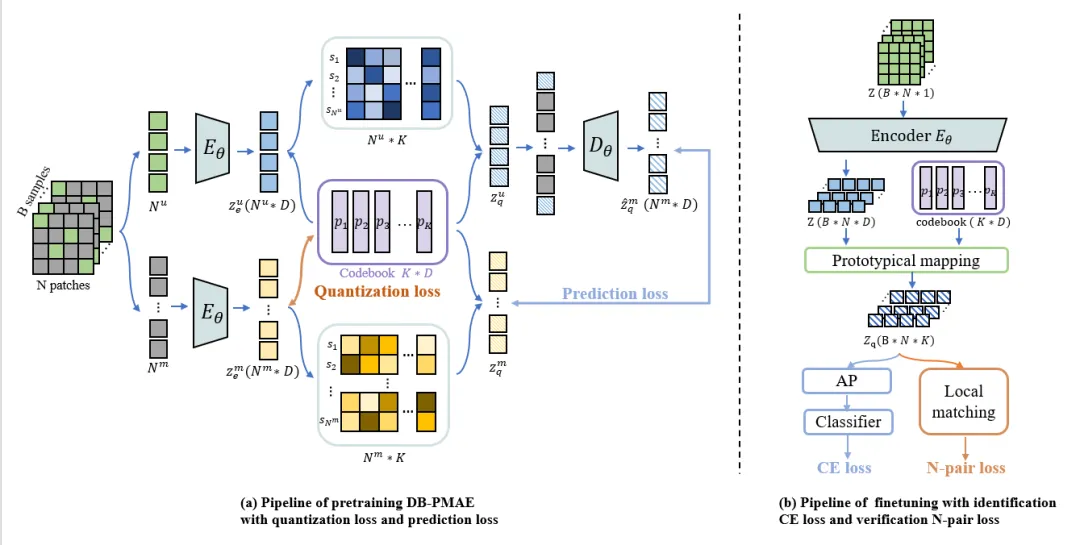
现有的说话人验证(SV)系统主要由深度嵌入网络预训练的说话人识别(SID)前端和提供相似性度量的微调网络后端组成。尽管它们取得了成功,但由于领域不匹配问题,现有系统的性能可能会显著降低。在本文中,我们提出了一种新的基于双支路原型掩码自编码器(Dual-Branch Prototypical Masked AutoEncoder,DB-PMAE)的SRE框架。具体来说,我们对于带有孪生编码器的教师和学生分支进行预训练,共同学习patch级别的特征和原型。我们利用多任务学习框架对SID和SV任务进行微调,其中通过寻找局部对应来度量相似性,以提高域鲁棒性。我们在CNCeleb语料库上的实验结果证明了DB-PMAE的优越性。
Adapter Learning from Pre-trained Model for Robust Spoof Speech Detection
论文作者:吴皓晨,郭武,彭圣宇,李珠海,张结
论文单位:中国科学技术大学
论文简介:
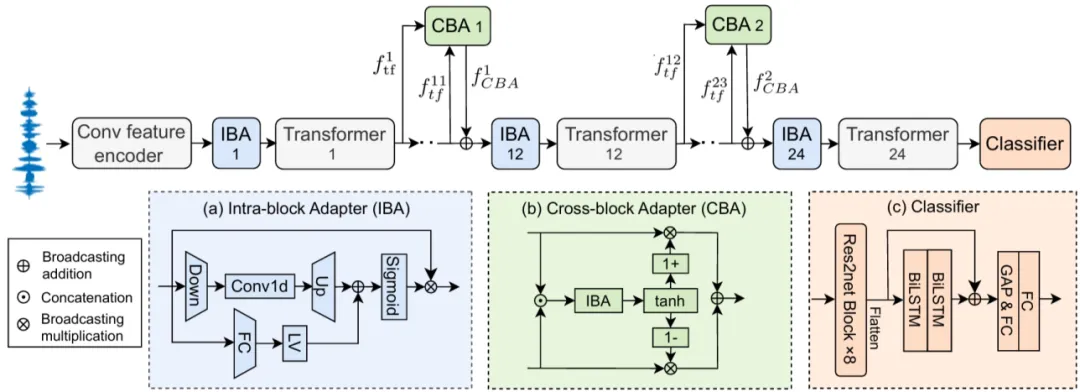
伪造语音检测模型可以通过使用大规模预训练模型(如Wav2vec2或WavLM)作为前端来提升模型的泛化能力。然而,由于训练数据有限,对预训练模型进行微调除了计算量大之外,还容易出现过拟合和灾难性遗忘的问题。在本文中,我们提出了一种基于预训练模型的新型适配器学习框架,用于稳健的伪造语音检测。我们考虑了两种适配器情况,即添加到wav2vec2主干网络的块内适配器和跨块适配器。训练过程中冻结wav2vec2主干网络,仅更新适配器的参数。通过提出的适配器学习方法,只需增加少量参数,就能有效学习用于伪造语音检测的任务相关信息。在三个基准数据集上的结果验证了该系统优于基线系统和现有的SOTA系统。
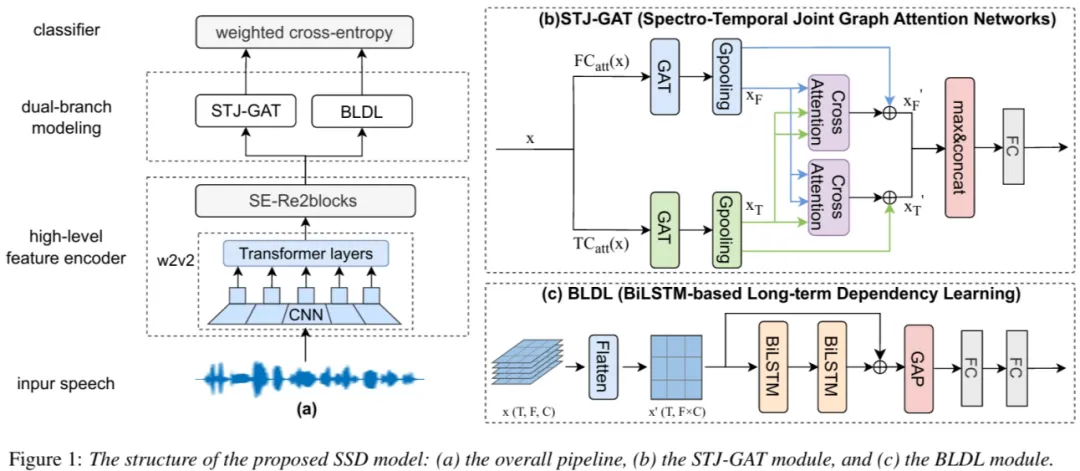
Spoofing Speech Detection by Modeling Local Spectro-Temporal and Long-term Dependency
论文作者:吴皓晨,郭武,张震涛,赵文婷,彭圣宇,张结
论文单位:中国科学技术大学,中国招商银行
论文简介:
Enhancing Voice Wake-Up for Dysarthria: Mandarin Dysarthria Speech Corpus Release and Customized System Design
论文作者:高铭,陈航,杜俊,徐昕,郭泓霄,卜辉,杨建兴,李明,李锦辉
论文单位:中国科学技术大学,希尔贝壳,北京理工大学,昆山杜克大学,佐治亚理工学院
论文简介:
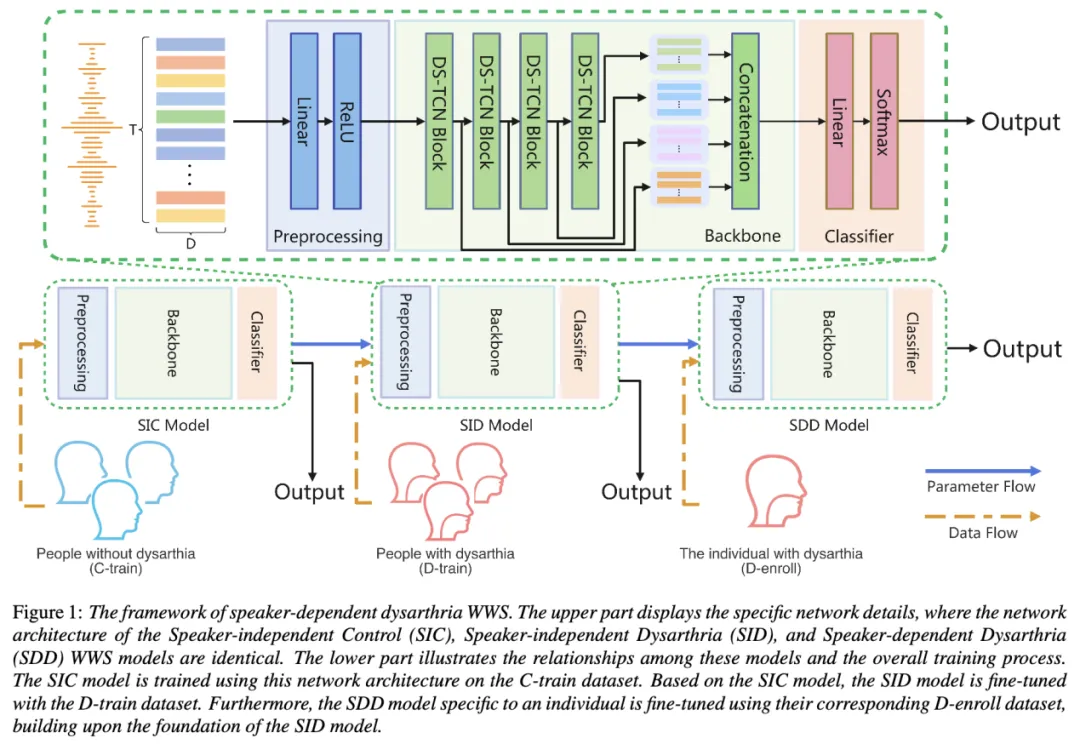
数据集地址:https://www.aishelltech.com/AISHELL_6B(即将开源)
Lightweight Transducer Based on Frame-Level Criterion
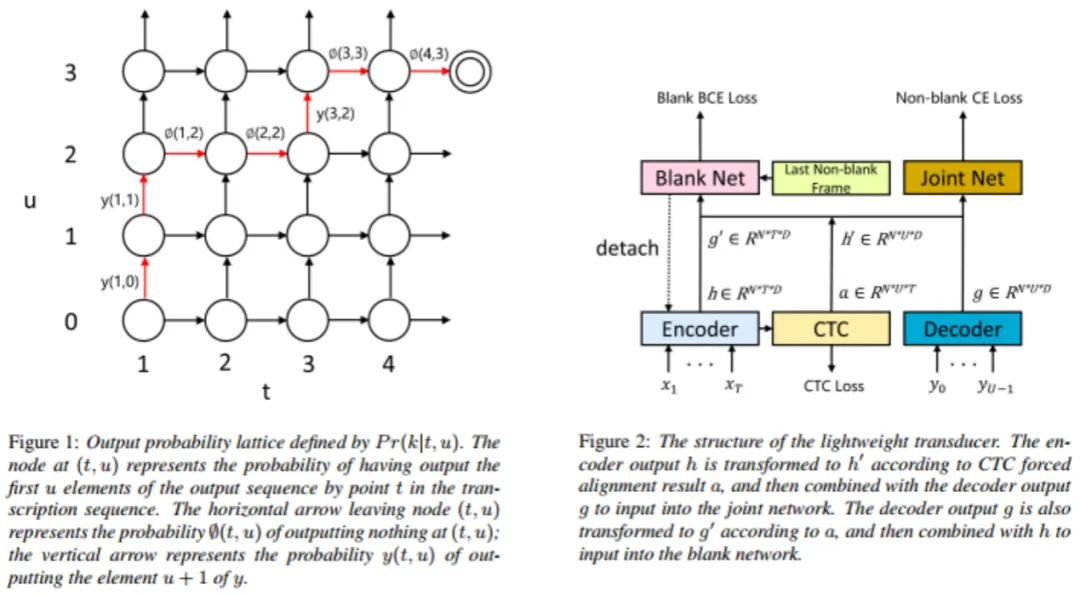
如图1所示,传统的基于序列级对其准则训练的Transducer模型由于需要生成较大的概率矩阵,需要占用较大的内存。本文提出了一种基于帧级对齐准则的轻量级Transducer模型,如图2所示,利用CTC强制对齐算法的结果确定每一帧的标签,然后将编码器输出与解码器输出的相应时刻的输出进行合并,而不需要像传统模型那样将编码器输出的每个元素与解码器输出的每个元素相加,从而大大降低内存和计算量。针对标签空白过多导致分类不平衡的问题,我们将空白和非空白概率解耦,并将空白分类器的梯度截断到主网络,使得轻量级Transducer能够达到与传统Transducer相近的效果,同时利用更丰富的信息来预测空白概率,从而取得优于传统Transducer的效果。
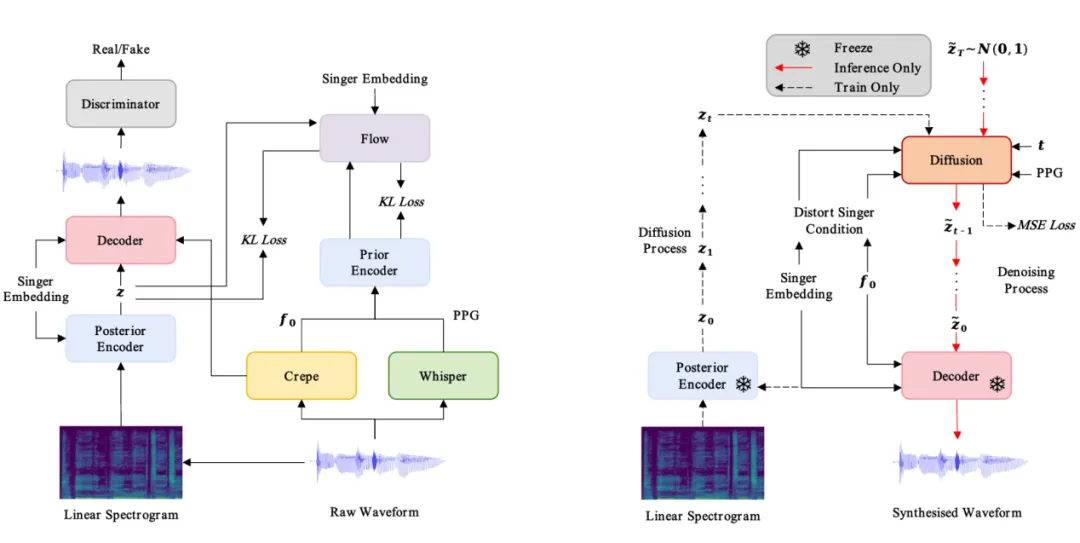
LDM-SVC: Latent Diffusion Model Based Zero-Shot Any-to-Any Singing Voice Conversion with Singer Guidance
论文作者:陈世豪,顾宇,张结,李娜,陈日林,陈丽萍,戴礼荣
论文单位:中国科学技术大学,腾讯
论文简介:
Fine-tune Pre-Trained Models with Multi-Level Feature Fusion for Speaker Verification
论文作者:彭圣宇,郭武,吴皓晨,李作亮,张结
论文单位:中国科学技术大学
论文简介:
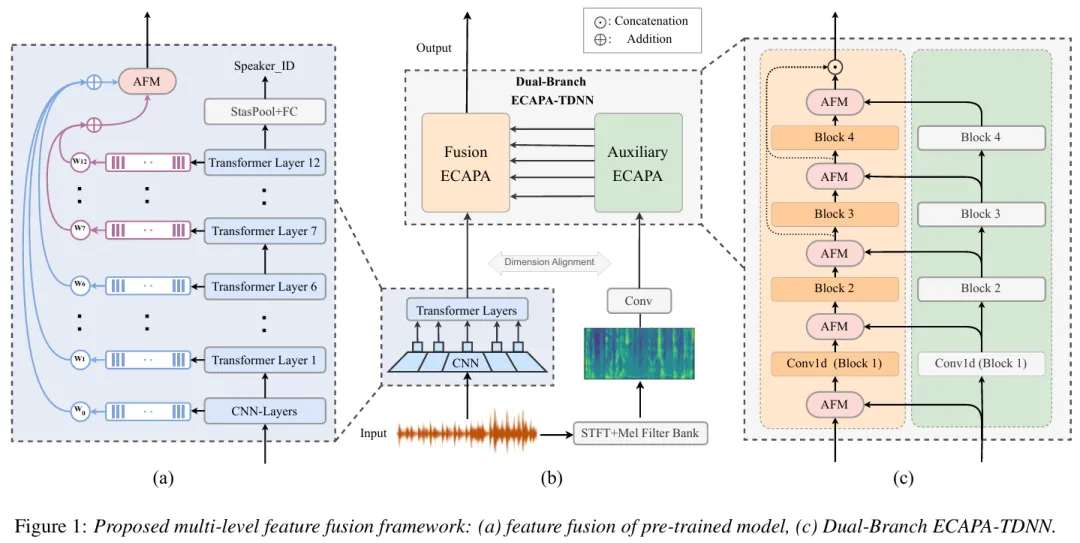
本文使用多层次特征来微调预训练模型进行说话人验证任务,多层次特征包括来自预训练模型的特征和传统手工特征。本文所提出的框架包含一个预训练模型作为前端和一个双分支ECAPA-TDNN (DBE) 后端。对于前端,我们提出了一个基于注意的融合模块(AFM)来合并预训练模型的深层特征和浅层特征。为了提高性能,我们在预训练模型的最后一层之后添加了辅助说话人损失。对于DBE后端,DBE的每个分支都采用来自预训练模型和FBank特征的融合后特征作为输入。AFM进一步用于合并双分支特征以提供互补信息。VoxCeleb数据集上的实验结果证实了我们提出的方法在不同预训练模型上的有效性。
Contrastive Learning and Inter-Speaker Distribution Alignment Based Unsupervised Domain Adaptation for Robust Speaker Verification
论文作者:李作亮,郭武,古斌,彭圣宇,张结
论文单位:中国科学技术大学
论文简介:
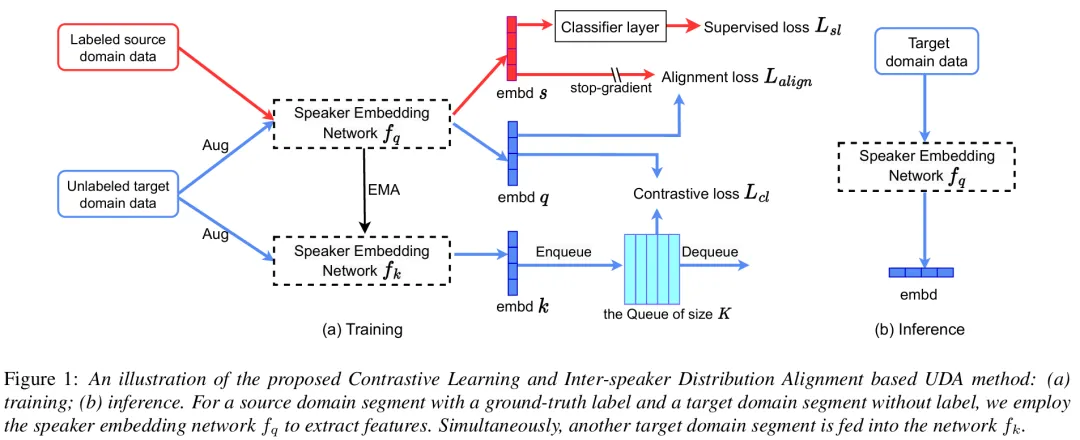
无监督域自适应(Unsupervised Domain Adaptation,UDA)可以解决说话人确认在实际应用中源域和目标域之间的不匹配问题。在本文中,我们提出了一种UDA方法,通过自监督方法利用目标域数据。首先,我们使用动量对比学习来有效利用目标域中的潜在说话人标签,同时增强说话人内部的紧凑性和说话人之间的可分离性。其次,我们改进了说话人之间的特征分布对齐损失,确保源域统计量的稳定性并减轻目标域假负对的影响。这两种方法进一步与源域中的传统监督学习相结合。以Voxceleb2作为源域,CN-Celeb1作为目标域的实验结果证明了我们提出的方法的有效性。
Boosting the Transferability of Adversarial Examples with Gradient-Aligned Ensemble Attack for Speaker Recognition
在针对说话人识别系统的黑盒攻击中,如果对抗样本能够一致地欺骗替代模型的集合,他们就能针对未知的受害者系统表现出更好的可迁移性。在这项工作中,我们提出了一种梯度对齐的集成攻击(Gradient-Aligned Ensemble Attack,GAEA)方法,该方法找到一组替代模型的最优梯度方向,以更新对抗样本。具体来说,我们首先通过随机掩蔽输入声学特征的部分区域来计算每个替代模型的过拟合缓和梯度。然后,我们根据每个替代模型的梯度与其他模型梯度的一致性,得到每个替代模型的梯度权重。最终的更新梯度由所有替代模型的梯度加权和计算得出。在VoxCeleb数据集上的实验结果验证了所提出的方法在说话人辨认和说话人确认任务中的有效性。
