语音小管家
此次INTERSPEECH2024专题导读论文仍在持续征集中,欢迎踊跃投稿,投稿方式请参见文末指南。
1 | |
2 | |
3 | |
4 | |
5 | |
6 | |
7 | |
8 |
1. Retrieval Augmented Generation in Prompt-based Text-to-Speech Synthesis with Context-Aware Contrastive Language-Audio Pretraining
【论文作者】薛锦隆,邓雅月,高迎明,李雅
【论文单位】北京邮电大学
【作者邮箱】{jinlong xue, yayue.deng, yingming.gao, yli01}@bupt.edu.cn
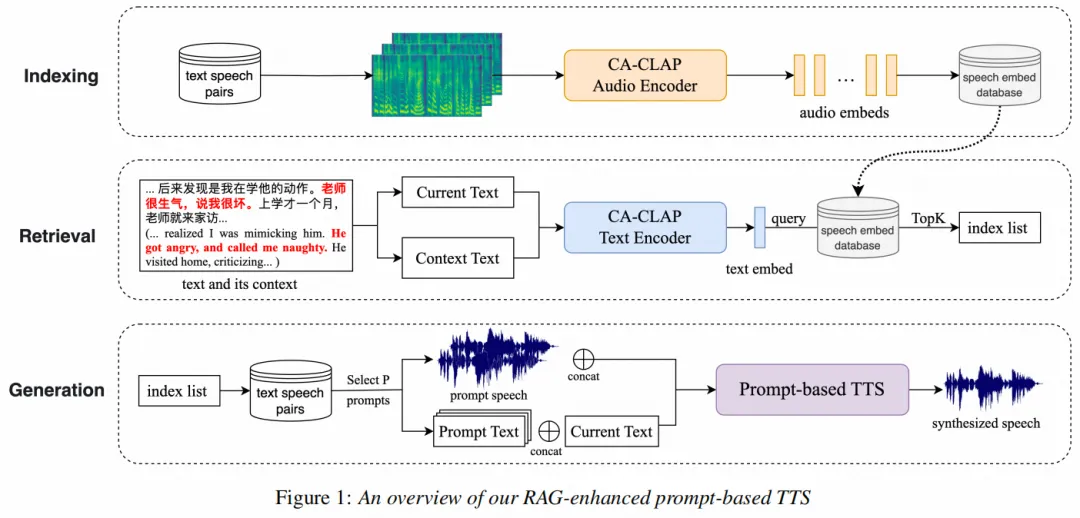
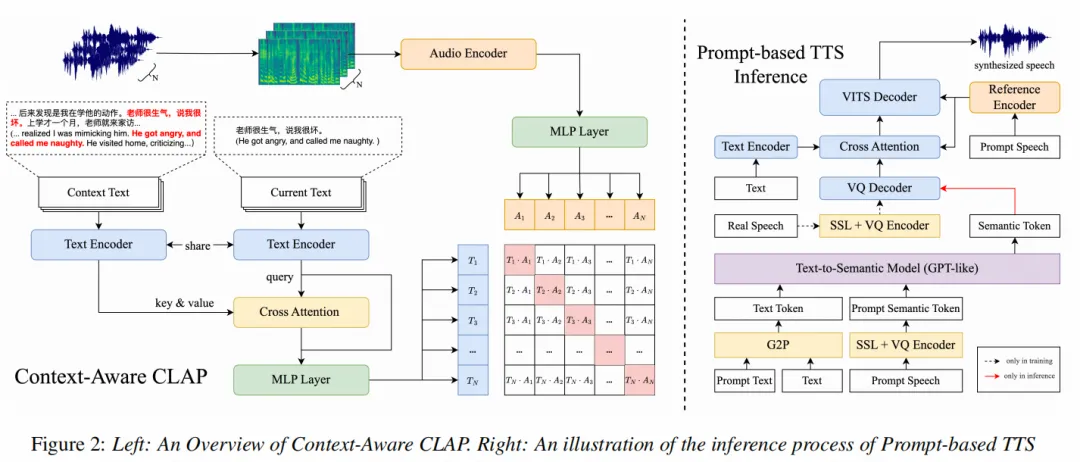
【论文亮点】最近的基于提示的文本到语音模型能够通过仅一小段语音提示来克隆未见过的说话者,利用强大的上下文能力模仿语音提示的风格、韵律和情感。然而,当前的基于提示的TTS模型通常是手动或简单地随机选择语音提示,因此我们将检索增强生成(RAG)方法与基于提示的TTS相结合,并提出了一个上下文感知对比语言-音频预训练(CA-CLAP)模型来提取上下文感知、与风格相关的特征。
【论文简介】最近基于提示的文本到语音模型可以仅使用一段短语音提示来克隆一个未见过的说话者。它们利用强大的上下文能力来模仿语音提示,包括说话者的风格、韵律和情感。因此,选择语音提示对生成的语音有很大的影响,类似于大语言模型中提示的重要性。然而,当前基于提示的TTS模型是手动选择语音提示或简单地随机选择。因此,在本文中,我们将来自LLMs的检索增强生成(RAG)适应到基于提示的TTS中。与传统的RAG方法不同,我们还在检索过程中额外考虑了上下文信息,并提出了一个上下文感知对比语言-音频预训练(CA-CLAP)模型来提取上下文感知、与风格相关的特征。客观和主观评估表明,我们提出的RAG方法优于基线,我们的CA-CLAP比仅文本检索方法取得了更好的结果。
【论文链接】https://arxiv.org/abs/2406.03714
【Demo】https://happylittlecat2333.github.io/interspeech2024-RAG/
【论文作者】薛锦隆,邓雅月,韩易辰,高迎明,李雅
【论文单位】北京邮电大学
【作者邮箱】{jinlong xue, yayue.deng, adelacvgaoiro, yingming.gao, yli01}@bupt.edu.cn
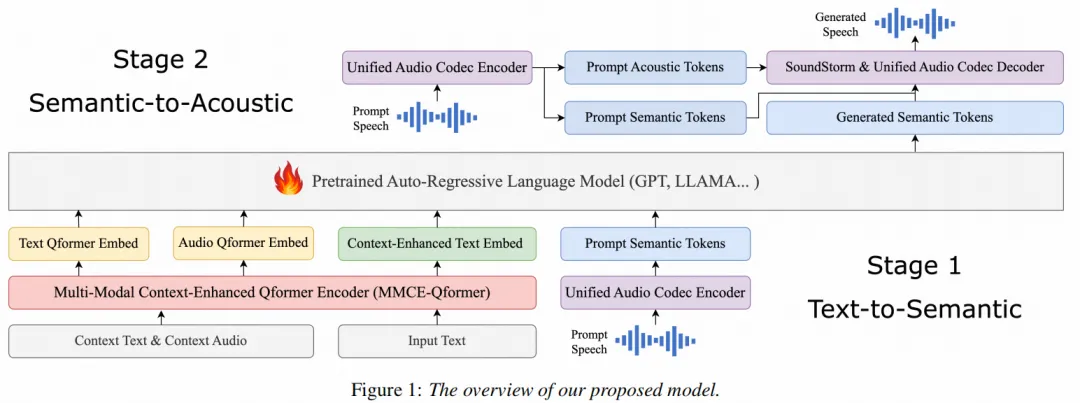
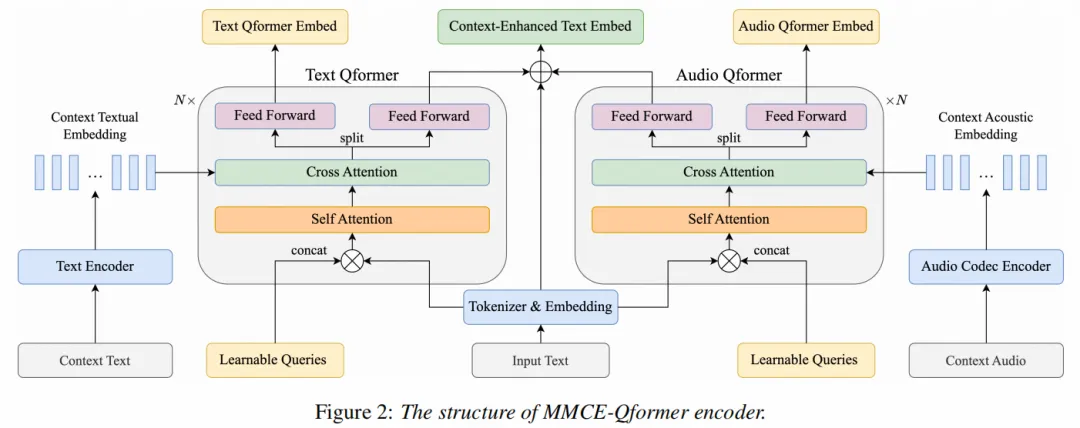
【论文亮点】大语言模型和音频编解码器的进展推动了零样本文本到语音技术的发展,但它们无法利用长上下文信息。我们提出一种新型语音合成模型,利用多模态上下文增强的Qformer(MMCE-Qformer)来使用长上下文内容,并且预训练LLM来预测语义标记,再用SoundStorm生成声学标记,提高了音频质量和说话者相似度。
【论文简介】 最近在大语言模型和音频编解码器方面的进步极大地推动了零样本文本到语音技术的发展。它们能够仅通过三秒未见说话者的语音作为声学提示来合成个性化语音。然而,它们仅支持短语音提示,并且不能利用在有声读物和对话语音合成场景中所需的更长的上下文信息。在本文中,我们介绍了一种基于新型音频编解码器的语音合成模型,该模型通过多种增强来适应上下文特征。受到Qformer成功案例的启发,我们提出了一种多模态上下文增强的Qformer(MMCE-Qformer),以利用额外的多模态上下文信息。此外,我们适应了一个预训练的LLM,利用其理解能力来预测语义标记,并使用SoundStorm生成声学标记,从而提高音频质量和说话者相似度。广泛的客观和主观评估表明,我们提出的方法在各种上下文TTS场景中优于基线。
【论文链接】https://arxiv.org/abs/2406.03706
【Demo】https://happylittlecat2333.github.io/interspeech2024/
【论文作者】白炳松,王风平,高迎明,李雅
【论文单位】北京邮电大学
【作者邮箱】bingsongbai@bupt.edu.cn,wfp@bupt.edu.cn,
yingming.gao@bupt.edu.cn,yli01@bupt.edu.cn
【论文亮点】SPA-SVC模型在歌唱语音转换(SVC)领域取得了显著进展,特别是在处理源域和目标域音高范围差异较大的情况时,能够显著缓解生成哑音的问题,并能提升一般场景下的歌声合成质量。
【论文简介】SPA-SVC模型是一种针对歌唱语音转换(SVC)任务的自监督音高增强方法。该方法的核心在于通过循环音高变换训练策略,解决了当源歌唱语音的音高范围显著超出目标域时,合成歌声中常常产生哑音的问题。SPA-SVC模型创新性地引入了循环音高变换训练策略和结构相似性指标(SSIM)损失,以增强SVC模型的性能。在公共歌唱数据集M4Singer上的实验结果表明,所提出的方法在一般SVC场景和跨域SVC场景中显著提升了模型性能。
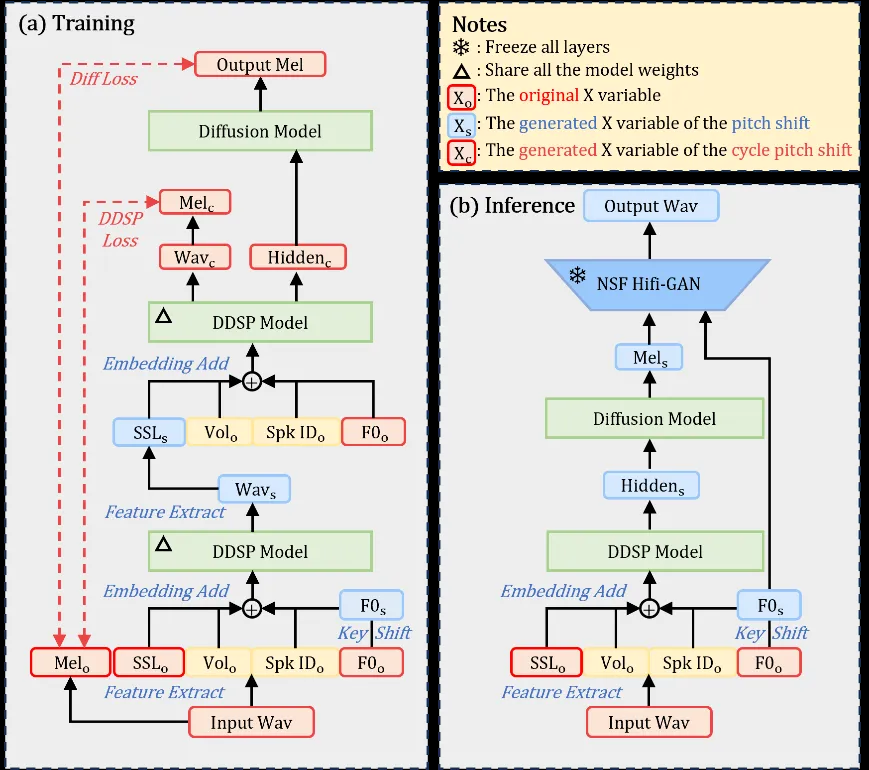
图3.1 SPA-SVC框架图
【论文链接】https://arxiv.org/abs/2406.05692
【代码链接】https://github.com/ShawnPi233/spa-svc
【Demo】https://shawnpi233.github.io/paper/spa-svc
【论文作者】李启飞,高迎明,文宇华,王聪,李雅
【论文单位】北京邮电大学
【作者邮箱】
lqifei@bupt.edu.cn,yingming.gao@bupt.edu.cn,2020212213@bupt.edu.cn,congwang@bupt.edu.cn,yli01@bupt.edu.cn
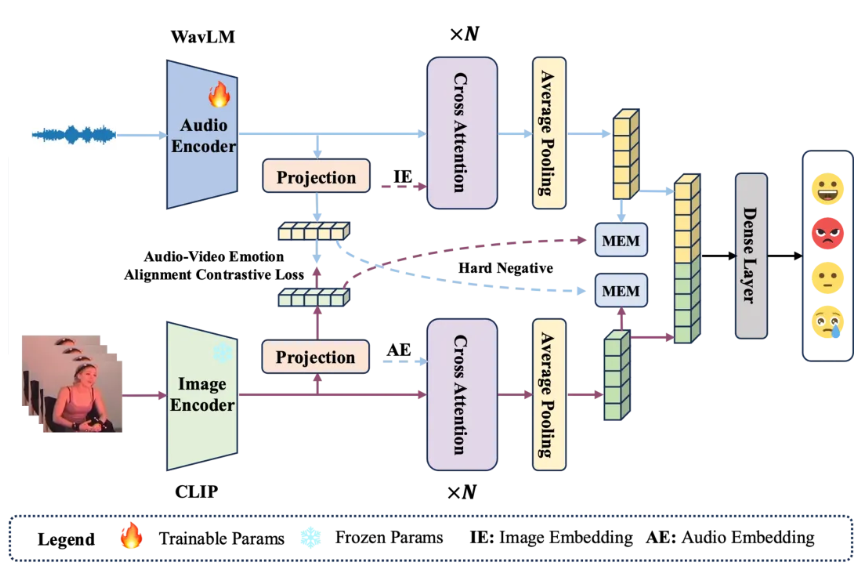
【论文亮点】本文提出一种新的基于多任务的多模态情感识别框架Foal-Net。它先对齐模态间的情感信息,再进行模态信息融合。此外,该框架还引进一种辅助模态融合的副任务MEM,用于促进模态信息融合,缓解难易样本导致模态信息融合不充分的问题。实验结果证明Foal-Net对多模态情感识别任务非常有效。
【论文简介】为了缓解多模态情感识别中模态间信息融合不充分的问题,本文提出了Foal-Net多模态情感识别框架。它由4个部分组成:音视频编码器、多模态融合模块、音视频情感对齐副任务(AVEL)和模态间情感标签匹配副任务组成(MEM),如图所示。音视频中包含很多共性的信息,例如性别、说话人、情感等等。模态融合过程中模型会同时关注到除情感外的其他信息。为了让模态融合有效且重点关注情感信息,Foal-Net先利用AVEL任务对齐两个模态间的情感信息,然后再进行音视频模态融合,来提升模态融合的有效性。此外,在训练过程中,对于简单样本模型只需要利用单一模态信息就能准确预测出样本情感,这会使得模型过多关注单一模态信息,导致模态信息融合不充分,在预测复杂样本不能有效的利用其它模态信息从而出现识别错误的情况。因此,Foal-Net引入MEM。它的目标是强迫模型利用两个模态信息判断当前样本对的情感是否相同,从而促进模态信息融合并引导模型更多地关注情感信息。最终,我们在在IEMOCAP语料库上评估进行的实验评估Foal-Net的有效性。实验结果表明,Foal-Net的性能超过了现有最先进方法,并且证明情感对齐在模态融合之前是必要的。
【代码链接】https://github.com/ASolitaryMan/Foal-Net
【论文作者】吕元骏,李海,闫影,刘俊辉,谢丹明,谢磊
【论文单位】西北工业大学、爱奇艺
【作者邮箱】yjlv@mail.nwpu.edu.cn,lxie@nwpu.edu.cn
【论文亮点】
一行代码
model_input = (mel_spec @ mel_filter.pinverse()).abs().clamp_min(1e-5)
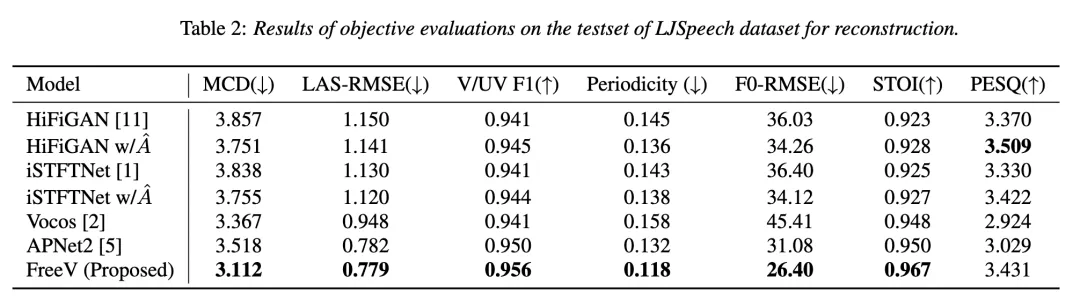
【论文简介】声码器根据声学特征重建语音波形,在TTS系统中发挥着举足轻重的作用。基于频域重建的声码器(如Vocos和APNet2)最近取得了快速发展,在推理速度上超过了时域模型,同时实现了良好的音频质量。然而,这些频域声码器由于参数量过大,从而带来了额外的内存负担。受PriorGrad和SpecGrad的启发,我们使用伪逆估计初始频谱。这种简单的初始化大大减少了声码器所需的参数量。基于APNet2和精简后的幅度谱预测分支,我们提出了FreeV,与APNet2相比,FreeV实现了1.8倍的推理速度提升,而参数几乎只有一半。同时,FreeV在音质上优于APNet2,这说明我们在追求实时、高保真语音合成方面又向前迈进了一步。
【论文链接】https://arxiv.org/abs/2406.08196
【代码链接】https://github.com/BakerBunker/FreeV
【Demo】https://bakerbunker.github.io/FreeV
【论文作者】李函昭,薛浏蒙,郭浩翰,朱新发,吕元骏,谢磊,陈云琳,殷昊,李志飞
【论文单位】西北工业大学、出门问问、香港中文大学(深圳)、香港中文大学
【作者邮箱】lihanzhao@mail.nwpu.edu.cn,lxie@nwpu.edu.cn
【论文亮点】本文提出首个专门为语音合成语言模型设计的单码本编解码器 Single-Codec。该编解码器以梅尔频谱作为建模目标,从特征解耦和语音内容建模两个方面出发提升单码本编解码器性能,能够在 304bps 带宽下将一秒语音压缩为 23 个离散单元。
【论文简介】借助多码本的语音编解码器,大语言模型范式能够被用于语音合成。然而多个码本会产生多个离散序列,这对语言模型的推理效率和鲁棒性构成了挑战。为了解决这个问题,我们提出了一种新的单码本语音编解码器——Single-Codec,用于高性能语音生成。Single-Codec 以梅尔频谱而非原始波形作为建模目标,从而能够有效压缩语音信息,同时保留重要细节。为了进一步增强编解码器的性能和语音合成的应用,Single-Codec 集成了几个关键组件:
1) 全局参考编码器用于解耦时不变特征。我们提取连续的全局表征而未离散化处理,并且从更长的参考段来捕获更多的声学细节,从而能够将足够的语音信息嵌入到单码本离散单元中。
2) BLSTM 模块用于上下文建模。该模块可帮助模型发现相邻帧之间的相关性,从而提高语音内容的聚类效率。
3) 混合采样模块。通过同时使用卷积和池化来下采样,转置卷积和复制来上采样,减轻上采样和下采样失真。
4) 重采样模块。鼓励编码器从声学序列中提取更多具有较低短时方差的发音相关信息。
与多码本的编解码器(如 EnCodec 和 TiCodec)相比,Single-Codec 在仅有 304bps 的较低带宽下,展现出了更高的重建质量,STOI、PESQ 以及说话人相似度分别达到 0.842,1.933 和 0.817。而基于大语言模型的语音合成上的实验结果进一步证实了 Single-Codec 的有效性,合成音频的自然度和说话人相似度均得到了提升。
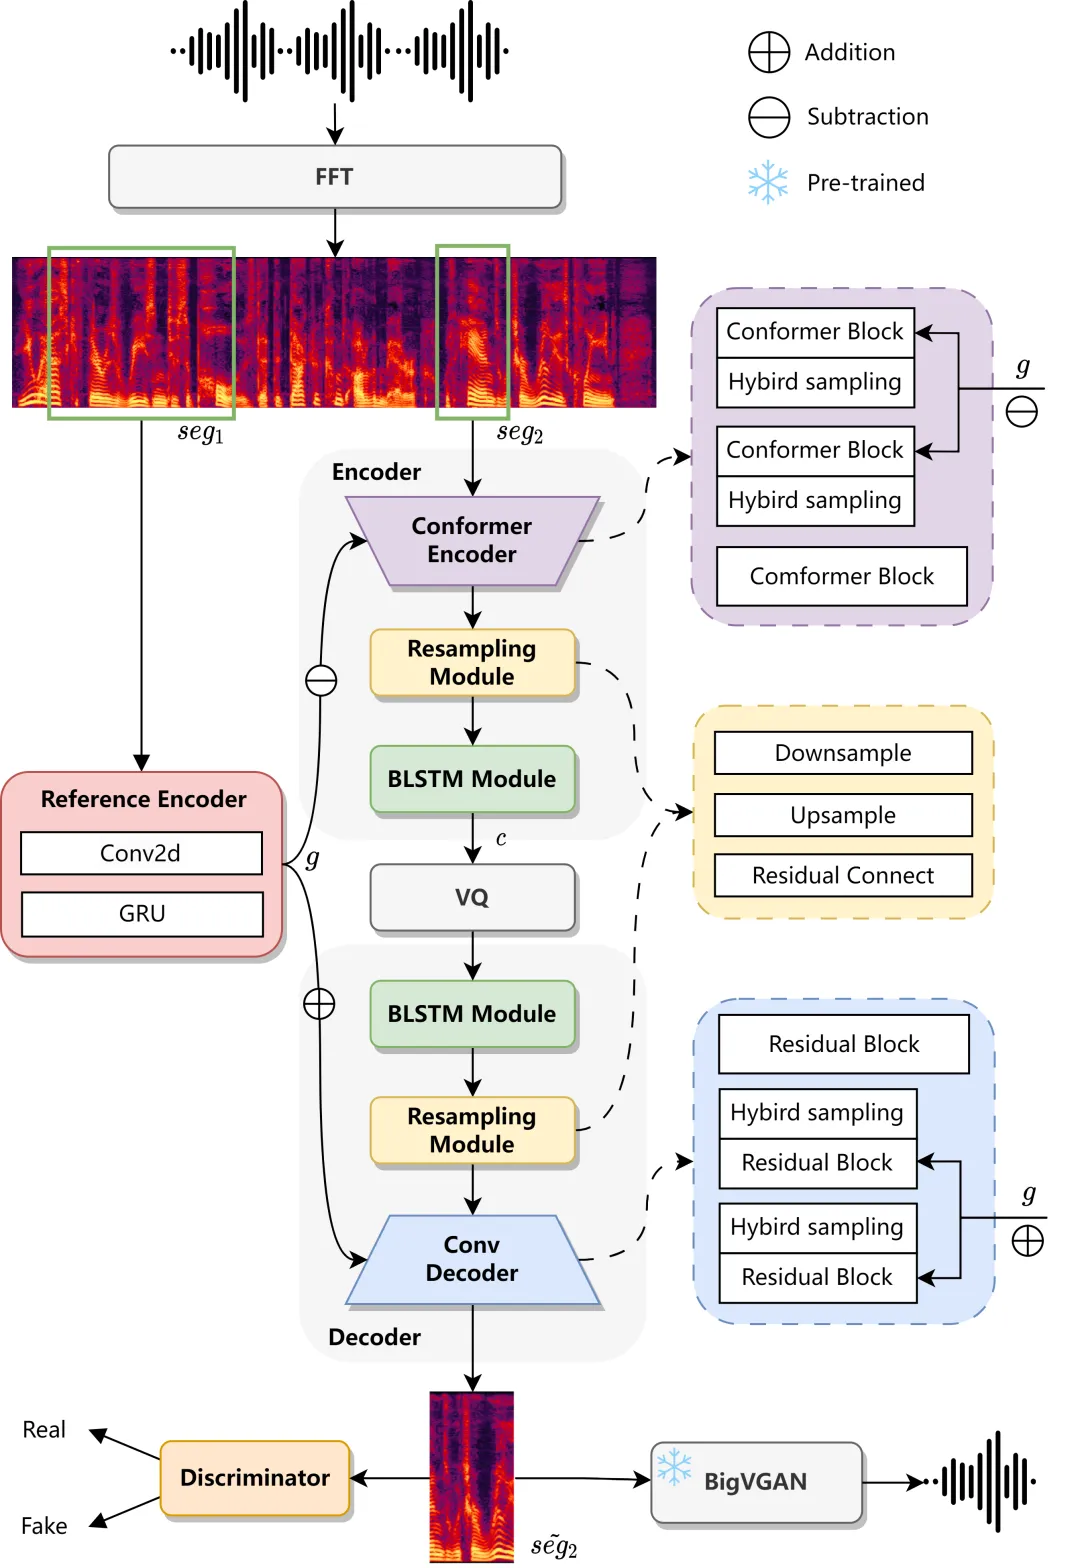
图6.1 Single-Codec 模型结构图
【论文链接】https://arxiv.org/abs/2406.07422
【代码链接】https://kkksuper.github.io/Single-Codec
【论文作者】姜月鹏,李涛,杨丰煜,谢磊,孟猛,王育军
【论文单位】西北工业大学、小米
【作者邮箱】jiangyp@mail.nwpu.edu.cn,lxie@nwpu.edu.cn
【论文亮点】本文提出了一种适用于中文的基于多层次韵律建模的零样本语音合成模型。通过对不同尺度内容进行韵律建模,让模型捕获全局和细粒度的韵律特征,有效提升零样本场景下合成结果的自然度和表现力。
【论文简介】最近零样本语音合成方面的研究取得了显著进展,特别是在说话人相似性方面。然而当前的工作侧重于音色的泛化上,而忽略了韵律建模,这使得合成语音的自然度和表现力有限。为了解决这个问题,我们提出了一种新的实现音色和层次化韵律建模语音合成模型。该模型在较大规模数据集上进行训练。由于音色是与表现力密切相关的全局属性,我们采用全局向量来建模说话者的音色,同时指导韵律建模。考虑到韵律既包含全局一致性又包含局部变化,我们使用扩散模型作为韵律预测器,并设计韵律适配器来实现层次化韵律建模,进一步增强合成语音的韵律表现。实验结果表明,我们的模型不仅保持了与基线相当的音色克隆能力,还展现出更好的自然度和表现力。
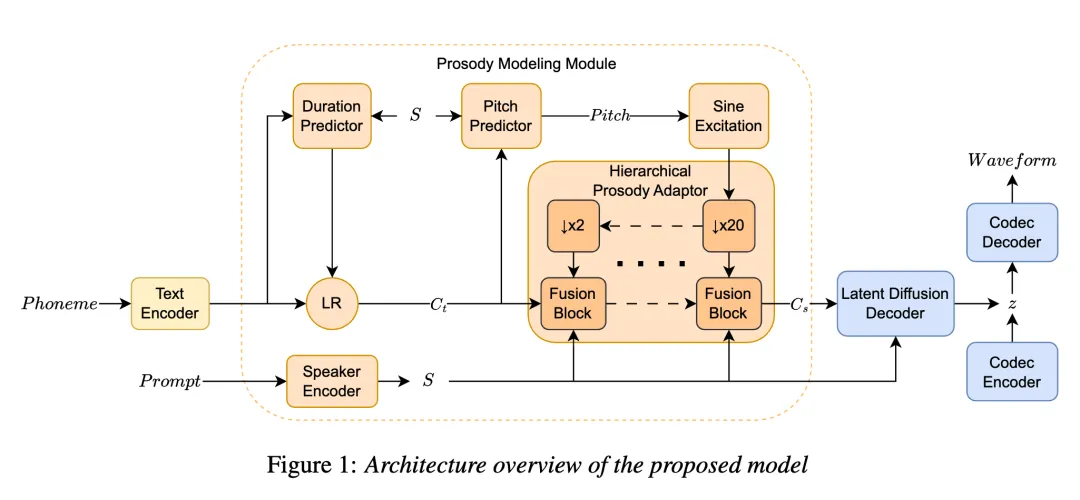
【论文链接】https://arxiv.org/abs/2406.05681
【Demo】https://rxy-j.github.io/HPMD-TTS/
【论文作者】刘铭帅,陈庒祺,闫晓鹏,吕元骏,夏咸军,黄传增,林丹峰,谢磊
【论文单位】西北工业大学、字节跳动
【作者邮箱】liumingshuai@mail.nwpu.edu.cn,lxie@nwpu.edu.cn
【论文亮点】本文在基于生成式对抗网络的两阶段音质修复模型RaD-Net的基础上,提出了升级版本RaD-Net 2。在第一阶段,使用基于因果性的蒸馏策略,在保证模型为因果的前提下有效利用未来信息;在第二阶段,进一步引入轴向自注意力机制提升模型的特征提取能力。
【论文简介】在实时通信系统中,语音信号经常遭受多种损伤的干扰。近期,在ICASSP 2024语音信号改善挑战赛上,我们提出了一个基于修复和降噪的两阶段模型RaD-Net,该模型可以有效改善语音信号质量。然而由于没有有效利用未来信息以及卷积感受野的约束,模型的性能受到了限制。为了解决上述问题,我们将RaD-Net扩展为RaD-Net 2。首先,在第一阶段引入基于因果性的知识蒸馏,使用非因果模型作为教师模型来提升非因果模型的性能。此外,在第二阶段将复数轴向自注意机制应用于复数特征编码器和复数特征解码器。实验结果表明,与RaD-Net相比,RaD-Net 2在ICASSP 2024 SSI挑战盲测试集上带来了0.10 OVRL DNSMOS的改进。