
 西工大音频语音与语言处理研究组
Whisper[1] 是一种在海量语音数据上训练的多任务、多语言语音基座模型,已在语音识别、翻译和语种识别等任务上表现出卓越性能。然而,其在说话人验证(SV)任务中的适用性尚未被探索,特别是在带说话人标签的语音数据有限的低数据资源场景。
近期,西北工业大学音频语音与语言处理研究组(ASLP@NPU)在语音旗舰期刊《Speech Communication》上发表了一篇题为“Whisper-SV: Adapting Whisper for Low-data-resource Speaker Verification”的论文。论文研究了如何将语音领域的多任务大模型Whisper迁移到数据资源有限的说话人验证任务中。该论文提出了一个适配器框架Whisper-SV,以提升Whisper在数据资源有限的说话人验证任务中的效果。由于原生Whisper并未针对SV任务进行特定优化,论文引入了一个表征选择模块,量化并选择Whisper各层中的说话人特征。然后,通过多层聚合模块整合这些特征,将多层表征整合成一个紧凑的单一表征。该模块使用卷积层和注意力聚合层来增强说话人特定信息,最终通过简单的分类模块进行说话人分类。实验结果表明,Whisper-SV在VoxCeleb1[2]、FFSVC[3]和IMSV[4]数据集上表现出色。
说话人验证(SV)指的是根据语音确认说话人身份的过程。近年来,深度学习在SV任务中取得巨大成功。然而,当前方法通常依赖于大量标注的训练语音,并且在挑战场景中,如远场和多语种SV任务中,性能显著下降。这种下降主要是由于这些低数据资源场景中缺乏大规模带有说话人标签的语音数据集,以及在传统的梅尔频率倒谱系数(MFCC)和滤波器组(Fbank)特征上训练的说话人模型缺乏鲁棒性。
整体框架
Whisper-SV的示意图如图1所示,包括四个模块:(a) 预训练的Whisper模块,(b) 表征选择模块,(c) 多层聚合模块,以及 (d) 说话人分类模块。预训练的Whisper模块用于提供来自Whisper的鲁棒和泛化性高的瓶颈表征。鉴于Whisper的主要训练目标与ASR、ST和LID,而非说话人验证SV任务,因此Whisper解码器生成的表征涵盖了更多与这些任务紧密相关的特征。本文重点利用Whisper编码器产生的表征来服务于SV任务。此外,引入了一个表征选择模块,用于量化Whisper每一层表征中的说话人特定信息,并选择具有显著说话人相关区分特征的top-k层用于SV。多层聚合模块旨在为SV整合Whisper不同层的特征。最后使用一个简单的分类模块进行说话人分类。
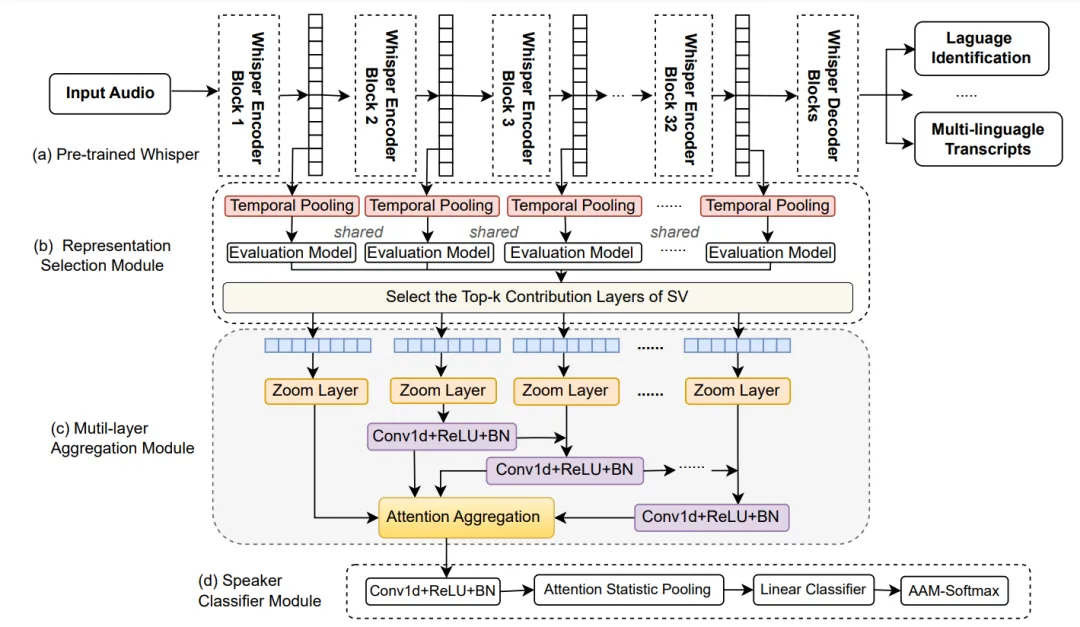
图1 Whisper-SV 的架构包括四个模块:(a) 一个预训练的 Whisper 模块,用于提供鲁棒且广泛的表征,(b) 一个表征选择模块,用于选择包含显著说话人特征的前 k 层,(c) 一个多层聚合模块,用于聚合来自 Whisper 多层的表征,(d) 一个说话人分类模块,用于进行说话人分类。
A. Whisper简介
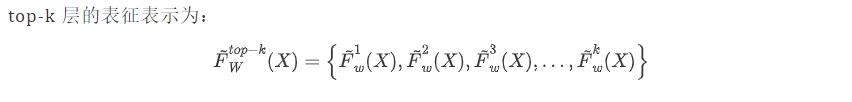
C. 多层聚合模块
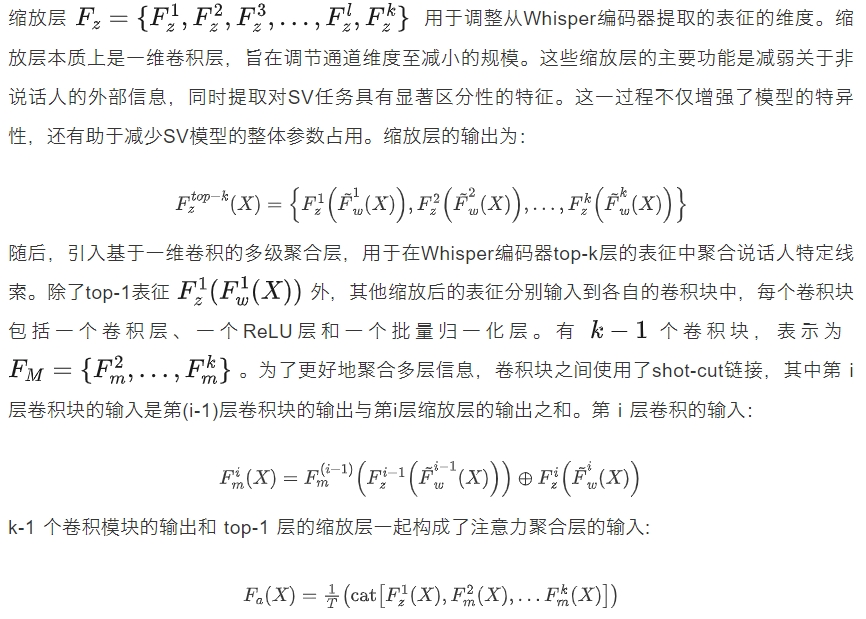
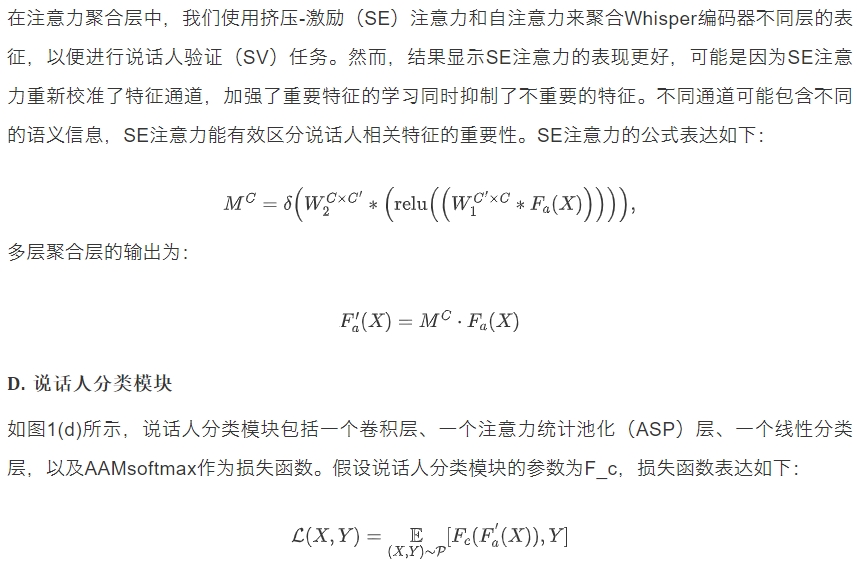
为了将Whisper的多层表征整合为单一、聚合的表征用于说话人验证(SV),我们引入了一个多层聚合模块,将Whisper top-k层的表征融合在一起。如图1(c)所示,多层聚合模块包括缩放层、基于一维卷积的多级聚合层,以及一个注意力聚合层,用于融合说话人特定线索并抑制来自top-k层表征中与说话人无关的信息。
A. 分析Whisper表征
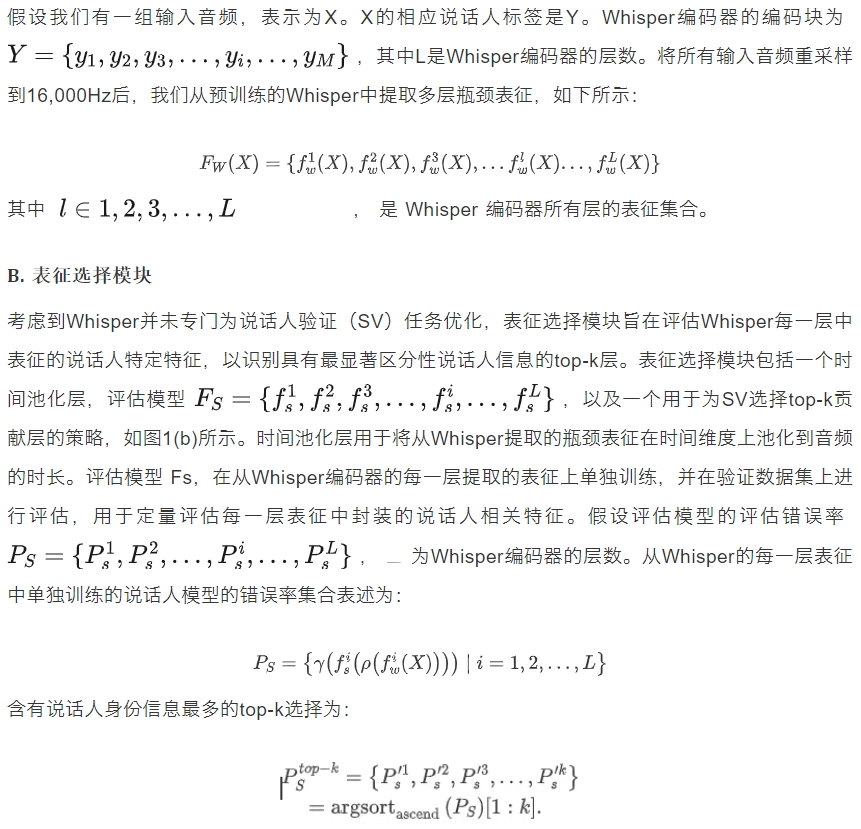
鉴于Whisper是专为多语言ASR、ST和LID设计,为了有效地将Whisper定制化适用于说话人验证(SV)任务,关键在于量化Whisper每一层表征中固有的说话人特定线索。为了分析每个独特层中封装的说话人相关的区分信息,我们独立使用从Whisper的每一层提取的表征训练SV模型,并评估每一层表征在SV中的性能。实验结果显示在图2中。我们使用一个综合评估指标((EER+10*\min DCF)/2)来识别错误率最低的top-k层,以确定最佳的表征提取层,用于在Whisper中训练SV模型。这种方法通过共同考虑EER和minDCF指标,提供了全面的评估,如图2中的绿线所示。
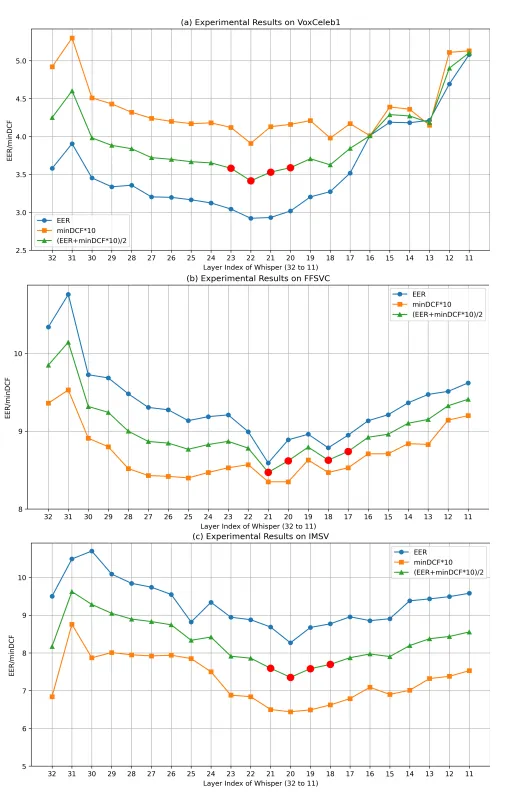
图2 使用从 Whisper 的每一层提取的表征训练 ECAPA-TDNN 的实验结果。红点表示综合 EER 和 minDCF 最低的前四个结果
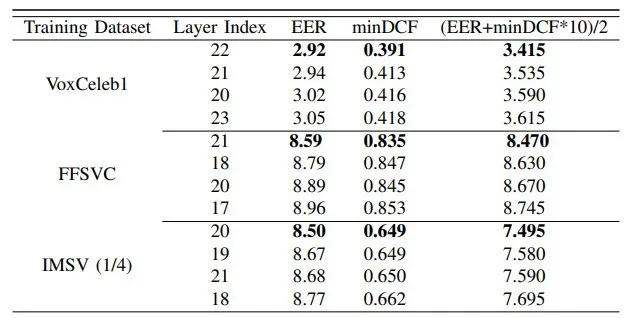
图2展示了来自三个数据集(VoxCeleb1、FFSVC和IMSV)的实验结果,显示Whisper在第20层左右的表征展示出了最佳的说话人区分特征,适用于说话人验证(SV)任务。此外,三个子图中观察到的趋势表明,Whisper表征在第15层之前的说话人特定信息逐渐减少。因此,我们的实验彻底分析了Whisper第32层到第11层的表征在SV任务中的性能。在图2(a)、(b)和(c)中,四个红点代表对应数据集中具有显著说话人区分特征的top-4层。所选top-4层的结果在表1中展示。从表1中可以看出,Whisper框架中包含最关键的说话人区分信息的层主要集中在第20层左右,位于Whisper编码器的中后部。基于这些实验发现,我们将识别并利用展示最佳性能影响的top-k层来优化SV模型。这些选定的层将被整合到一个专门为增强SV任务设计的多层聚合模块中。
表1 使用 Whisper 的top-4 层表征进行训练的 ECAPATDNN 的 EER (%) 和 minDCF (p=0.01)。
B. VoxCeleb1上实验结果
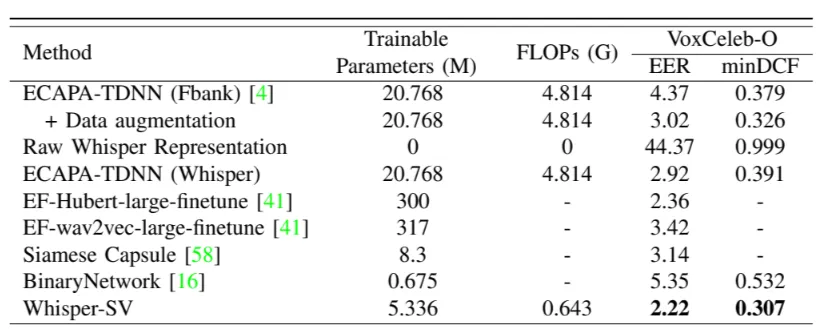
与直接使用Whisper top-1的最优表征训练ECAPA-TDNN(ECAPA-TDNN(Whisper))相比,Whisper-SV在EER/minDCF上显示出23.9%/21.4%的相对改进。同时,ECAPA-TDNN(Whisper)的结果超过了使用Fbank训练的ECAPA-TDNN(ECAPA-TDNN(Fbank))。这一观察强调了从Whisper提取的表征包含了更丰富的、特定于说话人的区分性特征,适用于SV任务。此外,与对自监督模型(如wav2vec2.0和Hubert)进行微调进行SV相比,Whisper-SV在EER和minDCF上都实现了更低的指标,同时具有更少的可训练参数和更高的计算效率。此外,Whisper-SV在SV任务中还优于Siamense Capsule网络后端处理方法和binary网络。
表2: VoxCeleb1上的实验结果EER(%)/minDCF(p=0.01)
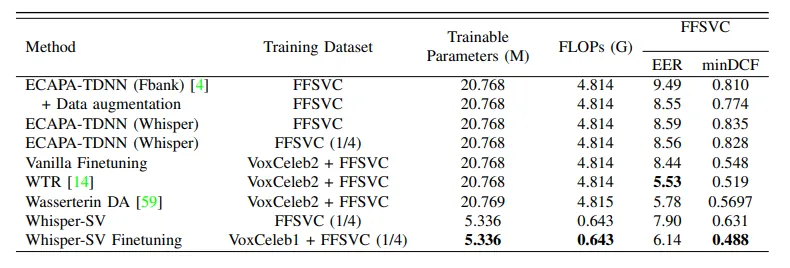
C. FFSVC上实验结果
此外,我们进行了 Whisper-SV 和领域适应方法(普通微调、WTR 微调和 Wasserterin DA)之间的对比实验,这些方法使用 VoxCeleb2 [3] 和 FFSVC 数据集进行训练。结果表明,使用仅
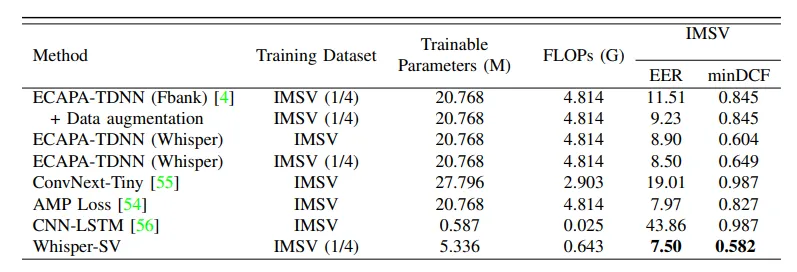
D. IMSV上实验结果
IMSV 数据集包含 50 个说话人,总时长约 100 小时,是一个带说话人标签的低数据资源语音数据集。类似地,我们在 IMSV 数据集上使用不同比例的训练集(例如 1/8、1/4、2/1、1/1)来验证 Whisper-SV 的效果。Whisper-SV在IMSV上的实验结果如表4所示,IMSV 的结果也显示仅使用
E. 消融实验
数据减少消融实验为了进一步探讨 Whisper-SV 是否在低资源场景下表现优于 Fbank,我们研究了数据减少与说话者验证 (SV) 性能之间的关系。实验结果如图3 所示。在将训练数据划分为不同的部分后,包括整个数据集、一半、四分之一和八分之一,进行了此分析。图3 中的结果显示,VoxCeleb1 数据集在使用整个数据集时表现最佳。然而,随着数据量的减少,使用 Fbank 特征训练的 ECAPA-TDNN 性能下降比 Whisper-SV 的结果更为显著。同时,FFSVC 和 IMSV 数据集的实验结果表明,当仅使用四分之一的数据量时,Whisper-SV 获得了最低的 EER 和 minDCF。相比之下,使用 Fbank 训练的 ECAPA-TDNN 在使用整个数据集时取得了最佳结果。这些结果表明,Whisper 表征包含更高密度的说话者特异性特征,同时有效地过滤掉了多余的噪声元素。而且,单个说话者的过多语音数据可能导致过拟合,使得 Whisper 表征在低资源数据场景下的 SV 任务中更具优势。
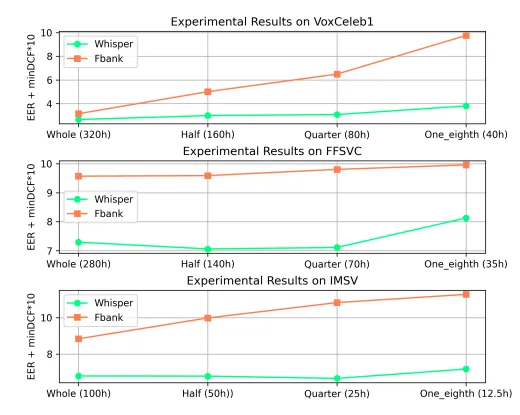
图3 ECAPA-TDNN和WhisperSV用不同比例的训练数据训练的实验结果对比
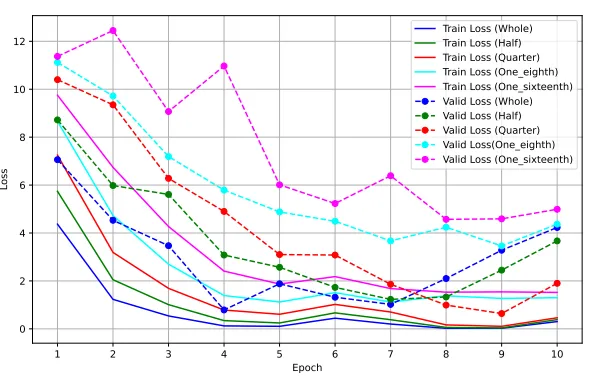
图4 FFSVC上训练过程中的训练和验证集合的损失趋势
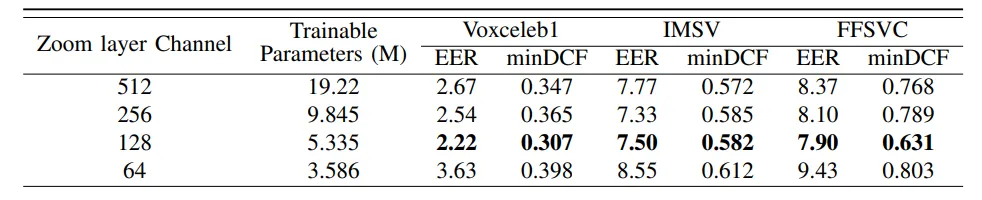
缩放层通道消融实验接下来探究了在缩放层中不同尺度的 Whisper 表征对 Whisper-SV 效果的影响。表 V 中的实验结果显示,当 Whisper 表征缩放到 128 维时,Whisper-SV 在三个不同的数据集上均达到了最佳性能。同时,缩放层中具有 128 通道的 Whisper-SV 显示出更少的可学习参数和更好的性能。这表明 Whisper-SV 具有低计算复杂度和最少的可训练参数的特点。
多层聚合模块的通道消融实验多层聚合模块由 1D 卷积块组成,用于聚合从 Whisper 提取的多层表征。表 VI 中展示了不同通道数在多层聚合模块中的实验结果。表 X 的实验结果表明,当多层聚合模块的通道数设置为 512 时,Whisper-SV 表现出最佳性能。
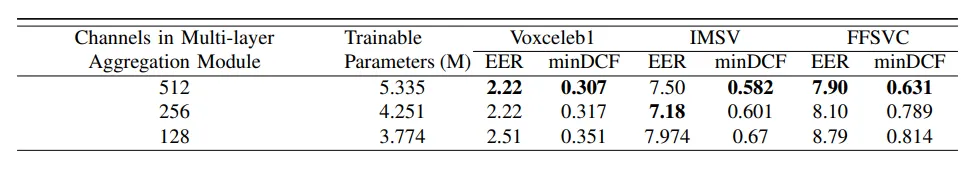
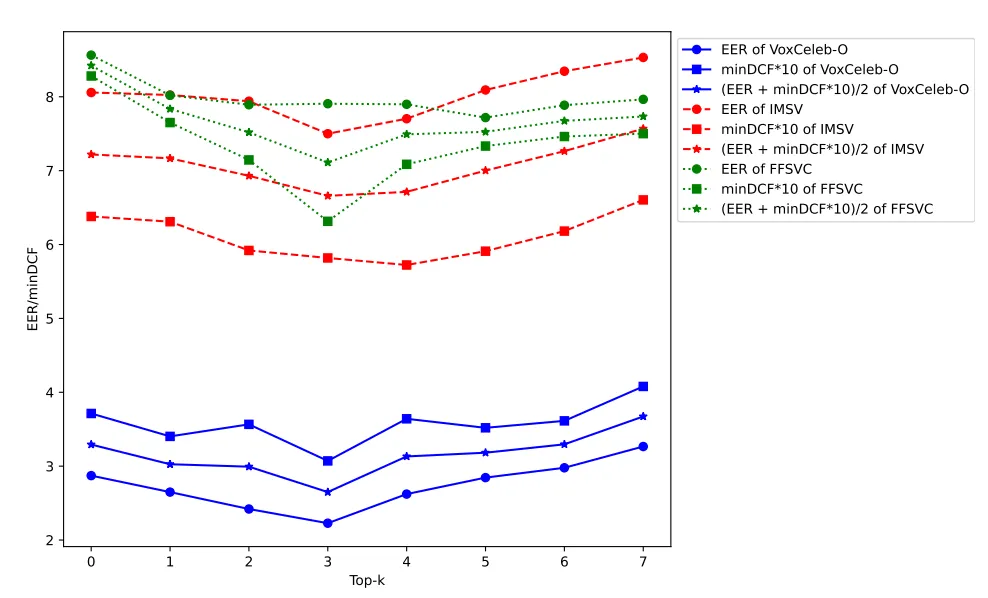
图5 VoxCeleb1 / FFSVC / IMSV上不同top-k的实验结果
F. Embedding可视化
为了进一步阐明从不同 SV 模型中提取的说话者embedding的判别性,我们使用 T-SNE 来展示原始 Whisper 表征、ECAPA-TDNN (Fbank) 生成的embedding、ECAPA-TDNN (Whisper) 生成的embedding以及 Whisper-SV 模型生成的embedding。这些embedding的分布如图6 所示。在图6 中,我们可以看到,无论测试数据集如何,使用原始 Whisper 表征进行说话者识别都是不可行的。说话者embedding的纠缠表明我们需要一个适配器将 Whisper 转移到 SV 任务上。观察 VoxCeleb1 上的embedding分布,可以明显看出,ECAPA-TDNN (Whisper) 比 ECAPA-TDNN (Fbank) 展示了更强的类内凝聚力。此外,Whisper-SV 在其embedding分布中表现出更好的凝聚力和更大的类间分离。在分析 FFSVC 的结果时,这些观察结果仍然成立,进一步证实了 Whisper-SV 的说话者embedding更具判别性和鲁棒性。Whisper-SV 在 IMSV 上的可视化结果显示,与 ECAPA-TDNN (Fbank) 和 ECAPA-TDNN (Whisper) 相比,其在困难样本上的分类性能有所提高。
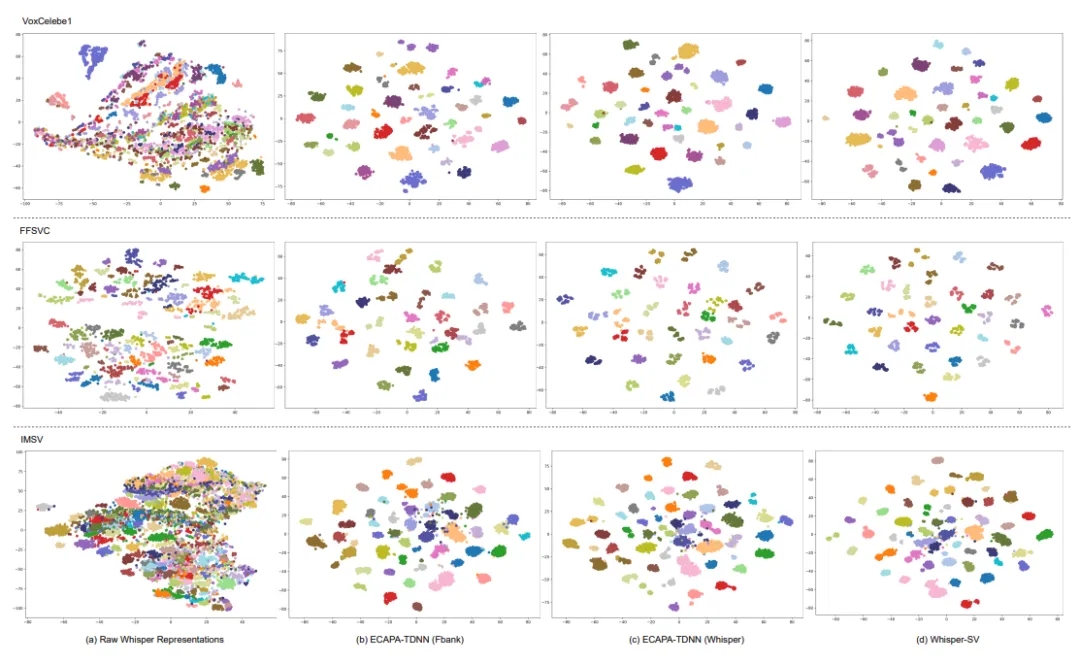
图6 不同 SV 模型的表征T-SNE可视化
[1] Alec Radford, Jong Wook Kim, Tao Xu, Greg Brockman, Christine McLeavey, and Ilya Sutskever, “Robust speech recognition via large-scale weak supervision,” in International Conference on Machine Learning. PMLR, 2023, pp. 28492–28518
[2] Arsha Nagrani, Joon Son Chung, Weidi Xie, and Andrew Zisserman, “Voxceleb: Large-scale speaker verification in the wild,” Computer Speech & Language, vol. 60, pp. 101027, 2020.
[3] Xiaoyi Qin, Ming Li, Hui Bu, Rohan Kumar Das, Wei Rao, Shrikanth Narayanan, and Haizhou Li, “The FFSVC 2020 evaluation plan,” in Conference of the International Speech Communication Association (INTERSPEECH), 2020.
[4] Jagabandhu Mishra, Mrinmoy Bhattacharjee, and SR Mahadeva Prasanna, “I-MSV 2022: Indic-multilingual and multi-sensor speaker verification challenge,” in International Conference on Speech and Computer. Springer, 2023, pp. 437–445.
