为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期是INTERSPEECH 2024专题第四部分,共遴选了9篇论文,覆盖语音通讯、语者切换点检测、声音事件检测、语音识别、音色转换、语音合成及数据库等研究方向。
此次INTERSPEECH2024专题导读论文仍在持续征集中,欢迎踊跃投稿,投稿方式请参见文末指南。
1.BS-PLCNet 2: Two-stage Band-split Packet Loss Concealment Network with Intra-model Knowledge Distillation
【作者邮箱】zhzhang@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】本文提出了一种新的两级带分丢包隐藏网络——BS-PLCNet 2,它是BS-PLCNet的升级版。得益于模型内知识蒸馏,BS-PLCNet 2在ICASSP 2024 PLC Challenge盲测集中实现了最先进的PLCMOS性能,其计算复杂度仅为BS-PLCNet的38.1%,模型参数量只有BS-PLCNet的40%。此外,在单次训练过程中就可以同时获得因果模型和非因果模型。【论文简介】音频丢包是实时语音通信中不可避免的问题。最近我们提出了一种针对全频段信号的频带分割丢包隐藏网络(BS-PLCNet)。虽然它在ICASSP 2024 PLC挑战赛中表现优异,但BS-PLCNet是一个大型模型,具有8.95G FLOPS的高计算复杂度。为此我们提出了其改进版本BS-PLCNet 2,以进一步降低计算复杂度并提高性能。具体来说,为了弥补缺失的未来信息,在宽带模块中,我们设计了双路径编码器结构(具有非因果路径和因果路径),并利用模型内知识蒸馏策略将未来信息从非因果教师提炼到因果学生路径。此外,我们在丢包恢复后引入了一个轻量级的后处理模块,以恢复语音失真并去除音频信号中的残留噪声。BS-PLCNet 2只有BS-PLCNet 40%的参数量以及38%的计算量,在ICASSP 2024 PLC挑战盲集上获得了0.18的PLCMOS提升,在该数据集上实现了SOTA的性能。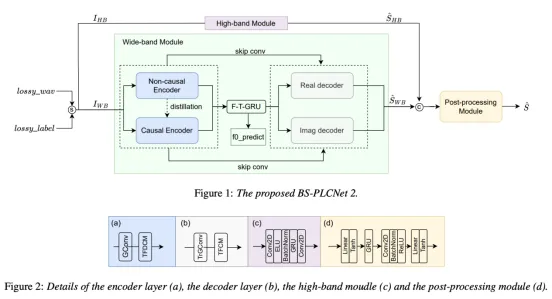
【论文链接】https://arxiv.org/abs/2406.05961
【Demo】https://zzhdzdz.github.io/BS-PLCNet2
2.SCDNet: Self-supervised Learning Feature based Speaker Change Detection
【作者邮箱】yueli77@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】本文提出了一种基于自监督学习表征的说话转换检测模型——SCDNet。通过加权融合策略,我们发现WavLM基础模型的第3层最适用于SCD任务中。此外我们还提出了一种对比学习方法,有效地减轻了基于微调的方法和 SCDNet 在训练中的过拟合趋势。【论文简介】说话人转换检测 (SCD) 用于识别对话中说话人之间的边界。受 wav2vec 2.0 模型在 SCD 任务中微调成功的启发,本文进一步研究了 SCD 的自监督学习 (SSL) 表征。具体来说,我们提出了一个名为 SCDNet 的 SCD 模型。我们研究了各种最先进的 SSL 模型,包括 Hubert、wav2vec 2.0 和 WavLm。为了辨别 SSL 模型中对 SCD 最有效的层,我们采用了一种可学习的加权方法来分析中间表征的有效性。同时,我们还引入了一种基于微调的方法来进一步比较 SSL 模型在 SCD 任务中的特性。此外,我们还提出了一种对比学习方法来减轻基于微调的方法和 SCDNet 在训练中的过度拟合趋势。实验展示了 WavLm 在 SCD 任务中的优势,也证明了 SCDNet 的良好设计。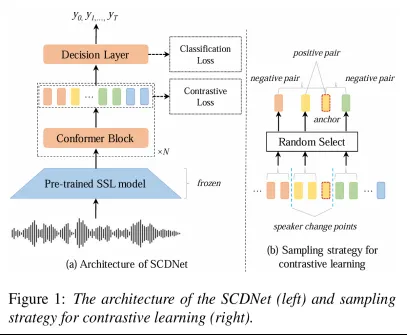
【论文链接】https://arxiv.org/abs/2406.08393
3.AS-70: A Mandarin stuttered speech dataset for automatic speech recognition and stuttering event detection
【论文作者】龚嵘*,薛鸿飞*,王乐之,徐昕,李其声,谢磊,卜辉,吴少玫,周家名,秦勇,张彬彬,杜俊,宾佳,李明【论文单位】西北工业大学、StammerTalk,希尔贝壳,AImpower,南开大学,WeNet开源社区,中国科学技术大学,昆山杜克大学rong.gong@stammertalk.net,hfxue@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】发布首个公开的普通话口吃语音数据集AS-70,也是同类数据集中最大的一个;建立了口吃语音识别和口吃事件检测的新基准。【论文简介】过去二十年来语音技术突飞猛进,在流利语音的自动语音识别(ASR)任务中取得了接近人类的水平。然而,当这些模型应用于非典型语音(如口吃)时,其效果却大打折扣。本文介绍的 AS-70 是首个公开的普通话口吃语音数据集,也是同类数据集中最大的一个。AS-70 包括对话和语音命令朗读语音,包括逐字人工转录的抄本,适用于各种语音相关任务的研究。此外,我们还建立了基准系统,并展示了 ASR 和口吃事件检测(SED)任务的实验结果。通过将该数据集纳入模型微调,可以观察到当前最先进的ASR模型(如 Whisper 和 Hubert)有了显著改善,从而增强了它们在处理口吃语音方面的包容性。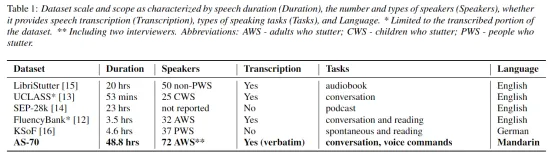
【论文链接】https://arxiv.org/pdf/2406.07256
4.DualVC 3: Leveraging Language Model Generated Pseudo Context for End-to-end Low Latency Streaming Voice Conversion
【论文作者】宁子谦,王帅,朱鹏程,王智超,姚继珣,谢磊,毕梦霄【论文单位】西北工业大学、网易,香港中文大学(深圳)【作者邮箱】ningziqian@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】提出一种端到端流式语音转换模型,以semantic token指导内容编码器学习替代对于语音识别模型的依赖,同时语言模型通过生成伪上下文提升转换效果,实现50ms下的流式推理。【论文简介】流式语音转换因其在实时应用中的潜力而越来越受欢迎。最近提出的 DualVC 2 实现了鲁棒、高质量的流语音转换,延迟时间约为 180 毫秒。然而,识别-合成框架无法端到端的优化,而流式 ASR 模型的不稳定性使得进一步降低延迟成为挑战。为解决这些问题,我们提出了端到端模型 DualVC 3。通过说话人无关的语义 token 来指导内容编码器的训练,消除了对 ASR 的依赖,模型可以在极小的chunk下运行,并消除了级联误差。此外,在内容编码器输出上训练语言模型,通过预测未来帧来生成伪上下文,为解码器提供更多上下文信息,从而提高转换质量。实验结果表明,DualVC 3 在主观和客观指标方面的性能与 DualVC 2 相当,延迟时间仅为 50 毫秒。【论文链接】https://arxiv.org/abs/2406.07846v1
【Demo】https://nzqian.github.io/dualvc3/
5.Vec-Tok-VC+: Residual-enhanced Robust Zero-shot Voice Conversion with Progressive Constraints in a Dual-mode Training Strategy
【论文作者】马林涵,朱新发,吕元骏,王智超,王子谦,贺雯迪,周鸿斌,谢磊【作者邮箱】mlh2023@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】本文提出了一种基于特征提示的零样本语音转换 (Zero-shot Voice Conversion) 模型 Vec-Tok-VC+ ,结合了残差增强的 K-Means 量化解耦方法以及多码本渐进式的判别约束,提升内容准确性和自然度。我们还构建了双模式的训练策略,消除训练和推理过程之间的不匹配,提升说话人相似度。【论文简介】零样本语音转换旨在将源语音转换为任意未见过的目标说话人音色,同时保持语言内容不变。近来的语音转换方法取得了显著进展,但解耦过程中的语义损失,以及训练和推理之间的不匹配问题仍然阻碍了转换性能。本文提出了一种新颖的由 Vec-Tok Codec 改进而来的基于特征提示的零样本语音转换模型 Vec-Tok-VC+ ,只需3秒的目标说话人提示(Prompt)即可实现语音转换。我们设计了一个残差增强的 K-Means 量化解耦器,通过两层的聚类过程增强对语义内容的提取。此外,我们利用构建的教师模块来指导模型在训练中模拟推理时的转换过程,以消除训练和推理之间的不匹配,形成双模式训练策略。另外,我们设计了一个多码本渐进式的损失函数,对模型的逐层输出进行由粗到细粒度的约束,以提高说话人相似度和内容准确性。客观和主观评估表明,Vec-Tok-VC+ 在自然度、可懂度和说话人相似度方面均优于强基线模型。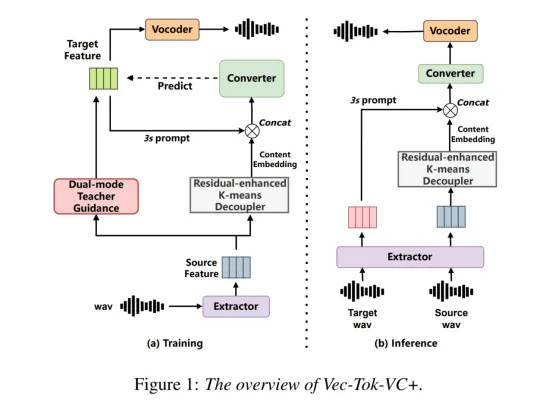
【论文链接】https://arxiv.org/abs/2406.09844
【Demo】https://ma-linhan.github.io/VecTokVC-Plus/
6.WenetSpeech4TTS: A 12,800-hour Mandarin TTS Corpus for Large Speech Generation Model Benchmark
【论文作者】马林涵 *,郭大可 *,宋堃,姜月鹏,王帅,薛浏蒙,许伟铭,赵欢,张彬彬,谢磊(*代表对本工作同等贡献)【论文单位】西北工业大学、深圳大数据研究院,香港中文大学(深圳),WeNet开源社区,Shanghai Bigmelon Technology【作者邮箱】mlh2023@mail.nwpu.edu.cn,guodake@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】本文提出了一个由开源 WenetSpeech 数据集改进而来的用于 TTS 任务的多域普通话数据集 WenetSpeech4TTS ,共包含 12,800 小时成对的音频和文本数据。我们根据质量评估分数的不同等级对 WenetSpeech4TTS 划分出了不同大小的子集,并在这些子集上训练和微调了 VALL-E 和 NaturalSpeech 2 系统以验证数据集可用性且为公平对比的基准提供基线模型。数据集、对应的基准以及模型权重均已开源。
【论文简介】
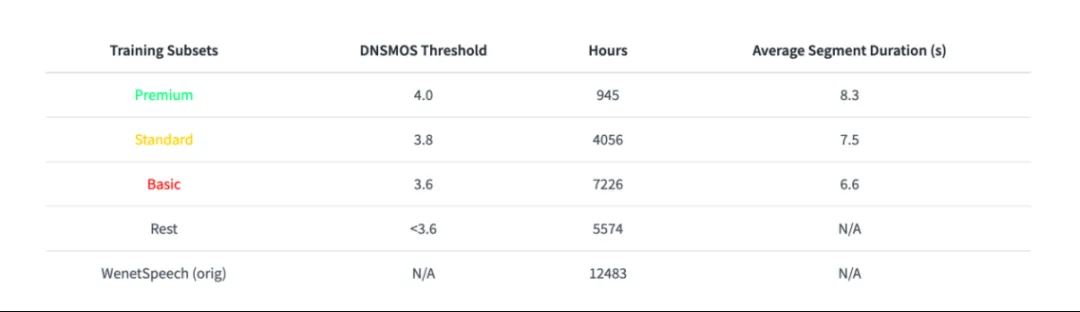
随着大型文本转语音 (TTS) 模型的发展和训练数据规模的扩大,最先进的 TTS 系统取得了令人印象深刻的性能。本文提出了 WenetSpeech4TTS,这是一个源自开源 WenetSpeech 数据集的多域普通话语料库。我们通过调整片段边界、增强音频质量以及消除存在多说话人的片段来改进 WenetSpeech,以适配TTS任务。经过更准确的转录操作和基于数据质量的过滤过程,获得了包含 12,800 小时成对的音频和文本数据的 WenetSpeech4TTS 语料库。此外,我们根据质量评估分数的不同等级划分出了不同大小的子集,以便进行 TTS 模型的训练与微调。我们在这些子集上训练和微调了 VALL-E 和 NaturalSpeech 2 系统,以验证 WenetSpeech4TTS 的可用性,同时为公平对比 TTS 系统的基准建立基线模型。WenetSpeech4TTS 语料库、对应的基准以及训练的模型权重均在 huggingface 上公开获取。
【论文链接】https://arxiv.org/abs/2406.05763
【Huggingface Link】https://huggingface.co/Wenetspeech4TTS/
【代码链接】https://github.com/dukGuo/valle-audiodec
7.Text-aware and Context-aware Expressive Audiobook Speech Synthesis
【论文作者】郭大可 ,朱新发,薛浏蒙,张雍茂,田文杰,谢磊【作者邮箱】guodake@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】本文提出了一种文本感知和上下文感知的高表现力有声书合成系统。首先,我们在语音风格的监督下通过对比学习建立一个能够覆盖多样风格的文本感知风格空间。之后,我们采用上下文编码器结合跨句子信息和从文本获得的风格嵌入。最后,我们将这一上下文编码器应用到VITS和LM-TTS两种典型的TTS模型中。实验结果表明,我们提出的方法能有效捕捉多样化的风格和连贯的韵律,从而在有声书语音合成中提升语音自然度和表现力。【论文简介】
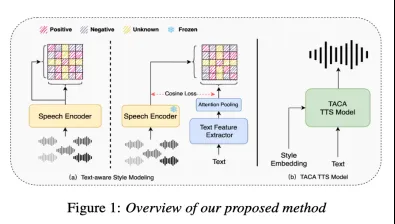
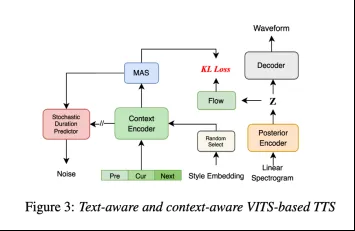
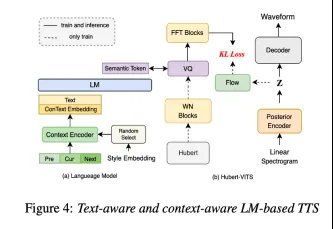
近年来,文本到语音技术(TTS)的进步显著提高了合成语音的表现力。然而,一个主要挑战是在不依赖手动标记数据或参考语音的情况下,生成能够捕捉到专业有声书播报人的多样化风格的语音。为应对现有风格选择的局限性,并实现更加实用的文本自适应风格预测,我们设计了一种文本感知风格建模策略,旨在学习一个覆盖广泛风格的语音风格空间。具体来说,我们采用半监督对比学习策略,通过语音风格的引导,直接从大规模数据集文本中提取风格表征。为了进一步融合上下文信息,我们提出了一种上下文编码器,该编码器能够从相邻句子中提取跨句信息,并将从文本中学习到的风格直接嵌入,一并送入文本到语音合成(TTS)系统,使其可以生成具有上下文感知高表现力和长篇连贯韵律的语音。鉴于上下文编码器具有即插即用的通用性,其可轻松集成至多数现有TTS框架中。在本文中,我们基于两种不同的TTS框架:一种是传统的基于VITS的TTS框架,另一种是主流的基于语言模型的TTS框架,构建了文本感知与上下文感知的TTS模型。实验结果显示,我们提出的文本感知风格建模方法能有效地从文本中提取丰富多样的风格,而上下文编码器则有助于学习连贯的韵律。
【论文链接】https://arxiv.org/abs/2406.05672
【Demo】https://dukguo.github.io/TACA-TTS
8.Streaming Decoder-Only Automatic Speech Recognition with Discrete Speech Units: A Pilot Study
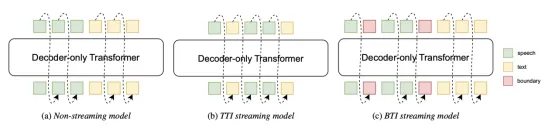
【作者邮箱】cpk00925@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】本文在decoder-only的结构上,实现了字级别的流式的语音识别。【论文简介】统一的语音-文本模型,如SpeechGPT、VioLA和AudioPaLM,在各种与语音相关的任务中表现出了令人印象深刻的表现,尤其是在自动语音识别(ASR)方面。这些模型通常采用统一的方法来建模离散的语音和文本符号,然后训练一个仅包含解码器的Transformer。然而,它们都是为非流式ASR任务设计的,在解码过程中需要整个语句。因此,我们引入了一个专门为流式识别设计的仅包含解码器的模型,并引入了一个专用的边界符号以促进流式识别,并在训练阶段使用因果注意力掩码。此外,我们引入了右块注意力和各种数据增强技术来提高模型的上下文建模能力。在AISHELL-1和-2数据集上的实验表明,在实现流式语音识别的同时,我们的流式方法在性能上与非流式解码器的对照方法相当。
【论文链接】https://arxiv.org/abs/2406.18862
9.A Transcription Prompt-based Efficient Audio Large Language Model for Robust Speech Recognition
【论文作者】李泱泽,王雄,曹松军,张一珂,马龙,谢磊【作者邮箱】yzli@mail.nwpu.edu.cn,lxie@nwpu.edu.cn【论文亮点】Audio-LLM将音频模态引入到大型语言模型(LLM)中,使得强大的LLM能够识别、理解和生成音频。然而,在嘈杂环境下的语音识别过程中,我们观察到Audio-LLM存在幻听和重复问题,导致引入额外的替换和插入错误。本文提出了一种基于转录提示的Audio-LLM方法,通过引入ASR专家作为转录生成器和混合自回归(AR)非自回归(NAR)解码方法来解决上述问题。在1万小时WenetSpeech普通话语料库上的实验结果显示,与基准模型相比,我们的方法在Test_Net和Test_Meeting评估集上相对降低了12.2%和9.6%的字符错误率(CER)。值得注意的是,我们将评估集上的解码重复率降低到了零,表明解码重复问题得到有效解决。【论文简介】本文提出了一个有效的训练框架,同时利用了两种模态。在Whisper的结构基础上,我们将由ASR专家模型生成的识别转录作为文本提示,在语音嵌入之前进行串联,并使用特殊的标记序列来指导任务。我们的方法通过帮助LLM从语音模态中提取语义信息,并通过额外的转录提示来改善其上下文建模能力,从而有效地提高了语音识别性能。这些额外的转录提示是由使用CTC(Connectionist Temporal Classification)损失训练的NAR ASR专家模型生成的。这个ASR专家模型可以约束LLM从文本模态中避免由其过度生成能力引起的额外转录错误。
同时由于CTC损失函数在语音和文本之间建立了时间对齐,导致解码重复的问题,因此我们进一步提出了一种混合AR NAR解码方法,在解码步骤中使用文本提示。这种方法可以从根本上解决音频-LLM的解码重复问题,并通过混合方法实现更低的ASR解码实时因子(RTF)。
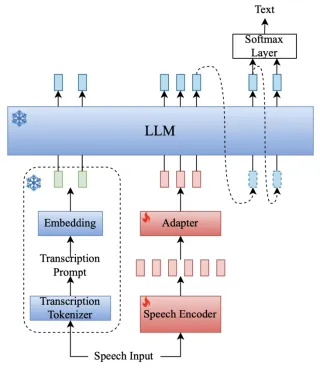
图9.1 整体框架
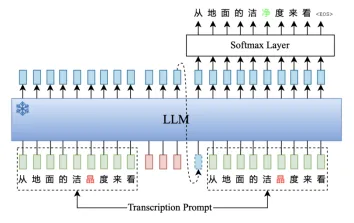
图9.2 非自回归解码

 西工大音频语音与语言处理研究组
