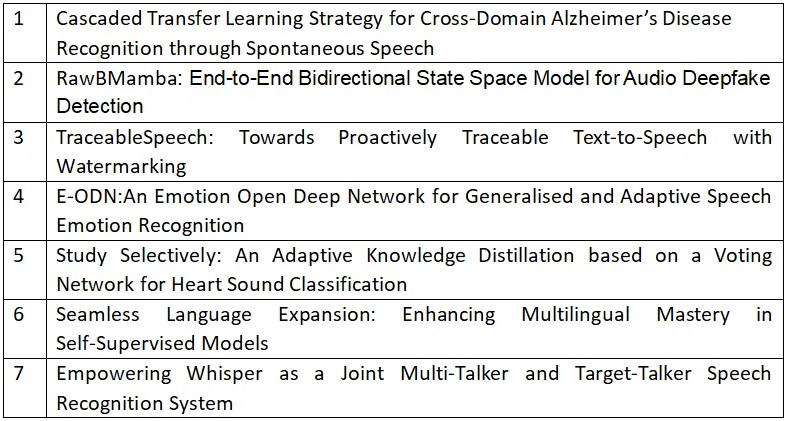
为促进最新研究成果的传播与交流,CCF语音对话与听觉专委在专委会微信公众号启动论文导读栏目,定期分享最新语音、对话与听觉相关研究方向论文。本期是INTERSPEECH 2024专题第五部分,共遴选了7篇论文,覆盖疾病检测、音频鉴伪、语音合成、音频水印、情感识别、语音识别等研究方向。
1. Cascaded Transfer Learning Strategy for Cross-Domain Alzheimer’s Disease Recognition through Spontaneous Speech【论文单位】江苏师范大学
【作者邮箱】2020221337@jsnu.edu.cn,jiny@jsnu.edu.cn
【论文亮点】为了解决不同语言的阿尔兹海默症(Alzheimer’s Disease, AD)数据集特征分布差异较大的问题,本文提出了级联的迁移学习策略用于跨语料库AD的识别。首先用大语言模型ChatGPT提取不同语言AD数据集的文本特征嵌入,然后再用本文提出的RF-MDSA进一步缩小不同库之间的特征分布,从而提高跨语料库的AD识别准确率。
从自发性言语中提取文本特征实现AD的识别已经被证明是可行的方法。然而由于AD数据集的样本数据较少,每个数据集大约只有几百条语句,识别效果并不理想。此外,不同语言的阿尔兹海默症数据集之间由于特征空间分布的差异,无法直接合并扩展数据集,一般会采用迁移学习的方法。然而现有的跨域迁移学习大多数只考虑单级迁移学习,比如微调预训练深度神经网络模型或传统机器学习方法。因此,为了结合二者的优势,本文提出了一种通过自发性语言进行跨域AD识别的级联迁移学习策略。该策略的目标是通过级联的迁移学习策略,逐步对齐从不同语料库中提取的特征空间,得到一个共同的投影子空间。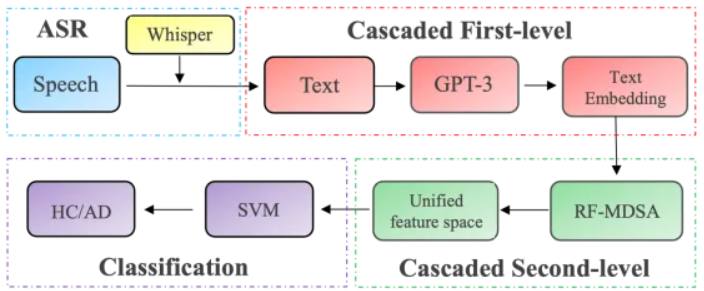
图1.1模型框架图
模型框架如图1.1所示,通过自动语音识别(ASR)生成文本,利用预训练大语言模型GPT-3提取文本特征作为第一级迁移,利用本文提出的随机森林多源判别子空间对齐(RF-MDSA)算法进一步缩小不同语料库的文本特征空间差异,并使用支持向量机(SVM)作为分类器。我们在中文(NCMMSC2021)、英文(ADReSS)和西语(Ivanova)三个语料库上进行实验。在单一语料库实验中,我们利用GPT-3提取文本特征,分别达到了74.6%、82.4%和62.8%的识别率,比用BERT、RoBerta、MacBert等语言模型提升了3%-5%。在跨域实验中,合并两个数据集直接测试另一个数据集的识别率作为基线系统,识别率分别为39.6%、53.6%和45%。而采用本文提出的级联迁移学习的策略分别达到了71.8%、72.9%和56.1%的准确率,识别率获得了较大的提升。图1.2显示了采用本文算法前后的文本特征空间分布比较。图1.2a显示不同语言的AD数据集特征空间分布有明显的差异,而采用本文提出的方法后,不同数据集的特征分布差异性显著缩小,如图1.2b所示。实验结果表明,本文提出的方法可以在AD识别中有效提高模型的泛化能力和鲁棒性。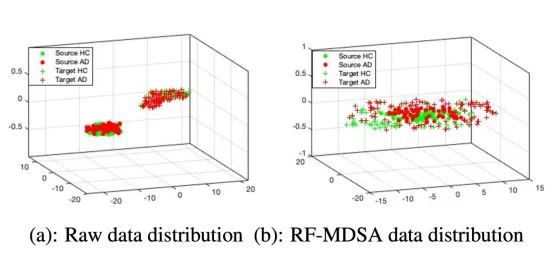
图1.2采用本文算法前后的文本特征空间分布比较
2.RawBMamba: End-to-End Bidirectional State Space Model for Audio Deepfake Detection
【论文作者】 陈玉杰,易江燕,薛军,王成龙,张晓辉,董舜波,曾思丁,陶建华,范存航,吕钊
【作者邮箱】 e22201148@stu.ahu.edu.cn,jiangyan.yi@nlpr.ia.ac.cn,cunhang.fan@ahu.edu.cn
【论文亮点】本文提出了一种基于状态空间模型的端到端深度语音伪造检测模型,在ASVspoof2019 LA,ASVspoof2021 LA,ASVspoof2021 DF数据集上都表现出优异的性能。
【论文简介】
伪造伪迹在区分真实和伪造音频时可以存在于短距离和长距离片段中。因此,结合局部和全局特征信息可以有效区分真实和伪造音频。本文提出了一种端到端的双向状态空间模型,名为RawBMamba,用于捕捉音频深度伪造检测中的短距离和长距离辨别信息。具体来说,我们使用SincLayer和多个卷积层来捕捉短距离特征,然后设计了一个双向Mamba以解决Mamba单向建模问题,并进一步捕捉长距离特征信息。此外,我们设计了一个双向融合模块来整合嵌入,增强音频上下文表示,并结合短距离和长距离信息。结果显示,我们提出的RawBMamba在ASVspoof2019 LA,ASVspoof2021 LA,ASVspoof2021 DF数据集上都实现了具有竞争力的效果。该工作已被Interspeech 2024接收。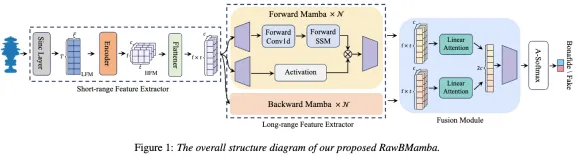
【论文链接】https://arxiv.org/abs/2406.06086
【Code链接】https://github.com/cyjie429/RawBMamba
3.TraceableSpeech: Towards Proactively Traceable Text-to-Speech with Watermarking【论文作者】周俊佐, 易江燕,汪涛,陶建华,白烨,Zhang
Chu Yuan,任勇,温正棋
【论文单位】中国科学院自动化研究所,中国科学院大学人工智能学院,清华大学自动化系
【作者邮箱】zhoujunzuo2023@ia.ac.cn,jiangyan.yi@nlpr.ia.ac.cn
【论文亮点】本文提出TraceableSpeech,该TTS模型可以直接生成带水印的语音,从而提高水印的隐蔽性和语音质量。此外,本文还设计了基于帧的水印印记和提取方法,不仅操作上较为灵活,而且对时间编辑类的攻击体现了不错的稳健性。实验结果显示,TraceableSpeech在水印的隐蔽性、语音质量和抵挡时间编辑类攻击的能力均优于强基线WavMark.
语言模型技术在文本转语音(TTS)任务中取得了出色的表现。合成语音变得越来越逼真和自然,引发了涉及安全和隐私的社会问题,如深度伪造音频欺诈和版权保护等等。因此,有必要对TTS系统进行主动溯源。过去的方法在TTS系统合成语音后添加水印,不仅适应性有限,且水印隐蔽性不足。本文将水印技术与基于语言模型的TTS相结合,提出具有主动溯源功能的TTS模型TraceableSpeech。通过将语音编解码器和水印机制的端到端联合训练,该模型可以直接生成带水印的语音,优化了水印的不可感知性和语音质量,在PESQ、ViSQOL和主观指标等方面取得了较高分数。其次,为了提高鲁棒性和灵活性,本文针对TTS任务设计了一种水印融入和提取方法。该方法通过广播水印Embeding,并与编解码器的语音中间特征进行帧级别尺度上合并,并通过ResNet提取r向量进行水印还原。该方法不仅性能较稳健,同时操作灵活。对于语音的编辑-拼接攻击,水印提取的准确率更高。即使在0.3秒的语音中嵌入4位数字的64进制水印,提取准确率仍保持在95%以上。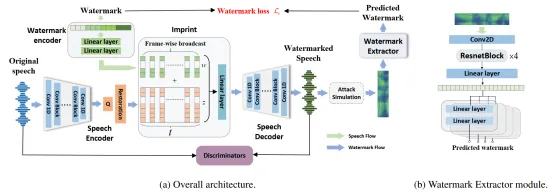
图3.1 第一阶段:水印机制与神经编解码器整合
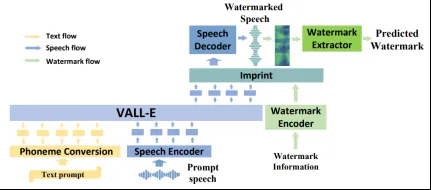
图3.2: 第二阶段:水印机制与VALL-E语言模型整合
【论文链接】https://arxiv.org/abs/2406.04840
4.E-ODN:An Emotion Open Deep Network for Generalised and Adaptive Speech Emotion Recognition
【论文作者】马流羡,申林,李若冰,张昊杰,钱昆,胡斌,Björn W. Schuller, Yoshiharu Yamamoto
【论文单位】北京理工大学,英国帝国理工学院,德国慕尼黑工业大学,日本东京大学
【作者邮箱】qian@bit.edu.cn,bh@bit.edu.cn
【论文亮点】情感开放网络模型(Emotion Open Deep Network, E-ODN)是一种专门用于处理语音情感识别(Speech Emotion Recognition, SER)任务的深度学习框架。与传统的SER模型不同,E-ODN模型能够识别更广泛的复杂和混合情感,在处理不平衡的数据分布时更加鲁棒,并且能够自适应识别新出现的未知情感类型。
情感开放网络模型(Emotion Open Deep Network, E-ODN)是一种专为语音情感识别任务设计的开放识别模型,能够处理包括复杂和混合情感在内的广泛情感类型,并且具备识别未知情感的能力。该模型采用了三维情感空间映射技术,基于Mehrabian等人提出的情感PAD模型,将情感体验映射到愉悦(Pleasure)、唤醒(Arousal)、支配(Dominance)三个维度上,通过空间距离来量化和区分不同的情感状态。与传统的封闭集识别不同,E-ODN模型实现了开放集识别,能够识别并推断出未知的情感类别,即使面对未见过的情感表达也能保持高识别准确性。此外,模型通过多类阈值法进行未知类别检测,自动推断未知情感样本的特征向量,并通过与已知情感向量的距离来实现分类和标记。在增量训练策略中,模型通过逐步引入新的样本和类别,动态更新模型权重,有效避免了过拟合问题。使用IEMOCAP数据库进行的实验验证了E-ODN在处理不平衡数据集时超越现有最优模型的性能,特别是在数据样本稀缺的情况下,其表现尤为出色。论文还展望了E-ODN模型未来在情感语音生成任务中的应用,说明该模型将为创造具有细粒度情感表达的语音数据提供技术支持。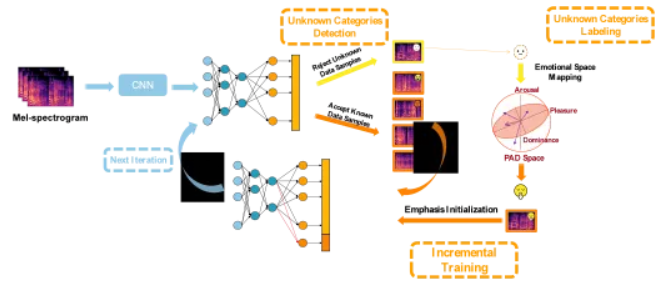
图4.1 E-ODN模型架构图,模型整个工作流程主要分为三个部分:未知类别检测、未知类别标记和增量训练。
模型的核心在于接受已知样本的同时拒绝未知样本,确保在开放空间中的最小风险。在未知类别检测阶段,E-ODN 采用了多类阈值法来确定样本是否属于已知类别或未知类别。如果样本被识别为未知类别,接下来在未知类别标记阶段,模型会利用情感空间映射方法自动推断未知情感的具体类型,将未知情感样本映射到三维的PAD情感空间中,生成特征向量,并计算与已知情感标准向量之间的距离来评估它们的相似性。在增量训练阶段,模型利用新样本与已知情感在PAD情感空间中的距离,以及现有模型权重来初始化新类别的权重,然后使用检测到的未知数据对模型进行微调。这一过程不仅使模型能够快速有效地学习新加入的情感类别,而且通过调整已知和未知类别的不同学习率,允许新权重以更快的速率学习,从而提高了模型对新情感的识别能力。【文章链接】https://www.researchgate.net/publication/381215298_E-ODN_An_Emotion_Open_Deep_Network_for_Generalised_and_Adaptive_Speech_Emotion_Recognition
【引用信息】
Liuxian Ma, Lin Shen, Ruobing Li, Haojie Zhang, Kun Qian, Bin Hu, Björn W. Schuller, and Yoshiharu Yamamoto, “E-ODN: An Emotion Open Deep Network for Generalised and Adaptive Speech Emotion Recognition” in Proc. INTERSPEECH, Kos Island, Greece, 2024, pp. 1–5.
5. Study Selectively: An Adaptive Knowledge Distillation based on a Voting Network for Heart Sound Classification
【论文作者】邱夕航,朱立贤,宋子恺,陈泽宇,张昊杰,钱昆,张晔,胡斌,Yoshiharu Yamamoto, Björn W. Schuller
【论文单位】北京理工大学,南京航空航天大学,深圳北理莫斯科大学,日本东京大学,英国帝国理工学院,德国慕尼黑工业大学
【作者邮箱】qian@bit.edu.cn,ye.zhang@smbu.edu.cn,bh@bit.edu.cn
【论文亮点】知识蒸馏在模型压缩领域应用广泛,本文提出的新型的知识蒸馏框架实现了自适应的多教师知识蒸馏。我们提出了“Voting Network”来实现在每个蒸馏节点上对来自多个教师网络的知识进行筛选,从而提高知识的质量以及蒸馏的效率。
利用深度神经网络(DNN)进行心音分类的方法近来被广泛应用于心血管疾病的早期检测。虽然DNN识别率很高,但其对庞大计算资源的需求意味着无法部署到硬件设备上,因此限制了其进一步发展。如今,知识蒸馏(KD)已成为一种较为成熟的模型压缩范式。KD的主要目的是将知识从一个复杂的教师网络传递到一个轻量化的学生网络,从而使得学生网络的表现与教师网络相近,甚至超过教师网络。由于心音数据具有时域频域多维度的特征,我们希望能够设计多教师的知识蒸馏架构将不同维度的特征更好地结合起来。目前关于多教师知识蒸馏的研究表明,与单教师知识蒸馏相比,多教师知识蒸馏可以向学生传授更全面的知识,但这种方法并不适用于所有场景。为了解决这个问题,本文提出了一种新颖的 KD 策略(AKDVN)以实现自适应的多教师知识蒸馏机制。为了提高模型架构的泛化能力,受集成学习中投票机制的启发,我们设计了一种名为 " Voting Network "的教师选择策略来判别不同教师对每个蒸馏节点的贡献。该轻量级的网络会随着KD网络同步跟新参数,以输出实时的权重矩阵。当来自不同教师的知识流达到蒸馏节点时,KD网络将会根据"Voting Network "输出的权重矩阵来微调知识流中各教师知识的权重,从而让学生网络学习更为有效的知识,减少冗余的信息,提高知识的有效性。实验表明,我们的方法在保持较低计算复杂度的同时,能够达到较高的准确率。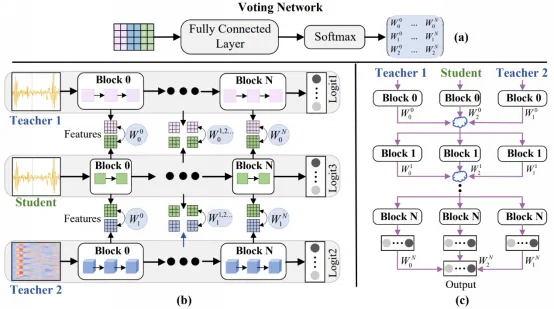
图5.1 AKDVN 的详细结构:(a)显示了"Voting Network "的结构,
(b)指出了自适应知识蒸馏的训练过程,(c)讲述了加权融合网络的架构。
【文章链接】https://www.researchgate.net/publication/381306477_Study_Selectively_An_Adaptive_Knowledge_Distillation_based_on_a_Voting_Network_for_Heart_Sound_Classification
【引用信息】
Xihang Qiu, Lixian Zhu, Zikai Song, Zeyu Chen, Haojie Zhang, Kun Qian,Ye Zhang, Bin Hu, Yoshiharu Yamamoto, and Björn W. Schuller,“Study Selectively: An Adaptive Knowledge Distillation based on a Voting Network for Heart Sound Classification”, in Proc. INTERSPEECH, Kos Island, Greece, 2024, pp. 1–5.
6.Seamless Language Expansion: Enhancing Multilingual Mastery in Self-Supervised Models
【论文作者】徐菁,吴明林,吴锡欣,蒙美玲
【论文单位】香港中文大学
【作者邮箱】jingxu.se@cuhk.edu.hk,minglinwu@link.cuhk.edu.hk
【论文亮点】现有的自监督模型通常是为有限的语言开发的,但是在现实世界的应用中可能会遇到新的语言,但是为每种语言都开发新的自监督模型的成本很高。因此,如何有效地使现有的自监督模型适应新的语言,并且同时不损失原来的语言能力是至关重要的。为了解决此问题,本文提出了一个新颖的自监督模型的新语言适应方法,我们提出采用LoRA来解决自监督模型在新语言上无法适应的问题。然而简单地采用lora进行适应会导致灾难性的模型遗忘的问题,因此我们又提出了保持策略,通过数据组合和重新聚类的方法来避免灾难性遗忘使适应后的模型在原有语言上表现变差的问题。
自监督模型已经在广泛的下游任务上体现了它的强大。然而它们通常只为有限的语言开发,而且在现实生活中常会遇到新语言。同时由于自监督模型通常有较为庞大的参数,为每个新语言都开发一个自监督模型会带来庞大的开销。因此如何使得自监督模型能够适应新语言十分重要。但是由于各个语言在音素和字素上存在较大差异,使得这个任务更加的困难。同时在将已有模型适应到新数据和新任务时,会带来灾难性遗忘的问题。为了解决语言不匹配的问题,我们提出了参数高效的适应方法,即采用LoRA来解决自监督模型在新语言上无法适应的问题。同时我们采用了数据组合和重新聚类的方法来缓解灾难性遗忘问题。本文中采用的自监督模型是mHuBERT,要适应的新语言是中文。通过模型在语音再生成任务上的表现来验证我们方法的有效性。实验结果表明我们的自适应方法和保持策略能够使得mHuBERT在新语言上表现增强同时基本不会损失原有语言的能力。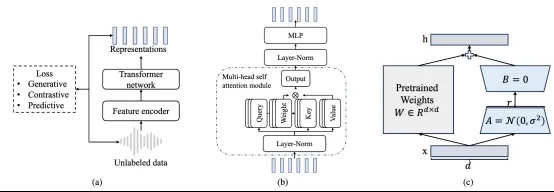
图6.1模型结构图,我们将LoRA引入到了Transformer块的自注意力层的key,value,query的projection layer中。
数据组合:在适应训练的过程中同时采用中文数据和英文数据,同时为了减少中文数据上的性能下降,我们将中文和英文数据的比例选择为1:0.1。重新聚类:在这种策略中,我们将英语和中文数据引入到适应后的模型中,以从指定的中间层生成它们各自的表示。随后,使用得到的中文表示和英文表示训练一个新的K-means模型。【论文链接】https://arxiv.org/abs/2406.14092
【Demo链接】https://jingxu96.github.io/multilingual-ssl-demo/index.html
7. Empowering Whisper as a Joint Multi-Talker and Target-Talker Speech Recognition System【论文作者】孟令威,亢嘉文,王月娇,金增锐,吴锡欣,蒙美玲
【论文单位】香港中文大学
【作者邮箱】lmeng@se.cuhk.edu.hk
【论文亮点】多说话人语音识别和目标说话人语音识别都涉及在多说话人的环境中进行语音转录,目前仍面临挑战。然而,现有的方法很少尝试同时解决这两个任务。在本研究中,我们提出了一种参数高效的创新方法来赋能Whisper,以同时应对多说话人和目标说话人语音识别任务。
【论文简介】
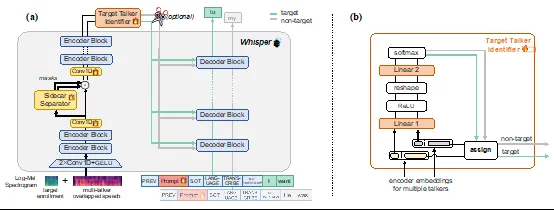
如今,经过大规模预训练的语音基础模型在各种语音任务上展现出了巨大的潜力。作为该领域的代表之一,Whisper不仅展现了极佳的ASR能力,还被拓展到各类语音相关任务中,这激励我们进一步扩展Whisper在处理多说话人和目标说话人语音识别挑战的能力。在本研究中,我们以参数高效的方式将Whisper增强为一个多说话人和目标说话人语音识别的联合系统。具体而言,我们冻结了Whisper的权重,并在其编码器中加入了Sidecar分离器,使其具备多说话人语音识别能力。同时,引入目标说话人标识模块(TTI),能够即时区分目标说话人的embedding分支,仅需三秒钟的目标说话人注册语音作为prompt。此外,还采用soft prompt来使得Whisper解码器更好迁移到目标任务。我们的主要贡献有三点:我们提出了一种种开创性的框架,可以同时转录多位说话人¬¬,同时标识目标讲话者的转录我们的模型无需使用任何Speaker Embedding提取器。
我们的模型是一个参数高效且低耦合的系统。我们利用冻结后的Whisper作为基础模型,可训练参数较少,训练成本低。
大量实验表明,在两项任务上,该方法在两个和三个说话人的LibriMix和LibriSpeechMix数据集(英语)上均取得领先性能,并且在AishellMix(普通话)上的zero shot多说话人语音识别性能令人满意。

 语音小管家