
 语音小管家
武汉大学、昆山杜克大学、中科院声学所、OfSpectrum与AISHELL联合发布的MIIP-NV数据集,旨在填补中文语音合成领域非语言语音(NV)合成开源数据的空白。这一数据集为情感语音合成领域提供了强有力的支持!🎉🎉
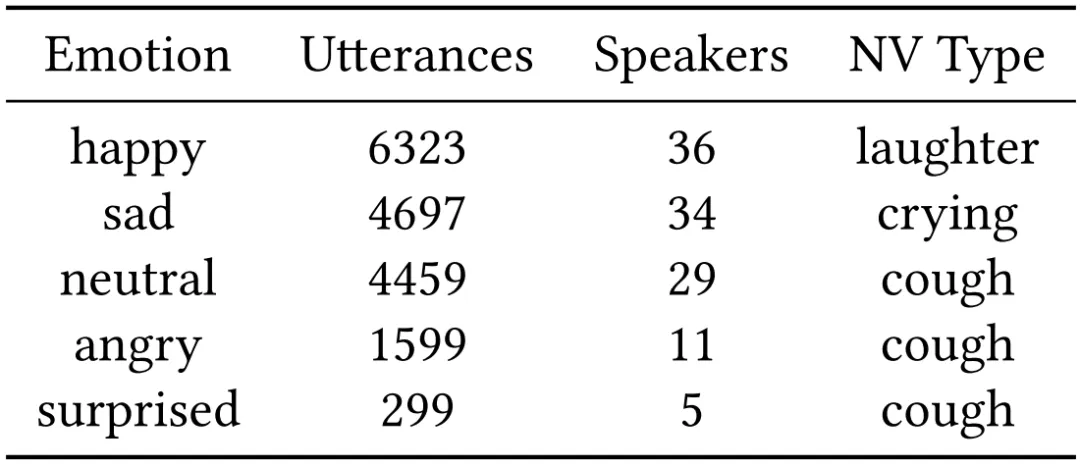
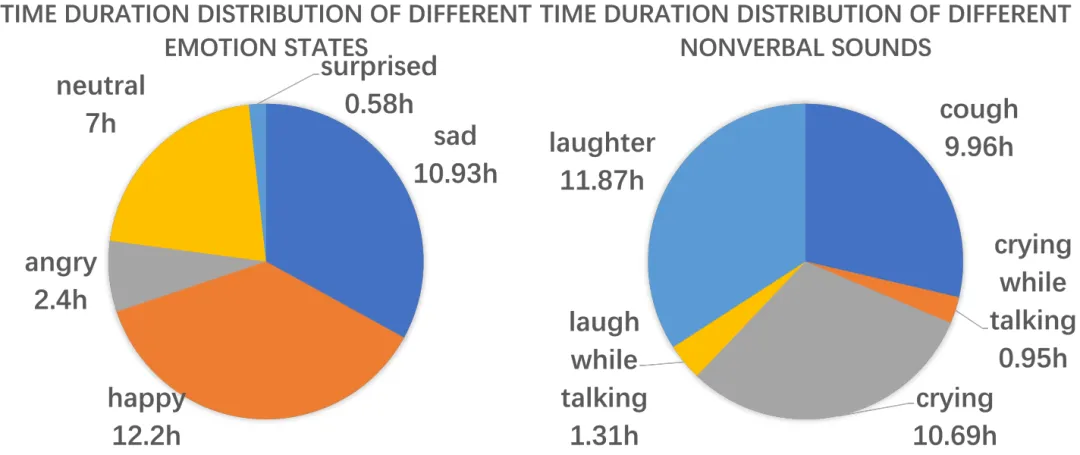
该数据集包含超过33小时的高质量普通话有版权语音数据,每个录音者都签署了版权协议,数据集覆盖5种情感状态(快乐、悲伤、愤怒、惊讶、中性)和三种常见的非语言语音类型(笑声、哭声、咳嗽)。每个非语言语音事件都得到了精准的时间戳和详细的标注,确保可以进行高精度的语音合成和情感建模。
数据集详情:
总时长:33小时
说话人数量:37位
情感标注:快乐、悲伤、愤怒、惊讶、冷静
非语言语音类型:笑声(6161条)、哭声(4611条)、咳嗽(6348条)
语音数据包含多种自然对话场景,确保捕捉到情感表达和非语言声音的丰富性。
与现有的语音合成数据集(如MLS、Libri-Light等)相比,在非语言语音的合成方面,SMIIP-NV提供了多种情感状态下的非语言声音,让模型能够学习如何在情感驱动的语音中加入笑声、哭声、咳嗽等非语言特征,从而提升语音合成的自然度和表现力。
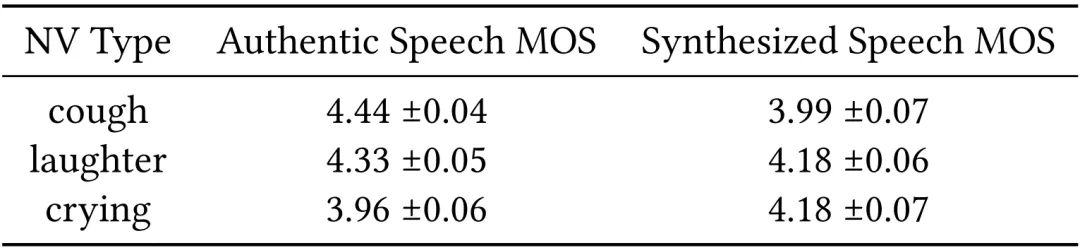
在合成模型方面,我们采用了轻量级的大语言模型(LLM)基准测试,使用SMIIP-NV数据集对模型进行了微调。通过这一过程,模型不仅能够生成清晰的语音,还能在情感表达和非语言语音的生成上表现出色。我们通过MOS评分(主观评估分数)对合成语音的自然度和情感传达能力进行了评估,结果表明,合成语音与真实语音的差距非常小。
SMIIP-NV数据集和相应的代码库已经开源,研究人员可以自由下载并使用该数据集进行进一步的语音合成研究。我们还为开源社区提供了基于该数据集微调后的CosyVoice2模型,支持实时演示和互动,您可以通过以下链接查看和体验模型生成的效果。
🔗SMIIP-NV数据集与演示:
🔗GitHub代码库与模型下载:https://huggingface.co/spaces/xunyi/SMIIP-NV_Finetuned_CosyVoice2
SMIIP-NV不仅为情感语音合成研究提供了一个全新的基准数据集,还为未来的多模态语音生成系统奠定了基础。随着更多模型的训练和优化,未来的语音合成系统将更加精准和富有表现力,能够在更多应用场景中自然地融入情感和非语言语音。
