
 语音小管家
音乐作为艺术表达的重要形式,蕴含深厚的文化内涵。近年来,随着深度学习技术的快速发展,音乐生成领域取得了显著进展。在众多方法中,非自回归框架因其高效生成能力备受关注。例如,音频语音与语言处理研究组(ASLP Lab)年初开源的DiffRhythm(谛韵)模型就在NAR框架内进行了大胆尝试。它利用扩散模型和连续表示的生成能力,能够在短短 10 秒内生成长达 4 分 45 秒的声乐与伴奏混合音轨完整歌曲。短短几天位列Hugging Face Space 趋势榜第一,Github星标 2K+。
10秒生成4分钟音乐,8GB显存就能跑!已登Hugging Face趋势榜一
然而,非自回归模型普遍面临一个棘手的难题:在生成长序列时,难以实现歌词与歌声之间的准确对齐。DiffRhythm 试图通过引入“句子级时间戳”作为条件来解决此问题,但这种方案显著降低了创作的自由度和多样性,并且对训练数据提出了更高的要求。针对上述挑战,ASLP Lab 音乐生成团队提出了 DiffRhythm 2——一种基于 Block Flow Matching 的开源端到端音乐生成框架。
该模型创新性地采用半自回归架构,在保持NAR模型高效生成能力的同时,有效解决了歌词与歌声的对齐难题,且无需依赖外部标签或约束条件。为进一步提升长序列生成的可计算性,DiffRhythm 2 还引入了音乐变分自编码器(VAE),能够在5Hz的低帧率条件下仍实现高保真音频重建。此外,为满足多样化音乐偏好,通常需要引入基于人类反馈的强化学习(RLHF)。但现有方法在进行多偏好优化时往往依赖多模型融合,导致性能明显下降。为克服这一性能退化问题,团队提出“交叉对偏好优化”方法,显著缓解了模型融合带来的性能损失,从而更好地适配多样化的人类音乐偏好。
DiffRhythm 2 融合了非自回归模型的高效性与自回归模型的长序列对齐能力,为高质量、全长度歌曲的自动生成提供了新的解决方案。目前该模型已经开源,技术报告已公开。现对DiffRhythm 2的方案进行解读。
作者列表:姜月鹏,陈华康,宁子谦,姚继珣,韩泽瑞,吴迪,孟猛,栾剑,付中华,谢磊†
Demo:https://aslp-lab.github.io/DiffRhythm2.github.io/
论文地址:https://arxiv.org/pdf/2510.22950
Source Code:https://github.com/ASLP-lab/DiffRhythm2
HuggingFace:https://huggingface.co/spaces/ASLP-lab/DiffRhythm2
区块流匹配(Block Flow Matching)
虽然基于流匹配(Flow Matching)的非自回归模型拥有出色的生成速度,但难以处理长序列歌词对齐。DiffRhythm 2 提出了创新性的Block Flow Matching机制:
将整首歌划分为若干区块;
每个区块内部并行生成,区块之间以自回归的方式进行生成;
不依赖外部约束或时间戳,也能自然实现歌词与旋律的精准对齐。
这种设计让模型既保留了非自回归的速度优势,又获得了自回归的超强的长序列对齐能力,实现了“快而稳”的生成效果。
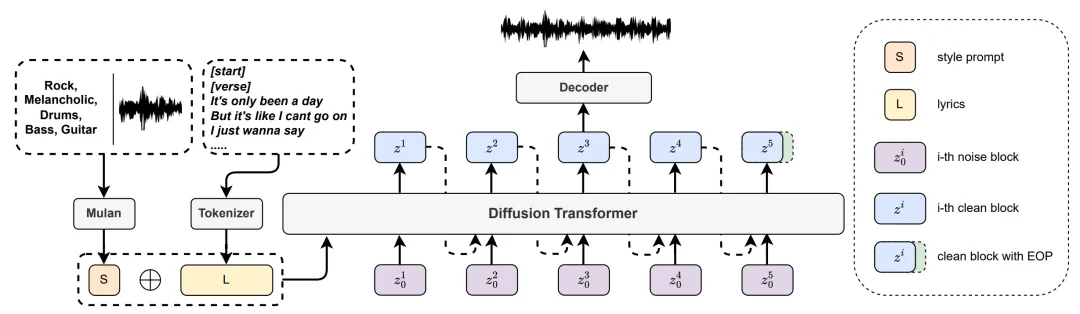
图1 DiffRhythm 2整体结构
随机区块特征对齐损失(Stochastic Block REPA Loss)
为了让模型理解音乐结构(比如主歌、副歌、情绪变化等),利用Block Flow Matching的训练特点为自回归训练引入随机区块表示对齐损失。在训练时随机抽取不同音乐片段进行特征对齐,让模型学习到歌曲结构性与连贯性,生成的作品听起来更具层次感。
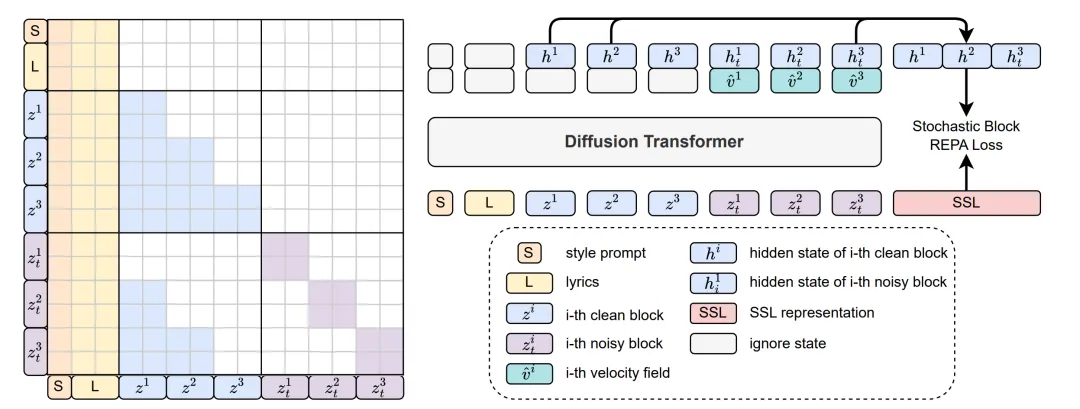
图2 DiffRhythm 2训练细节 左侧为训练中使用的注意力掩码
跨偏好对齐优化(Cross-Pair Preference Optimization)
AI写歌不仅要“准”,还要“好听”。但优化“音质”“风格”“歌词贴合”“音乐性”等多个维度时,常常会互相拉扯。 DiffRhythm 2 提出“跨偏好配对优化”策略:
将互补的偏好(如“音乐性”与“歌词对齐”)成对训练;
通过成对优化,兼顾多个维度的表现,不再需要多个模型融合。
这一策略让DiffRhythm 2在“人类喜好优化”(RLHF)上更高效、更稳定。
极低帧率的音乐VAE
由于Block Flow Matching极大增长了训练序列,为提升训练效率,DiffRhythm 2 设计了一个5Hz 超低帧率的音乐VAE。在保持音质的同时将序列压缩上千倍,让180秒长曲的生成成为可能。搭配 BigVGAN 解码器重建高保真音频,支持 48kHz 重建。
实验配置
训练集:约7万小时,140 万首歌(中英文+纯音乐,比例 4 : 5 : 1)。
预处理:使用Audiobox-Aesthetics[1] 过滤音质;Whisper与FireRedASR[2] 双重转录校对歌词;All-in-One[3] 与Qwen 2.5 Omni[4] 标注结构、风格、乐器、情感四个维度。
测试集:50 首真实歌词 + 50 首AI生成歌词。每首歌词随机匹配 3 种风格提示(文本或音频),共 300 条测试样本。
实验结果
在客观评估中,我们计算音素错误率(PER)来评估歌词准确率。为了评估风格控制能力,我们分别在文本(Mulan-T)和音频(Mulan-A)上使用MuQ-Mulan [5] 模型计算风格相似度。此外我们使用Audiobox-Aesthetics评估音频质量,使用SongEval [6] 模型评估生成音乐的质量。
表1:客观实验结果
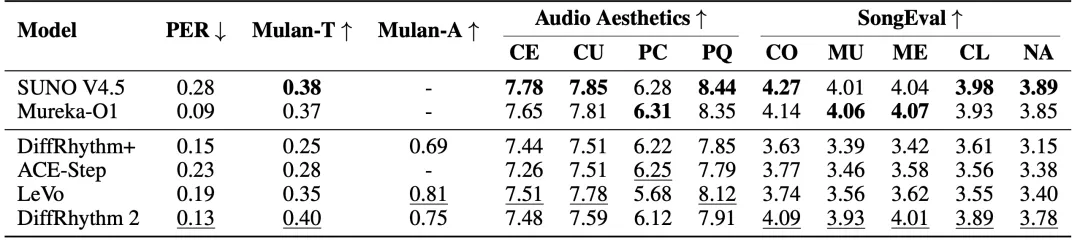
从表 1 可以看出,DiffRhythm 2 在各项音乐质量指标上均显著优于其他开源模型。然而,在音乐性等方面,它与商业系统(如 SUNO V4.5)相比仍存在一定差距。在音频质量上,DiffRhythm 2 略低于 LeVo [7],但依然领先于大多数其他模型。这一结果表明,在歌声重建中采用较低帧率是可行的,但由于重建负担加大,仍难以实现出色的重建效果。DiffRhythm 2 在Mulan-T(0.40)和PER(0.13)指标上均取得了最高分,远超其他模型。然而,它的Mulan-A得分略低于 LeVo 等系统。我们认为,这主要源于模型在设计上采用了全局音频风格建模的策略,无法充分捕捉歌曲中丰富的风格细节。
表2:主观实验结果
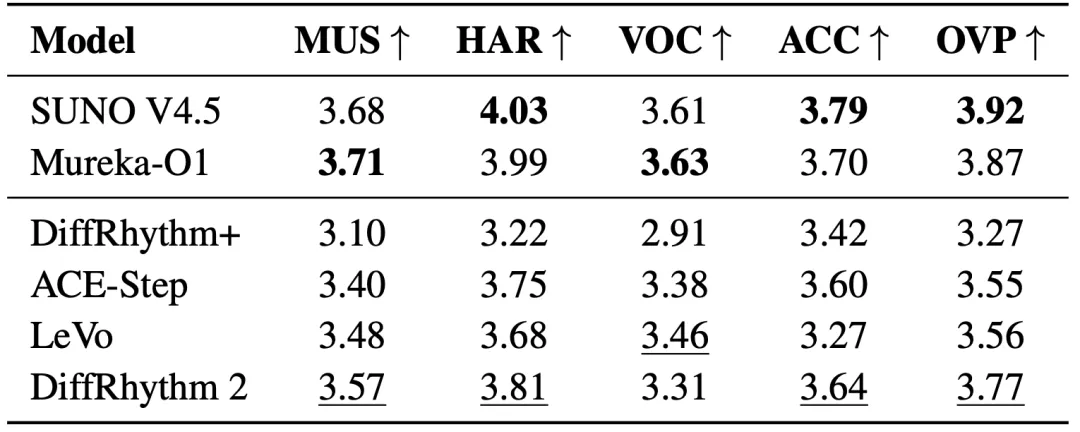
我们分别在音乐性(MUS)、人声伴奏和谐度(HAR)、人声质量(VOC)、伴奏质量(ACC)和整体质量(OVP)五个方面进行平均意见得分 (MOS) 主观听力测试。
如表 2 所示,DiffRhythm 2 在音乐性、人声与伴奏和谐度以及整体质量方面均显著优于其他开源模型。其伴奏生成效果与 ACE-Step [8] 相当,且远超 LeVo,这表明连续表征的引入能够有效提升伴奏生成质量。然而,在人声质量方面,由于系统未引入语义约束,也未对人声轨道进行独立建模,因此略低于 ACE-Step 和 LeVo。
表3:消融实验结果
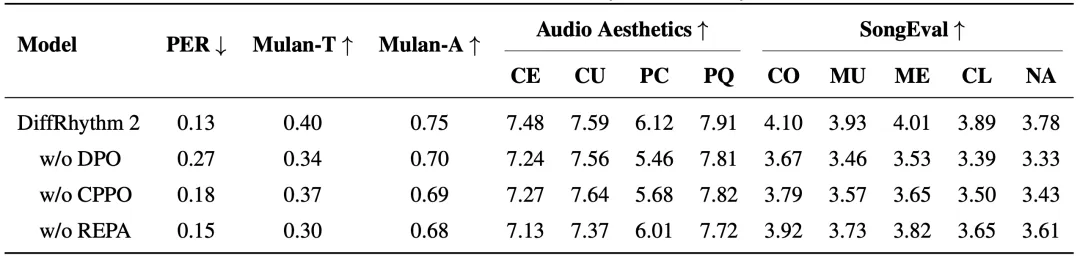
为验证所提出方法的有效性,我们进行了针对随机区块特征对齐损失和跨样本偏好优化(CPPO)的消融实验。在去除跨样本偏好优化(w/o CPPO)的实验中,我们针对四种偏好分别进行 DPO 训练,然后再合并模型;在去除随机块特征对齐损失(w/o REPA)的实验中,我们直接在训练中移除了相应的损失。此外,我们还进行了不使用任何 DPO(w/o DPO)的对照实验。
如表 3 所示,去除 REPA 损失会导致 SongEval 分数显著下降。主观测试进一步表明,音乐结构出现明显错位,甚至完全混乱。类似地,在缺少跨样本偏好优化时,各项评价指标相比 DiffRhythm 2 都有明显下降。
表4:模型结构与实时率对比
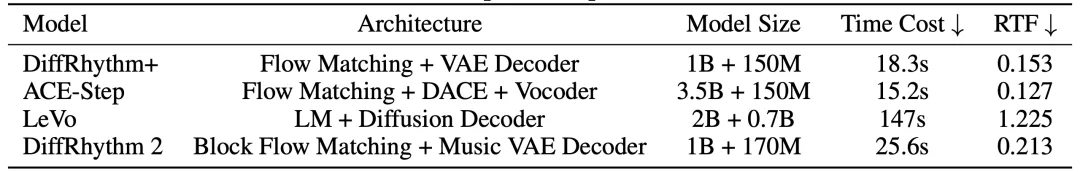
我们对 LeVo、Yue、DiffRhythm+ [9] 和 DiffRhythm 2 的生成速度进行了比较。为保证公平性,所有模型均被要求生成固定长度为两分钟的音频序列,不考虑生成质量差异。在 DiffRhythm+ 和 DiffRhythm 2 中,采样步数均设为 32。
如表 4 所示,DiffRhythm 2 的生成速度仅略慢于 DiffRhythm+ 和 ACE-Step,但显著快于 LeVo。值得注意的是,DiffRhythm+ 并未采用任何注意力加速框架,这也是其模型规模更小,却仍比 ACE-Step 更慢的原因。ACE-Step 使用线性注意力(Linear Attention)来降低计算复杂度;LeVo 采用Flash Attention v2,而DiffRhythm 2 则引入了Flex Attention实现高效加速。
[1] Andros Tjandra, Yi-Chiao Wu, Baishan Guo, John Hoffman, Brian Ellis, Apoorv Vyas, Bowen Shi, Sanyuan Chen, Matt Le, Nick Zacharov, et al. Meta audiobox aesthetics: Unified automatic quality assessment for speech, music, and sound. arXiv preprint arXiv:2502.05139, 2025.
[2] Kai-Tuo Xu, Feng-Long Xie, Xu Tang, and Yao Hu. Fireredasr: Open-source industrial-grade mandarin speech recognition models from encoder-decoder to llm integration. arXiv preprint arXiv:2501.14350, 2025b.
[3] Taejun Kim and Juhan Nam. All-in-one metrical and functional structure analysis with neighborhood attentions on demixed audio. In 2023 IEEE Workshop on Applications of Signal Processing to Audio and Acoustics (WASPAA), pp. 1–5. IEEE, 2023.
[4] Jin Xu, Zhifang Guo, Jinzheng He, Hangrui Hu, Ting He, Shuai Bai, Keqin Chen, Jialin Wang, Yang Fan, Kai Dang, et al. Qwen2. 5-omni technical report. arXiv preprint arXiv:2503.20215, 2025a.
[5] Haina Zhu, Yizhi Zhou, Hangting Chen, Jianwei Yu, Ziyang Ma, Rongzhi Gu, Yi Luo, Wei Tan, and Xie Chen. Muq: Self-supervised music representation learning with mel residual vector quantization. arXiv preprint arXiv:2501.01108, 2025.
[6] Jixun Yao, Guobin Ma, Huixin Xue, Huakang Chen, Chunbo Hao, Yuepeng Jiang, Haohe Liu, Ruibin Yuan, Jin Xu, Wei Xue, et al. Songeval: A benchmark dataset for song aesthetics evaluation. arXiv preprint arXiv:2505.10793, 2025.
[7] Shun Lei, Yaoxun Xu, Zhiwei Lin, Huaicheng Zhang, Wei Tan, Hangting Chen, Jianwei Yu, Yixuan Zhang, Chenyu Yang, Haina Zhu, et al. Levo: High-quality song generation with multi-preference alignment. arXiv preprint arXiv:2506.07520, 2025.
[8] Junmin Gong, Sean Zhao, Sen Wang, Shengyuan Xu, and Joe Guo. Ace-step: A step towards music generation foundation model. arXiv preprint arXiv:2506.00045, 2025.
[9] Huakang Chen, Yuepeng Jiang, Guobin Ma, Chunbo Hao, Shuai Wang, Jixun Yao, Ziqian Ning, Meng Meng, Jian Luan, and Lei Xie. Diffrhythm+: Controllable and flexible full-length song generation with preference optimization. arXiv preprint arXiv:2507.12890, 2025.
