
 语音小管家
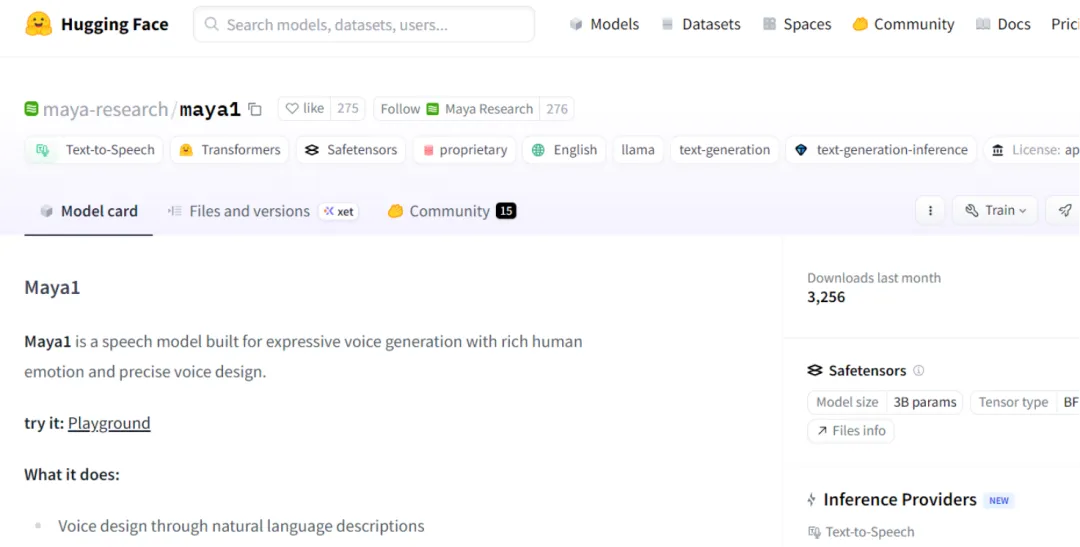
Hugging Face:https://huggingface.co/maya-research/maya1
⏩项目概述
Maya1是一个开源的AI语音合成模型,基于30亿参数的Transformer架构和SNAC神经编解码器,能够通过自然语言描述生成具有特定情感和特征的语音。它支持20多种情绪表达,如大笑、哭泣、叹气等,并且可以实时流式传输音频,适用于游戏配音、播客制作、语音助手开发等多种场景。
⏩核心功能
自然语言声音设计:用户可以通过简单的自然语言描述(如“30岁美国女性,声音温柔,语气真诚”)定义声音特征,无需复杂的参数调整。这种设计方式极大地降低了声音设计的门槛,使得非专业人士也能轻松创建符合需求的声音。
丰富的情绪表达:Maya1支持20多种情绪表达,如大笑(laugh)、哭泣(cry)、叹气(sigh)等。通过在文本中添加情绪标签(如``),用户可以精准地控制语音中的情绪表达,让语音更具表现力和感染力。
实时流式传输:采用SNAC神经编解码器,Maya1能够支持低延迟(约100毫秒)的实时音频生成。这一特性使其非常适合语音助手、游戏对话等需要即时反馈的场景,能够为用户提供流畅的语音交互体验。
高效部署:基于30亿参数的轻量级Transformer架构,Maya1可以在单GPU上运行。同时,它支持vLLM推理框架,能够有效降低推理成本,适合高并发场景,为企业和个人开发者提供了高效、经济的部署选择。
完全开源:采用 Apache 2.0 协议,可自由修改、商用和分发。 这意味着你可以直接将它整合进自己的产品,而无需担心版权或计费问题。
⏩技术原理
1、架构
Maya1基于30亿参数的Transformer架构,类似于Llama。它通过生成SNAC编解码器的音频token序列,而不是直接生成波形,从而实现了高效的语音合成。
2、SNAC编解码器
SNAC编解码器通过多尺度分层压缩(约12Hz/23Hz/47Hz),将音频高效编码为7-token帧。这种编码方式不仅降低了码率(约0.98kbps),还保证了音频的高质量输出。
3、训练过程
Maya1的预训练使用了大规模英文语音数据,涵盖了多种口音和语速。基于录音棚级语音样本,标注了20多种情绪和身份标签,使得模型能够生成具有丰富情感和多样特征的语音。
4、声音描述
Maya1采用XML属性式自然语言描述(如`
5、推理优化
支持vLLM引擎集成,结合自动前缀缓存(APC)机制,显著降低了重复生成的计算成本。同时,兼容WebAudio环形缓冲,便于浏览器端实时播放,进一步提升了模型的实用性和灵活性。
⏩应用场景
1、游戏开发
在游戏开发中,Maya1可以为游戏角色生成带情绪的对话,增强游戏的沉浸感。例如,让NPC在对话中带有冷笑或愤怒情绪,使玩家更容易投入到游戏情节中。
2、播客与有声书
对于播客和有声书制作,Maya1能够自动配音,支持多角色对话和情感表达。这不仅可以节省专业配音演员的成本,还能提升内容的吸引力,为听众带来更加丰富的情感体验。
3、AI语音助手
通过打造自然、富有情感的语音交互体验,Maya1让语音助手在回应时能表达同情、喜悦等情绪,从而更好地满足用户的情感需求,提高用户对语音助手的满意度和依赖度。
4、短视频创作
在短视频创作中,Maya1可以快速生成带情绪的旁白,提升视频的表达力和观众的沉浸感,帮助创作者更好地传达视频内容和情感。
5、无障碍应用
Maya1还可以用于无障碍应用,让屏幕阅读器用温暖、自然的声音帮助视障人士更好地理解内容,为视障人士提供更加人性化和便捷的信息获取方式。
⏩快速使用
(一)模型下载
从Hugging Face模型库中下载Maya1模型。
Make sure git-lfs is installed (https://git-lfs.com)
git lfs install
git clone https://huggingface.co/maya-research/maya1
(二)使用示例
#!/usr/bin/env python3
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from snac import SNAC
import soundfile as sf
import numpy as np
CODE_START_TOKEN_ID = 128257
CODE_END_TOKEN_ID = 128258
CODE_TOKEN_OFFSET = 128266
SNAC_MIN_ID = 128266
SNAC_MAX_ID = 156937
SNAC_TOKENS_PER_FRAME = 7
SOH_ID = 128259
EOH_ID = 128260
SOA_ID = 128261
BOS_ID = 128000
TEXT_EOT_ID = 128009
def build_prompt(tokenizer, description: str, text: str) -> str:
    """Build formatted prompt for Maya1."""
    soh_token = tokenizer.decode([SOH_ID])
    eoh_token = tokenizer.decode([EOH_ID])
    soa_token = tokenizer.decode([SOA_ID])
    sos_token = tokenizer.decode([CODE_START_TOKEN_ID])
    eot_token = tokenizer.decode([TEXT_EOT_ID])
    bos_token = tokenizer.bos_token
    formatted_text = f'<description="{description}"> {text}'
    prompt = (
        soh_token + bos_token + formatted_text + eot_token +
        eoh_token + soa_token + sos_token
    )
    return prompt
def extract_snac_codes(token_ids: list) -> list:
    """Extract SNAC codes from generated tokens."""
    try:
        eos_idx = token_ids.index(CODE_END_TOKEN_ID)
    except ValueError:
        eos_idx = len(token_ids)
    snac_codes = [
        token_id for token_id in token_ids[:eos_idx]
        if SNAC_MIN_ID <= token_id <= SNAC_MAX_ID
    ]
    return snac_codes
def unpack_snac_from_7(snac_tokens: list) -> list:
    """Unpack 7-token SNAC frames to 3 hierarchical levels."""
    if snac_tokens and snac_tokens[-1] == CODE_END_TOKEN_ID:
        snac_tokens = snac_tokens[:-1]
    frames = len(snac_tokens) // SNAC_TOKENS_PER_FRAME
    snac_tokens = snac_tokens[:frames * SNAC_TOKENS_PER_FRAME]
    if frames == 0:
        return [[], [], []]
    l1, l2, l3 = [], [], []
    for i in range(frames):
        slots = snac_tokens[i*7:(i+1)*7]
        l1.append((slots[0] - CODE_TOKEN_OFFSET) % 4096)
        l2.extend([
            (slots[1] - CODE_TOKEN_OFFSET) % 4096,
            (slots[4] - CODE_TOKEN_OFFSET) % 4096,
        ])
        l3.extend([
            (slots[2] - CODE_TOKEN_OFFSET) % 4096,
            (slots[3] - CODE_TOKEN_OFFSET) % 4096,
            (slots[5] - CODE_TOKEN_OFFSET) % 4096,
            (slots[6] - CODE_TOKEN_OFFSET) % 4096,
        ])
    return [l1, l2, l3]
def main():
    Load the best open source voice AI model
    print("\n[1/3] Loading Maya1 model...")
    model = AutoModelForCausalLM.from_pretrained(
        "maya-research/maya1",
        torch_dtype=torch.bfloat16,
        device_map="auto",
        trust_remote_code=True
    )
    tokenizer = AutoTokenizer.from_pretrained(
        "maya-research/maya1",
        trust_remote_code=True
    )
    print(f"Model loaded: {len(tokenizer)} tokens in vocabulary")
    Load SNAC audio decoder (24kHz)
    print("\n[2/3] Loading SNAC audio decoder...")
    snac_model = SNAC.from_pretrained("hubertsiuzdak/snac_24khz").eval()
    if torch.cuda.is_available():
        snac_model = snac_model.to("cuda")
    print("SNAC decoder loaded")
    Design your voice with natural language
    description = "Realistic male voice in the 30s age with american accent. Normal pitch, warm timbre, conversational pacing."
    text = "Hello! This is Maya1 <laugh_harder> the best open source voice AI model with emotions."
    print("\n[3/3] Generating speech...")
    print(f"Description: {description}")
    print(f"Text: {text}")
    Create prompt with proper formatting
    prompt = build_prompt(tokenizer, description, text)
    Debug: Show prompt details
    print(f"\nPrompt preview (first 200 chars):")
    print(f"   {repr(prompt[:200])}")
    print(f"   Prompt length: {len(prompt)} chars")
    Generate emotional speech
    inputs = tokenizer(prompt, return_tensors="pt")
    print(f"   Input token count: {inputs['input_ids'].shape[1]} tokens")
    if torch.cuda.is_available():
        inputs = {k: v.to("cuda") for k, v in inputs.items()}
    with torch.inference_mode():
        outputs = model.generate(
            **inputs,
            max_new_tokens=2048,  Increase to let model finish naturally
            min_new_tokens=28,  At least 4 SNAC frames
            temperature=0.4,
            top_p=0.9,
            repetition_penalty=1.1,  Prevent loops
            do_sample=True,
            eos_token_id=CODE_END_TOKEN_ID,  Stop at end of speech token
            pad_token_id=tokenizer.pad_token_id,
        )
    Extract generated tokens (everything after the input prompt)
    generated_ids = outputs[0, inputs['input_ids'].shape[1]:].tolist()
    print(f"Generated {len(generated_ids)} tokens")
    Debug: Check what tokens we got
    print(f"   First 20 tokens: {generated_ids[:20]}")
    print(f"   Last 20 tokens: {generated_ids[-20:]}")
    Check if EOS was generated
    if CODE_END_TOKEN_ID in generated_ids:
        eos_position = generated_ids.index(CODE_END_TOKEN_ID)
        print(f" EOS token found at position {eos_position}/{len(generated_ids)}")
    Extract SNAC audio tokens
    snac_tokens = extract_snac_codes(generated_ids)
    print(f"Extracted {len(snac_tokens)} SNAC tokens")
    Debug: Analyze token types
    snac_count = sum(1 for t in generated_ids if SNAC_MIN_ID <= t <= SNAC_MAX_ID)
    other_count = sum(1 for t in generated_ids if t < SNAC_MIN_ID or t > SNAC_MAX_ID)
    print(f"   SNAC tokens in output: {snac_count}")
    print(f"   Other tokens in output: {other_count}")
    Check for SOS token
    if CODE_START_TOKEN_ID in generated_ids:
        sos_pos = generated_ids.index(CODE_START_TOKEN_ID)
        print(f"   SOS token at position: {sos_pos}")
    else:
        print(f"   No SOS token found in generated output!")
    if len(snac_tokens) < 7:
        print("Error: Not enough SNAC tokens generated")
        return
    Unpack SNAC tokens to 3 hierarchical levels
    levels = unpack_snac_from_7(snac_tokens)
    frames = len(levels[0])
    print(f"Unpacked to {frames} frames")
    print(f"   L1: {len(levels[0])} codes")
    print(f"   L2: {len(levels[1])} codes")
    print(f"   L3: {len(levels[2])} codes")
    Convert to tensors
    device = "cuda" if torch.cuda.is_available() else "cpu"
    codes_tensor = [
        torch.tensor(level, dtype=torch.long, device=device).unsqueeze(0)
        for level in levels
    ]
    Generate final audio with SNAC decoder
    print("\n[4/4] Decoding to audio...")
    with torch.inference_mode():
        z_q = snac_model.quantizer.from_codes(codes_tensor)
        audio = snac_model.decoder(z_q)[0, 0].cpu().numpy()
    Trim warmup samples (first 2048 samples)
    if len(audio) > 2048:
        audio = audio[2048:]
    duration_sec = len(audio) / 24000
    print(f"Audio generated: {len(audio)} samples ({duration_sec:.2f}s)")
    Save your emotional voice output
    output_file = "output.wav"
    sf.write(output_file, audio, 24000)
    print(f"\nVoice generated successfully!")
if __name__ == "__main__":
    main()
⏩结语
Maya1作为一款开源的AI语音合成模型,凭借其自然语言声音设计、丰富的情绪表达、实时流式传输和高效部署等核心功能,为语音合成领域带来了新的突破和创新。它在游戏开发、播客与有声书制作、AI语音助手、短视频创作以及无障碍应用等多个场景中具有广泛的应用前景,有望为用户和开发者提供更加丰富、自然和情感化的语音交互体验。
