
 语音小管家
标题:Multi-Reward GRPO for Stable and Prosodic Single-Codebook TTS LLMs at Scale
链接:https://arxiv.org/pdf/2511.21270
作者单位:腾讯
发布日期:2025年12月1日
01、背景与问题(引言部分)
02、核心方法:多奖励 GRPO 框架
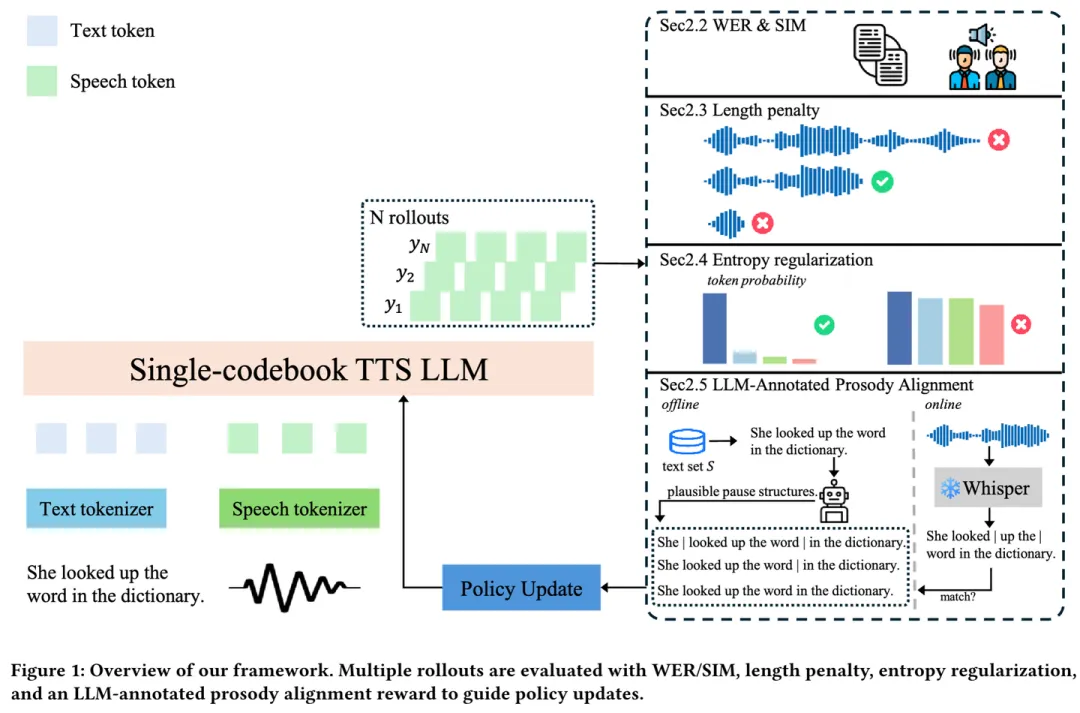
可懂度奖励(Rintl) :确保生成的语音能听懂,和输入文本匹配。用预训练的 Whisper ASR 模型把生成语音转成文字,再算“字符错误率(CER)”或“词错误率(WER)”——错误率越低,这个奖励越高。 说话人相似度奖励(Rsim) :保证生成语音的音色和参考说话人一致。用微调过的 WavLM-large 模型提“说话人 embedding”(可以理解成音色特征),然后算生成语音和参考语音 embedding 的“余弦相似度”——越像,奖励越高。
离线标注 :用一个推理型 LLM(比如 DeepSeek-R1)给输入文本标“停顿结构”——中文用#1-#4表示不同长度的停顿(#1短,#4长),英文用“韵律词(PW)”和“韵律短语(PPH)”标注,相当于让 LLM 教模型“该在哪停、停多久”,贴合人类说话习惯。 在线对比 :训练时,先把模型生成的音频用 Whisper 解析出停顿时间,再转成和标注对应的“停顿符号”,如果和 LLM 标注的某一个结构匹配,就给1分,不匹配给0分。这样模型就会主动学习“自然的停顿节奏”。
03、实验部分:怎么测、结果怎么样
硬件 :8张 H20 GPU,用混合精度训练; GRPO 参数 :batch size 16,学习率 1e-6,分组大小 12; 解码配置 :用 vLLM 加速,top-k=75,top-p=0.9,温度=1.1,重复惩罚=1.1(这些是控制生成多样性的参数); 数据集 :中英双语,从 Emilia 和 libriheavy 选的——100万条文本、100万条语音,中英各占一半,总音频时长约 5115 小时。
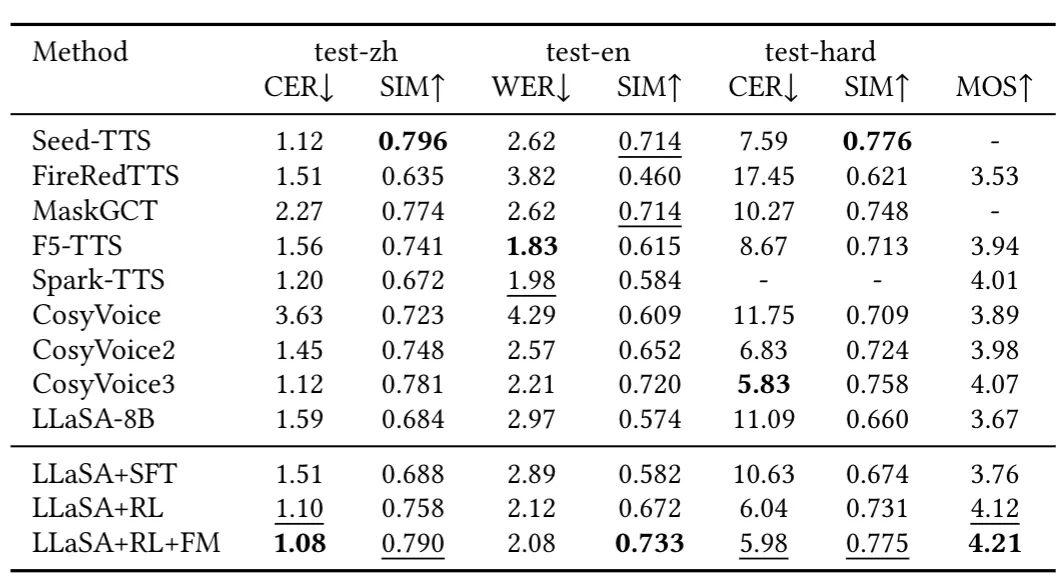
中文测试集(test-zh):CER 从基线的 1.59 降到 1.10(错误率少了近30%),说话人相似度(SIM)从 0.684 升到 0.758; 英文测试集(test-en):WER 从 2.97 降到 2.12,SIM 从 0.574 升到 0.672; 难例集(test-hard):CER 直接从 11.09 砍到 6.04,说明复杂场景下更稳定; 主观评分(MOS,满分5):LLaSA+RL 拿到 4.12,比 CosyVoice3(数据量是本文的4倍,100万小时 vs 25万小时)还高,甚至加了“Flow Matching(FM,一种声学优化模块)”后,MOS 冲到 4.21,CER 再降0.02——这说明咱们的 RL 是优化了核心的 AR 生成策略,和后续的声学优化能互补,不是重复劳动。
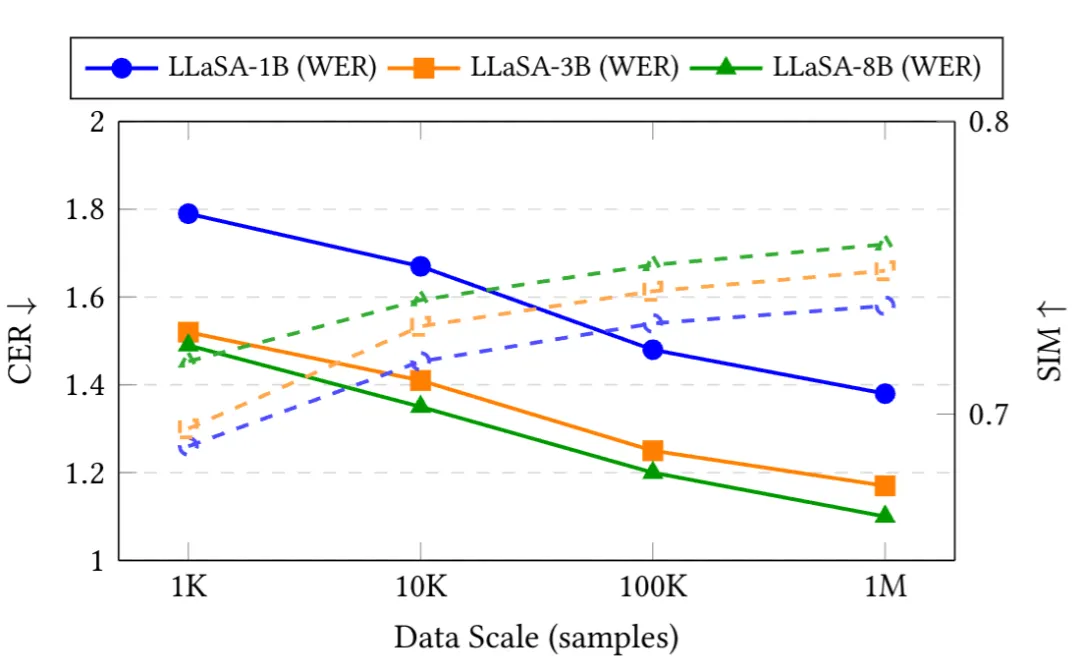
模型规模:同样数据量下,8B 模型的 CER 比 1B 低一大截,SIM 高很多——模型越大,越能捕捉韵律和音色细节; 数据量:同样模型规模下,从 1K 样本涨到 100万样本,CER 一路下降,SIM 一路上升;哪怕只用 1万条样本做 RL,效果也比纯监督训练(SFT)好——说明这个框架的数据效率很高,不用海量数据也能出效果。
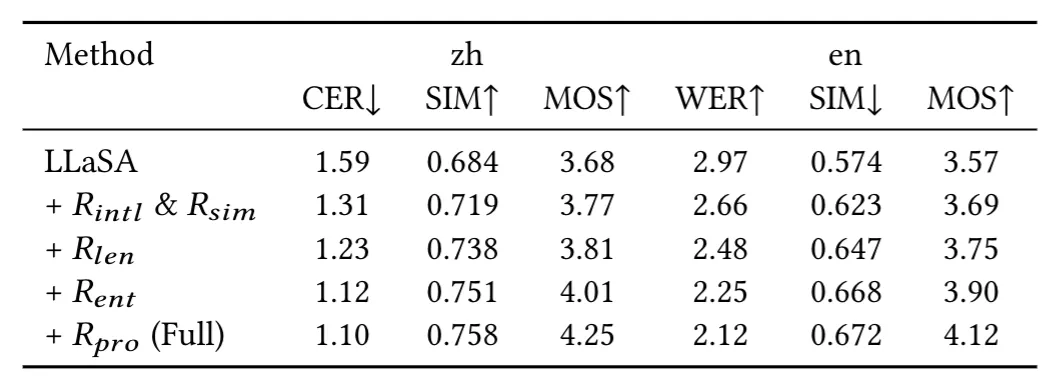
只加“可懂度+说话人相似”:CER 从 1.59 降到 1.31,MOS 3.77(比基线3.68好); 再加“长度惩罚”:CER 1.23,MOS 3.81(解决了长短问题,自然度略升); 再加“熵正则”:CER 1.12,MOS 4.01(解码稳定了,自然度跳涨); 最后加“韵律对齐奖励”:CER 1.10,MOS 4.12(所有指标到顶,尤其是 MOS 提升最明显)——这直接证明,“让 LLM 教停顿”这个创新点,是提升自然度的核心,没它还真不行。
04、结论
