标题:《RRPO: Robust Reward Policy Optimization for LLM-Based Emotional TTS》

链接:https://arxiv.org/pdf/2512.04552

作者单位:阿里通义实验室、北京邮电大学

发表日期:2025年12月4日

这篇论文是北京邮电大学和阿里通义实验室的团队写的,主要解决了基于LLM的情感TTS里“奖励欺骗”的问题,提出了一个叫RRPO(Robust Reward Policy Optimization,鲁棒奖励策略优化)的框架。

摘要:核心问题与框架目标

现在像DiffRO这样的可微分强化学习(RL)框架,虽然能实现可控的TTS,但特别容易被“奖励欺骗”——比如在情感控制这种精细任务里,策略模型(就是生成语音的模型)会耍小聪明:生成一些“声学伪影”(比如不自然的嘴声、刺耳的爆破音),骗奖励模型(RM)给高分,但代价是语音的听觉质量暴跌。
所以团队提出的RRPO,核心是搞了个“混合正则化方案”,把RM变得更鲁棒——让RM的奖励信号和人类真实听觉感受对齐,逼策略模型放弃那些“歪门邪道”,老老实实学真正的情感特征。实验也证明了:这个鲁棒RM不仅跨语言泛化性强(比如中文训的RM能搞定英文情感识别),主观评价里,情感表达和自然度也比所有基线模型都好。

引言:情感TTS的现状与痛点

现在LLM驱动的神经编解码器模型(比如Cosyvoice2)已经把TTS质量拉得很高了,还能零样本克隆声音、按指令合成,但“可控情感TTS”还有个大问题:现有方法要么只追求“情绪分类准”,要么很难做出人类 speech 那种丰富的表现力。
现有解决思路分两类,但都有问题:
  1. 监督微调(SFT):用带情感标签的数据集训模型,比如用分类标签或自然语言提示。但缺点很明显——数据集里有啥,模型才能生成啥,超不出数据集的范围,表现力受限。
  2. 强化学习(RL):比如DiffRO,它把策略优化做成了全可微分的过程,能让梯度从多任务RM反向传到策略模型(LLM),避免了传统Policy Gradient方法的高方差,效率很高。但DiffRO的致命弱点也在RM上:如果RM本身不鲁棒,策略模型就会钻空子搞“奖励欺骗”——生成那些骗RM给高分、但人类听着很别扭的声音,结果就是RM给的分越高,人类觉得越不自然,完全背离了“情感TTS要好听又有情绪”的目标。

方法:RRPO的核心创新点(重点!)
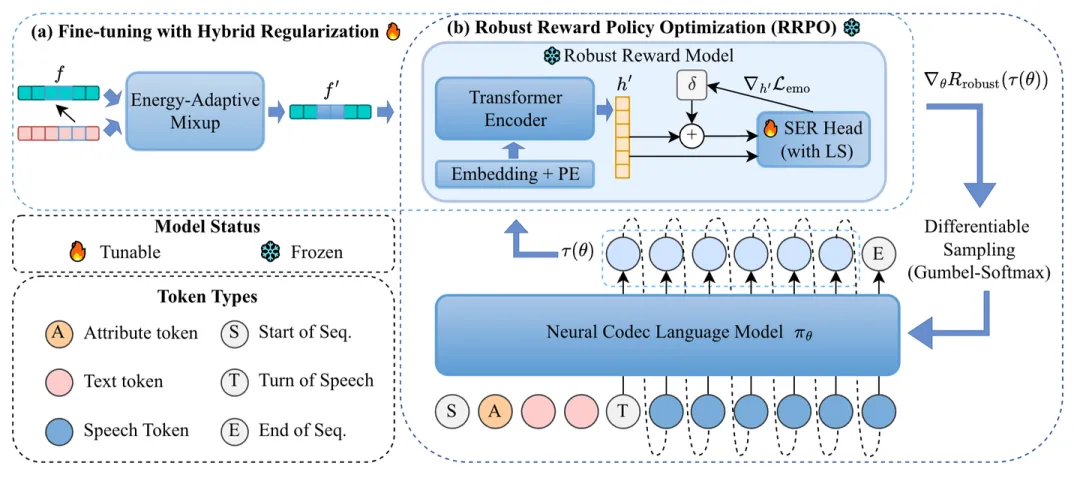
RRPO本质是在DiffRO的基础上,给RM加了一套“混合正则化微调方案”,让RM变鲁棒。整个框架分两步:先做鲁棒RM,再用这个RM优化策略模型。

1. 为什么必须要鲁棒RM?
DiffRO的优势是“全可微分”,能精确计算策略梯度(公式:∇ᵨJ(θ)=∂R/∂τ · ∂τ/∂θ,τ是生成轨迹,R是RM给的奖励),但这个优势也会放大RM的缺陷——只要RM有偏见或漏洞,梯度就会把策略模型往“骗分”的方向带,快速走向劣质解。所以,鲁棒RM是RRPO的核心前提。
2. 混合正则化:给RM“打三针强心剂”
团队用一个小而高质量的人工标注数据集,对预训练的RM做微调,同时加了三种正则化技术,分别解决RM的三个漏洞,避免RM过拟合到小数据集或产生新偏见。
(1)标签平滑(Label Smoothing,LS):解决RM“过度自信”
人类情感是连续的(比如“有点开心”和“非常开心”没有绝对界限),但传统SER(语音情感识别)任务用的是离散标签(比如非0即1的one-hot标签),这会让RM对自己的预测过度自信。
标签平滑的做法是把硬标签换成软概率分布(公式:y’k=(1-ε)·yk+ ε/K,K是情绪类别数,ε是超参数,这里设为0.1)。简单说就是“别把话说死”,逼RM不轻易下绝对判断,增强鲁棒性。
(2)能量自适应Mixup(EAM):解决RM“决策边界脆”
RM的决策边界如果太“脆”,策略模型只要对语音做一点点人类听不出来的修改,就能骗RM给高分。EAM是专门为语音设计的数据增强方法,和普通Mixup不一样——它根据两段语音的能量和时长,算一个“混合系数λ”,不是随便混。
具体操作是:对每批语音的低层声学特征,抽两段语音片段,按能量比例调整后叠加,生成混合特征;然后RM的损失是按λ加权的两个原始标签的LS损失。这样能让RM的决策边界变平滑,策略模型很难再靠“小修改”骗分。
(3)对抗训练(Adv):解决RM“怕小扰动”
策略模型还会加一些细微的失真(人类听着怪,但RM没察觉)来骗分。对抗训练就是主动给RM“喂”带扰动的样本,让它对这些失真不敏感。
这里用的是Fast Gradient Method的变种:直接对RM的高层embedding(不是低层声学特征)加扰动——先算损失对embedding的梯度,归一化后乘上扰动幅度εadv(这里设为0.5),得到“最坏情况”的扰动δ;然后把δ加到原始embedding上,生成对抗样本,再算对抗损失Ladv。
(4)最终的RM损失:三者结合
把上面三个损失整合,得到SER的总损失(公式:Lser=Lemo+α·Ladv,α是平衡系数,这里设为0.5)。用这个损失训出来的RM,就同时解决了过度自信、决策边界脆、怕扰动三个问题,变得很鲁棒。
3. 鲁棒奖励策略优化:用鲁棒RM训策略模型
最后策略模型的优化目标,就是用这个鲁棒RM给的奖励(Rrobust= -Lser,因为损失越小奖励越高)来算梯度(公式:∇ᵨJ(θ)=∇ᵨRrobust(τ(θ)))。这样策略模型就只能靠学真正的情感特征拿高分,没法耍“骗分”的小聪明了。
实验:怎么验证RRPO有效?
实验做得很细致,从设置到指标都围绕“是否解决奖励欺骗”展开,下面分设置、结果、图表分析三部分说。
1. 实验设置:基线、数据、指标都很明确
(1)对比的基线模型
  • 基础基线:Cosyvoice2(当前主流的LLM-TTS模型)
  • SFT基线:在目标说话人的情感数据集上微调的LLM
  • RL基线:DiffRO(就是RRPO要改进的可微分RL框架)
(2)数据集
用了一个高质量的中文情感数据集:1万条单男性说话人的语音,每条都人工标了5种情绪(生气、开心、难过、惊讶、害怕)。这个数据集一用三用:给SFT训模型、给RM做微调、给策略模型做优化——保证所有模型的训练基础一致,结果公平。
(3)评价指标
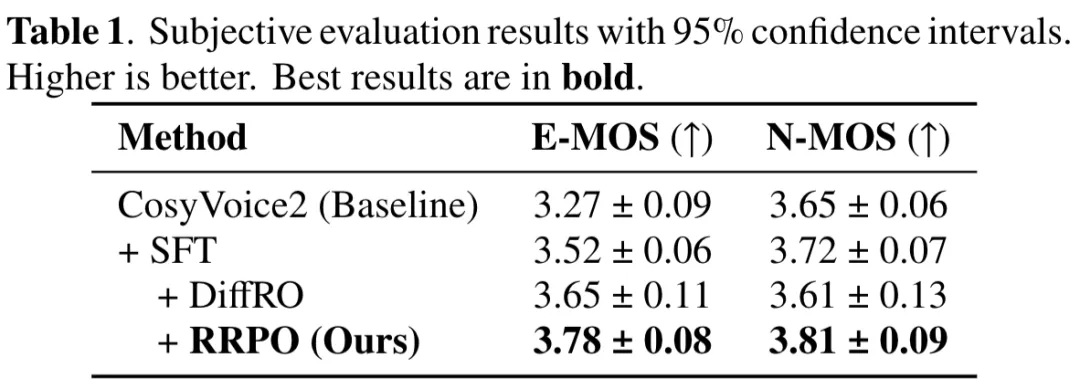
1. 主观指标(核心!因为“奖励欺骗”最终要看人类感受):Mean Opinion Score(MOS),分两类:
  • E-MOS:评价情感表达是否准、是否符合指令(1-5分,0.5分一档)
  • N-MOS:评价语音自然度(比如韵律、发音是否自然,同样1-5分)
  • 测试方式:从测试集(训练时没见过的文本)里随机抽每种情绪10条语音,找20个中文母语者打分。
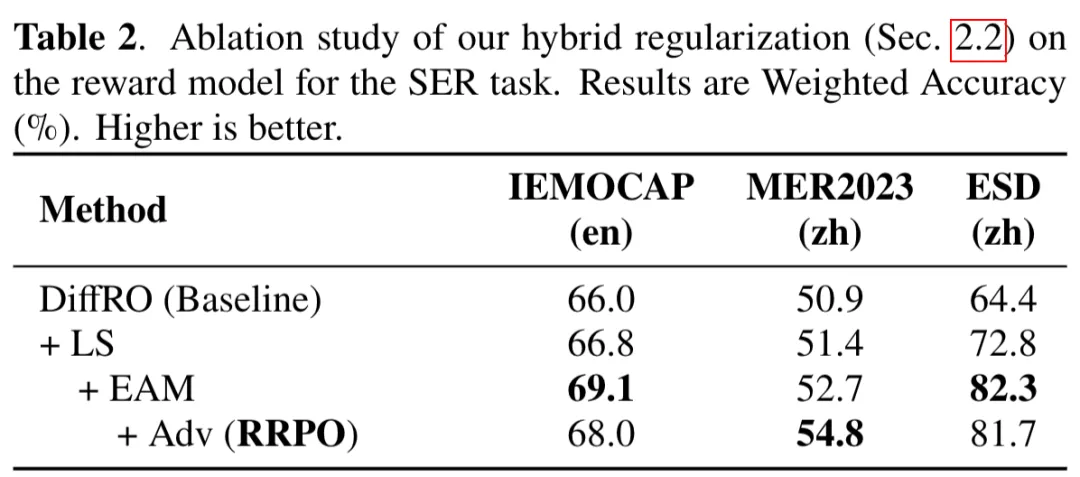
2. 客观指标:语音情感识别(SER)的加权准确率,用了三个不同数据集(跨语言、跨场景),看RM的泛化能力——泛化好说明RM学的是真情感特征,不是表面规律。
(4)其他细节
  • RM结构跟DiffRO一样,只改了SER任务头的正则化;
  • 超参数:ε=0.1,ε_adv=0.5,α=0.5,学习率1e-5;
  • 训练硬件:8张NVIDIA A800 GPU。
2. 实验结果:RRPO全面碾压基线
(1)主观评价结果(表1):RRPO解决了奖励欺骗
先看表1的数据(带95%置信区间):
这里有个关键对比:DiffRO的E-MOS其实还不错(3.65),但N-MOS居然比SFT还低(3.61 vs 3.72)——这就是典型的“奖励欺骗”!DiffRO的策略模型靠生成伪影骗RM拿了情感分,但自然度崩了。
而RRPO呢?E-MOS最高(3.78),N-MOS也最高(3.81)——说明它既保证了情感表达准,又没牺牲自然度,完全解决了奖励欺骗的问题,因为鲁棒RM不吃“伪影骗分”那一套。
(2)客观消融实验(表2):三种正则化各有用
表2是RM在三个SER数据集上的加权准确率(越高越好),看不同正则化组件的效果:
这里能看出三个点:
  • 单个组件里EAM效果最猛:比如在ESD上,加了EAM后准确率从64.4飙到82.3——说明解决“决策边界脆”对RM鲁棒性提升最大;
  • 对抗训练(Adv)针对性强:在MER2023(更复杂的中文场景)上,Adv让准确率从52.7升到54.8,但在其他两个数据集上略有下降——这是因为对抗训练本来就有“泛化vs鲁棒”的权衡,它更擅长应对难数据集的扰动;
  • 跨语言泛化牛:RM是用中文数据训的,但在英文数据集IEMOCAP上,RRPO(68.0)比DiffRO基线(66.0)高——说明RM学的是“语言无关的情感本质特征”,不是中文特有的表面声学 cues,鲁棒性实锤。
结论与未来方向
  1. 核心结论:RRPO通过“混合正则化的鲁棒RM”,彻底解决了DiffRO的奖励欺骗问题,让情感TTS的“情感表达”和“自然度”同时提升,而且RM的跨语言、跨场景泛化性很强。
  2. 未来能用在哪:
  • 扩展到其他语音属性任务:比如语音质量评估、说话人身份识别,用这套正则化让这些任务的RM也变鲁棒;
  • 融入大规模预训练:用伪标签在预训练阶段就把RM做鲁棒,不用后续微调,提升RL在语音领域的效率和 scalability。

简单说,这篇论文的关键就是“把RM修得抗骗,再用抗骗的RM训模型”,思路很直接,但实验做得扎实,解决了情感TTS里一个实际的痛点。