
 语音小管家
写在前面
回复整个2025年的TTS发展,可以看到一个非常明显的趋势就是:大模型正在重新构建语音合成的范式。遥想2023年年初,我还在思考如何基于fastspeech的框架来打磨各个module的细节来提升表现力,训练数据最多也就在数百小时的规模。而现如今,语音合成领域已经借助大模型的能力,实现了几乎接近真人的zero shot能力,与当年的"传统算法"时代相比,大模型时代下的TTS已经开始向更高阶的任务出发了。总结下来,我认为主要的关键词有三个:更高效、更拟人、更智能。
更高效
在此,"高效"这一词的含义我分为两个部分:tokenizer的压缩率、推理的延时。那么接下来,我就沿着这两个方向接着往下说说我的看法。
更高的压缩率
tokenizer最初在语音上的应用其实是语音通信领域,为了提高传输效率,所以需要在传输过程中需要对语音进行压缩以方便传输,然后再在接收端通过解压缩来还原出原始的语音信息。传统时代的典型代表工具是Opus,后来慢慢发展有了neural audio codec,如SounStream,Encodec, DAC等等。随着大模型在语音领域的应用,大家发现可以使用audio codec可以将语音离散化,这样就可以很自然地将LLM引入到语音任务中,所以现在audio codec才成为了语音领域一个非常重要的部分。
那么从上面的描述中,我们可以看到audio codec实际上扮演了两个重要的角色:
一是压缩,audio codec需要实现高效的压缩,这样对于同样长度的音频我们需要的token数量更少,这无疑会极大地提升LLM的推理效率。二是重建,模型需要对离散化后的token进行重建以得到语音,这就要求这个token里面不能丢失太多的信息,否则重建的难度就会大大加重。
这实际上是两相矛盾的:为了提升压缩效率难免会丢失掉一些信息,但丢失了信息之后就难以实现完美的重现。这个问题早在NaturalSpeech2这篇文章中就已经提出来了,那个时候的解决思路还是将建模目标从离散token转向连续向量,这个解决思路在现如今仍旧适用,并且也有了一些非常惊艳的工作——VibeVoice,这个我们暂时不详说。另一条路是仍旧以离散token为建模目标不变,对audio codec从量化方式、学习目标、模型结构等方面来进行优化。这里的细节非常多,说几个我觉得比较重要和典型的操作。
从建模目标这个角度来看,整体上分成semantic token和acoustic token为主。先说semantic token,这类通常采用单一码本,通过HuBert、Wav2Vec、Whisper等工具来提取语音中的语义信息,再结合vq\fsq等量化手段来得到semantic token。我对这类token的看法是好训又好推。因为语音中本就有非常多的冗余的信息,如果都拿给LLM来学习的话,就需要比较庞大的数据量,上百万小时来计。但如果只关注semantic token的话,对数据量的需求就会相对小一些。以CosyVoice系列为例,基本上在20万~30万小时的数据量的情况下,就可以得到一个差不多能够使用的模型了,当然还是可能会出现一些问题,比如重复、漏读等,但概率要小得多。好推的原因是这类码本就一层,基本就直接复用常规的LLM推理方式即可,这对后续的工程化落地也比较友好。但这类码本也存在一个比较重要的问题,那就是声学信息的损失,基本上都需要靠一个比较强大的speech decoder来补充声学信息,比如flow matching model,输入spepaker embedding和masked mel作为condition。但是这个也不能完全算作是缺点,其实这也从某种意义上来说实现了"声学"和"语义"的解耦,可以拿来做voice conversation任务。
而对于acoustic token而言,事情就不那么简单了。首先,以SoundStream、DAC为代表的基于RVQ的多码本audio codec,主要是以reconstruction loss为主,loss相对比较单一,多层码本之间的信息没有区分,多数信息会在第一层码本中集中存储。后来SpeechTokenizer、Mimi等工作提出将声学码本和语义码本分开建模,对于声学码本直接采用reconstruction loss来训练,对于语义码本通常采用以"SSL feature+聚类"为目标来训练,最新的QuarkAudio中提出的H-Codec也是这类做法。其实对于这里我自己一直觉得有点不合理,首先"SSL feature+聚类"能否精准表达语义这个事就很存疑,而且直接用reconstruction loss来提取声学码本也很难保证语义信息的解耦。反之,我认为基于多任务训练的acoustic token更直观一些:MiMo-Audio-Tokenizer中就提出用audio-to-text的任务来提取语义信息,CosyVoice3中更是融入了language identification、speech emotion recognition、audio eventdetecttion、speaker analysis等多个任务。
audio codec这块还有一个很重要的问题:如何评测呢?这块笔者没有太多的关注,欢迎大家补充。此外,大家感兴趣的话可以去读一下这篇综述:《Recent advances in discrete speech tokens: A review》,图1就节选自这篇文章,讲的非常详细。
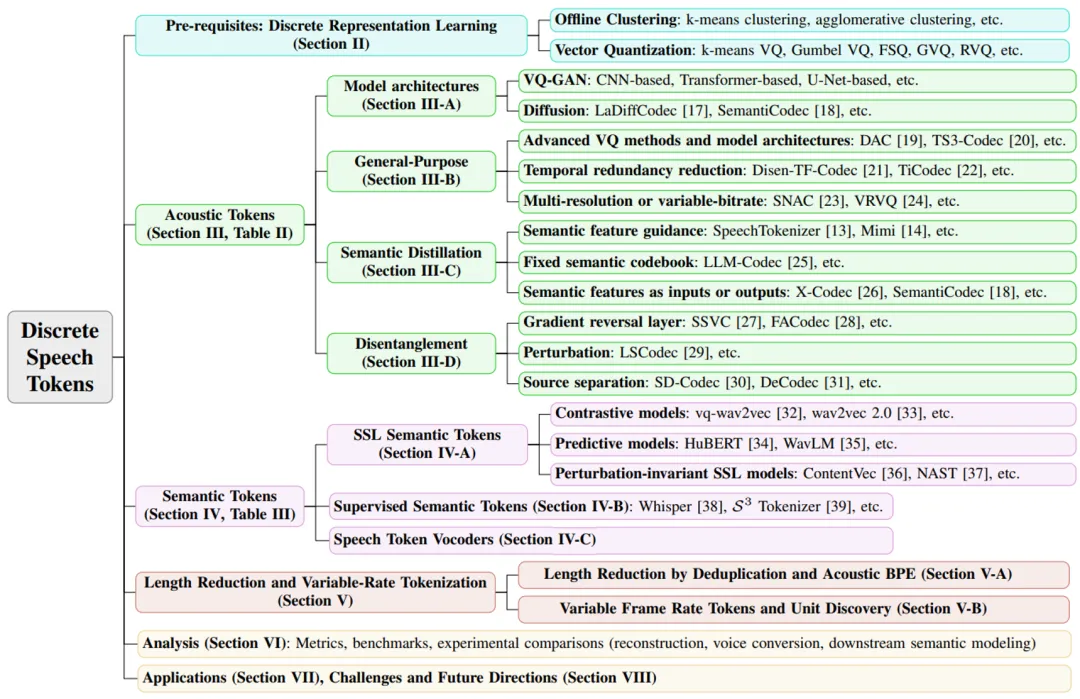
图1:Discete speech token发展路径一览图
这里还想提一嘴的是,语音合成中用discrete audio token的工作比较多,但是对于语音理解任务或者是端到端语音对话中的Thinker端,大家更倾向于使用continous speech vectors,一个比较典型的做法就是Whisper+downsampling,这样更方便嵌入来实现"语音-语义对齐"。
这个地方也挺有意思的,这么多端到端语音对话的模型中,我几乎只看到了Moshi和Mimo-Audio是采用discrete audio token来作为输入的,我在想这种输入不被主流对话模型接纳的一个原因应该是修改了LLM的输入空间,需要大量的训练数据来作为预训练才能保证基本的LLM智能化水平,而采用continous speech vector作为输入的话,首先可以借助audio encoder提取出语义信息,然后通过"语音-语义对齐"这一步来尽量复用LLM原本的智能化能力,训练数据量可以降低一些规模。不过这也是笔者的一家之言,欢迎大家一起讨论和纠正~
更低的推理延时
以LLM + flow matching + hifigan为主的三阶段式的语音合成模型,推理延时的降低主要集中在LLM和flow matching这块。对于LLM的延时,主要是由于autogressive这种推理方式造成的,降低延时的方式有两种:
一种是从工程化角度:采用更快的推理框架vllm等;
一种是从算法角度:
采用更高压缩率的audio codec
multi-token prediction:SLAM-Omni中提出的Semantic Group Modeling
deplay pattern prediction:适用于多码本预测,路径演进过程为:MusicGen->VoiceCraft->Moshi->Qwen3-Omni->QuarkAudio
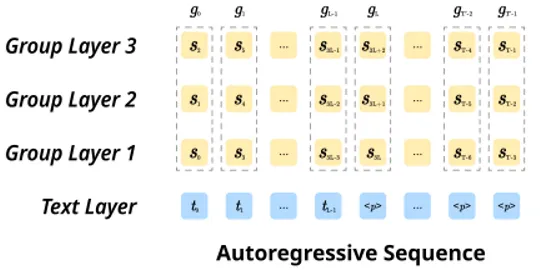
图2:Slam-Omni:Semantic Group Modeling
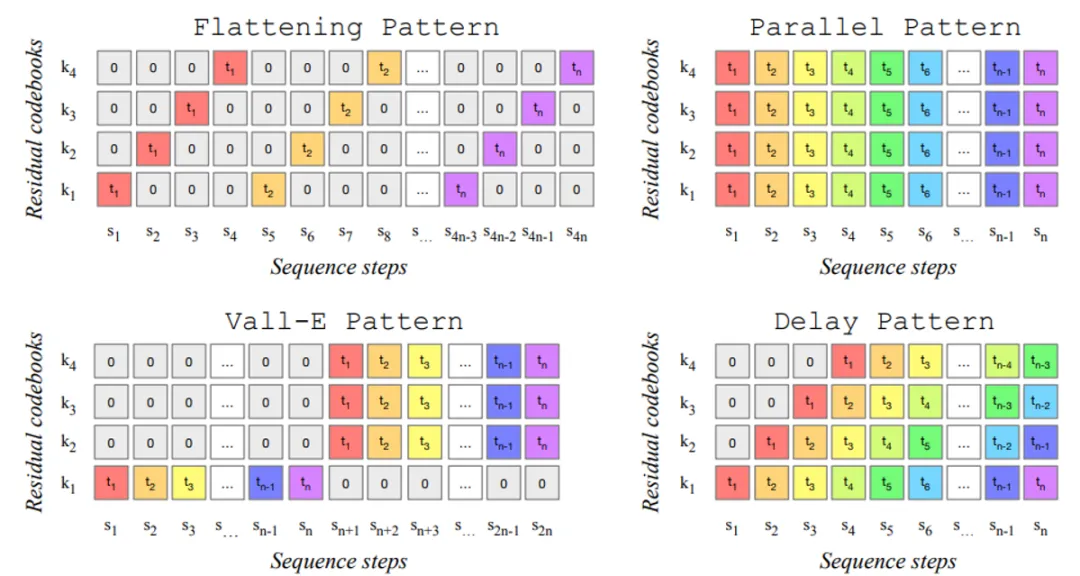
图3:MusicGen:4种多码本预测方式。Flattening Pattern是每层码本逐个预测,Parallel Pattern是一次性预测多层码本,Vall-E Pattern是先逐个预测第一层码本再同时预测剩余码本,Delay Pattern是同时预测带delay的码本
flow matching产生的延时,主要是"多步"预测导致的。针对这一问题,虽然业界提出了很多方法,比如Distribution matching Distillation, Consistency Model, Meanflow,但是目前还没有看到成功应用于"语音合成"这个任务,主要是音质会变差较多,MeanVC算是最接近的一个工作。此外,"流式"也是speech decoder实现工业化落地的必经之路,成熟的做法是通过应用chunk mask来实现attention的chunk-by-chunk计算(这部分Cosyvoice2已经开源得很彻底了)。在此基础之上,chunk-wise autogressive streaming也被MoonCast、KimiAudio等应用,且MeanVC已经将其训练和推理代码都开源出来了,这种方法的本质其实是按chunk为最小单位来进行autogressive推理,这样可以将上一个chunk对应的clean mel作为当前chunk的输入,理论上可以进一步增加音色的稳定性和记忆力,本质上和diffusion language model、block-wise diffusion等工作如出一辙,不知道以后会不会被广泛应用。
我还想提的一个工作就是Qwen3-Omni,在它的abstract中很明显点出了:为了降低首包延时,在Talker采用了"multi-codebook scheme+causal ConvNet"这一结构。
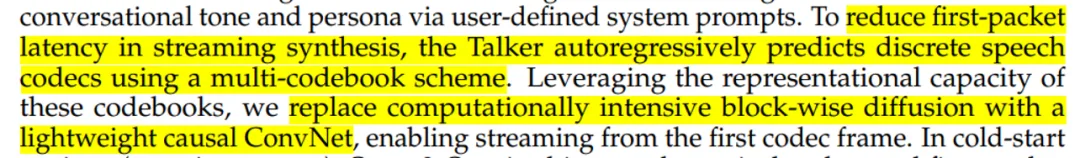
图4:Qwen3-Omni中的部分摘要内容
如前所述,多码本基本上包含了语音的全部信息,所以如果LLM的建模目标是多码本acoustic token的话,那么speech decoder部分可以用一个轻量级的model,如ConvNet,即可重建出wavform。我个人更推崇这种建模方式,但多码本的训练需要多大规模的数据、合成的稳定性如何保证,效果的上限是什么样的,这些都有待实验验证。
更拟人
拟人化一直都是语音合成领域中亘古不变的话题之一,现如今有了大模型的加持,语音合成的效果基本上已经实现了十分接近于真人说话的自然度,且zero-shot的能力也实现了突飞猛进。然而技术(lao ban)的追求无止境,对于语音合成的"拟人化"目标现在又有了更高的要求,结合各项工作的进展,我主要总结为以下几点。
一是副语言。常规做法是插入[laughter]、[breath]等标签,然后搜集相关的数据集来实现对副语言标签的支持。印象里ChatTTS的开源项目里就支持了很多这样的副语言标签,单[break]这一类就设置了很多不同级别的标签,后来慢慢发展几乎成了现在TTS模型的一个标配。我认为这块的难点还是数据,需要精准的副语言标注数据,相关的开源数据集还比较少,打标工具目前还不是很多,据很多同行反映Gemini系列还不错。
二是多方言/语种。方言或者语种的控制,主要还是通过audio prompt或者是instruction来指定语言类别。方言这块目前还是以合成单一方言为主,毕竟混说多方言的数据太少,也不太符合实际情况,而且方言在文字上不具备区分性,混在一起太难学了。开源数据的方言也在慢慢丰富起来,比如WenetSpeech-Chuan(川语)、WenetSpeech-Yue(粤语)。而对于多语种而言,已经看到越来越多的多语种混说的情况了,可以看看Cosyvoice3晒出的demo示例,如图5所示。
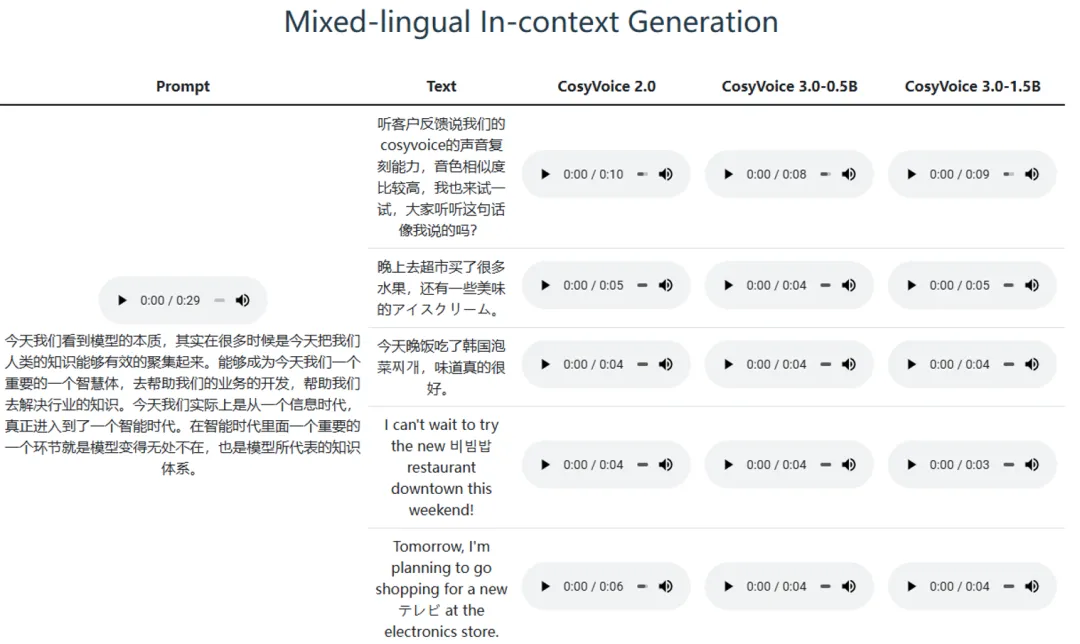
图5:Cosyvoice3:demo中的语种混说示例
我对多语种的看法就是数据,数据搜集的越多,模型的效果自然会越好。但是对于多方言混说,我觉得这事单靠数据量可能还不行,因为我国各个地方的方言虽然在发音和语义上都有非常大的区别,但是它们的文字大多都是汉字,这导致如果audio prompt不是方言的话,单靠text prompt很难让模型知道到底需要说哪种方言。为了解决这种"跨方言音色克隆"问题(Cross-dialectal voice cloning),SoulX-Podcast中提出了在推理时采用Dialect-Guided Prompting (DGP)方法,即插入一句能够代表目标方言的短文本,用这个来生成相应的dialect tokens,然后再生成目标文本内容,实际工作流如图6所示:
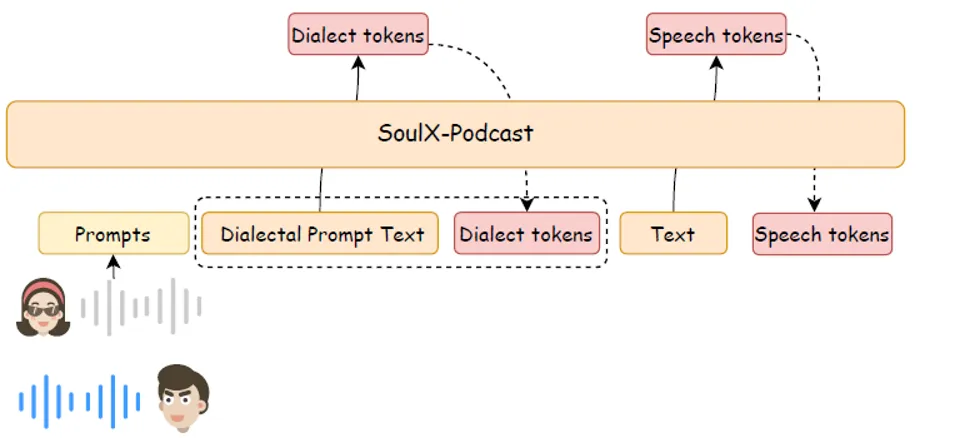
图6:SoulX-Podcast:基于DGP的推理方法
三是情感表达。情感表达一直都是语音合成领域一个非常难解决的问题,对于这块的目标,大致也可以分成两种。一种是指定一个情绪,输入文本,合成相应的音频。这里的情绪往往通过一个情绪标签来实现,如emotion、angry、sad、fearful、happy等。这里的落脚点还是在于"可控生成",期望能够实现文本、情感、音色的解耦,这样就可以解决带有精准情感标签数据的稀缺性。所以Minimax-Speech在解决这个问题的时候,就积累了大量的"同一文本,不同情感"的数据,旨在解耦语义和情感。此外,数据形式设计为
另一个围绕着"情感表达"在做的事情是:期望模型能够根据当前的语境来表达合适的情感,在语音对话领域中又被称之为"共情回复"。事实上我认为这更符合实际人类对话时的需求,情感的表达应该和上下文语境相融洽,试想当我们指定用一个happy的情绪来读"没看到日出真的是太可惜了",或者当你的朋友在跟你哭诉时你还挺happy地回复他,这本身就是一件比较违和的事情。但这个问题并不好解决,首先真实的speech dialogue数据就是非常稀缺的,这方面我看到MagicData公司已经在不断录制推出相关的对话数据集了,大家可以多关注。现在各家大厂都开始做自己的数据飞轮,如从喜马拉雅、小宇宙等播客平台上爬取对话数据,这里的工作量可真不小。此外,think机制也开始在语音任务上进行应用,比如OSUM-Echat提出"理解-生成-共情"的训练策略,在think的过程中沿着linguistic和paralinguistic两条线,在这篇文章中也列出了非常详细的数据构造过程,如图7所示。
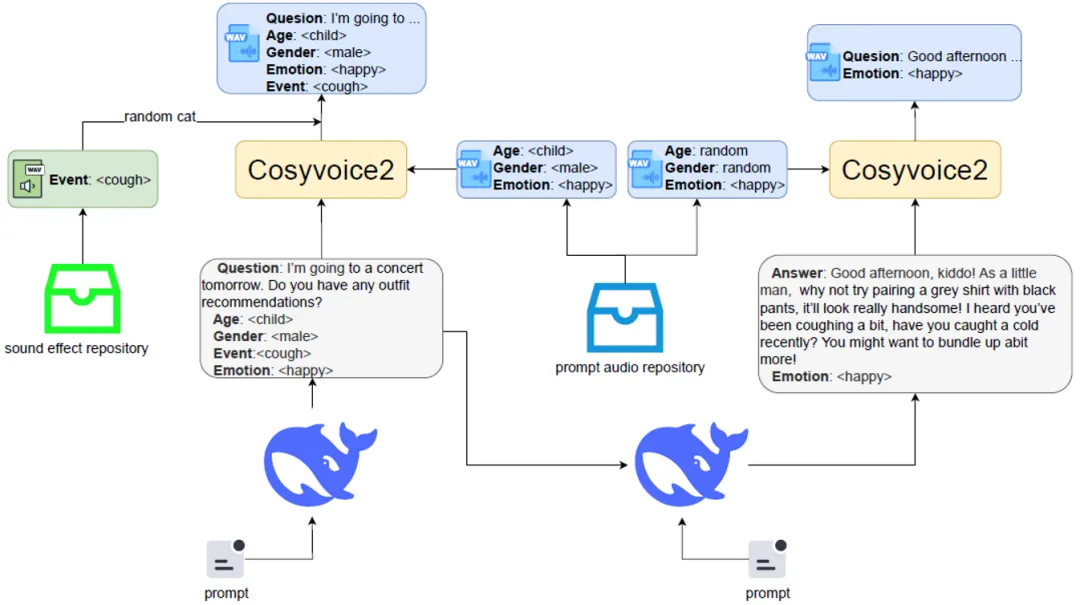
图7:OSUM-Echat:Echat-200K数据集的构造过程
Step-Audio-R1指出在语音领域的think机制不能只关注semantic level,还要能够关注到更多的音频声学属性,比如声音的粗细、音调的高低、情绪的变化等,实现真正的"native audio think"。为此,Step-Audio-R1提出了模态锚定推理蒸馏框架(Modality-Grounded Reasoning Disllation, MGRD),通过不断地迭代自蒸馏,使得模型能够基于文本和音频的声学信息进行推理,实现对音频这一模态的理解。
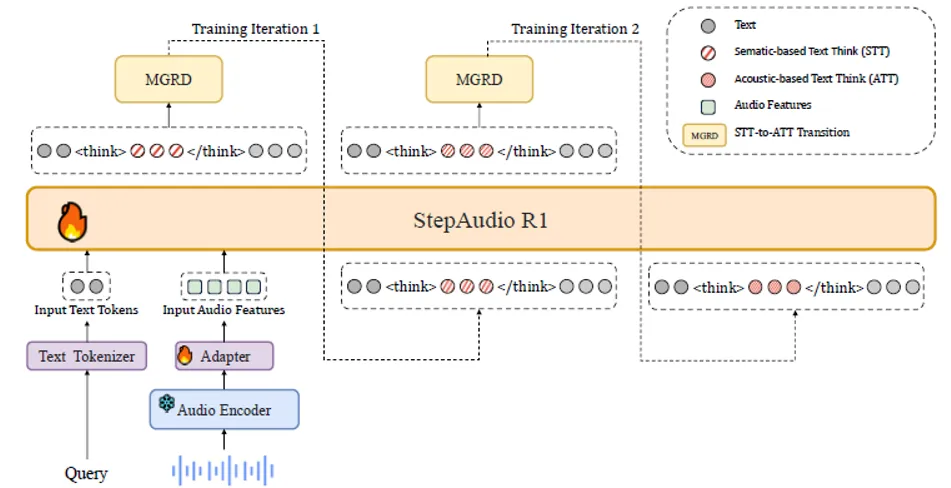
图8:Step-Audio-R1提出的MGRD框架
其实我一直认为,"共情回复"和"语音理解"二者不可分离,只有正确的理解了当前的语境,模型才能给出表达正确情感的回复。即使是仅仅考虑生成端,那么输入的信息也不能仅仅只有audio prompt和待合成的text,还需要有上文的信息(文本or语音)、对回复的思考(考虑回复应该用什么样的语气、语调等)。目前豆包已经推出了"上文语音合成",如图9所示,这里我们可以看到要想顺利的合成,就需要输入上文的文本,也体现了对语境的考虑。
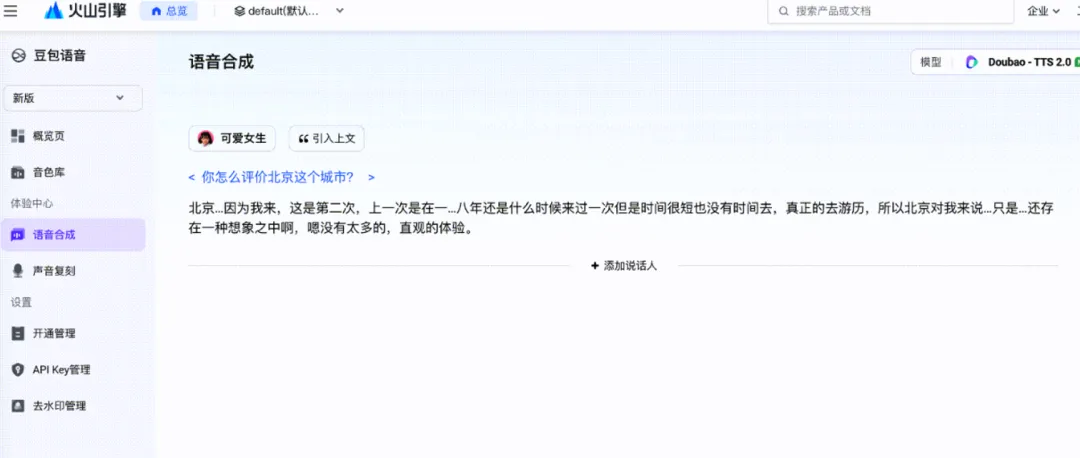
图9:豆包语音合成大模型的"引用上文合成"
不过目前就笔者体验下来的情况看,虽然能够根据当前语境做出一些反应,但是做出来的效果跟常规的超自然语音合成效果差距不是很大。这块儿我们到底想要一个什么样的效果呢?我觉得下面的Fun-Audio-Chat的样音是一个很好的示例,即使是对于同一句话,由于情绪不同,得到的回复在语义和情感上也有很大的不同。
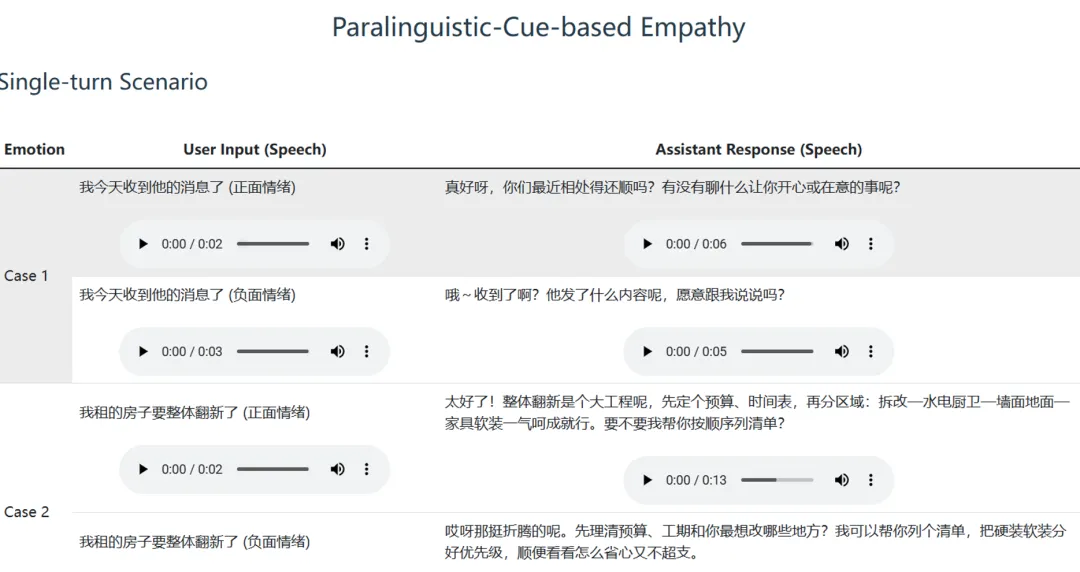
图10:Fun-Audio-Chat展示的demo样例,针对同一句话,用不同的情感提问,得到的回复也完全不同
更智能
智能化是大模型技术在语音合成领域不断演进的一个必然结果。传统小模型算法时代,针对不同的任务目标,我们往往需要设计各种各样的模型结构。现如今,"Task as Prompt"开始大行其道,ASR(Automatic Speech Recognition,ASR)慢慢向ASU(Automatic Speech Understanding,ASU)发展,TTS也不仅仅局限于合成文本对应的语音,还包含了更多的任务,这里我挑几点我关注的能力简单说说~
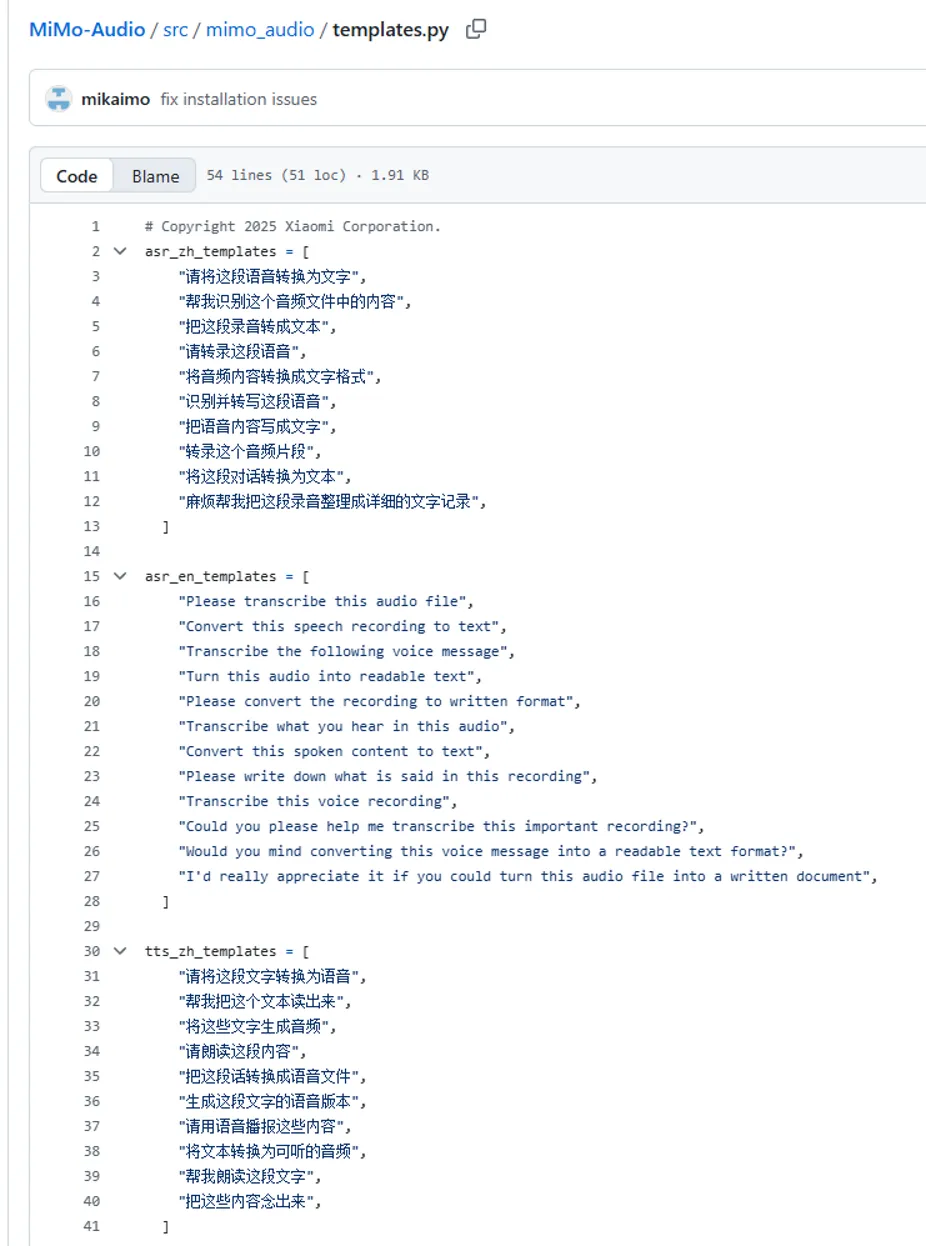
图11:MiMo-Audio:在Spoken Language Model的框架下,ASR和TTS这两个任务的切换演变成了Prompt的不同
instruction能力:指令遵循能力其实在很早之前就有探索过,最常见的形式就是:输入一条自然语言描述的说话人信息,然后模型按照要求合成相应的音频。这里的说话人信息通常会包含年龄、性别、音调、语速等等,比如"你是一个音色甜美的大姐姐",早期的工作还是考虑对声音的各个属性进行建模,如PromptSpeech系列,现在基于大模型的做法难点更多的来自于数据,比如Paler-TTS, CosyVoice3等等。
多轮多人长语音:之前的TTS能力大多局限于单人语音合成,且合成时长超过2分钟效果就会下降许多。现在借助大模型的能力,越来越多的工作开始关注"多轮多人"和"长语音",本质上还是想最终合成对话。典型代表就是VibeVoice,能够合成最长90分钟的音频,4个说话人,而且从demo的效果上来看是真的自然拟人。不过VibeVoice是采用next-token diffusion模型,基于连续语音向量来实现的,整个范式都是非常新颖的,但文章并没有透露出太多"长语音合成"的奥秘。SoulX-Podcast是基于离散单元实现多人多轮对话合成的,在文章中它特地指出为了实现长语音合成,引入了"context regularization mechanism"这个机制,即渐进式地丢掉历史地speech token,保留tetxual token,这样可以鼓励模型更多地依赖于语义的连续性。其实这里还有个很实际的好处就是节约显存,因为同样长度的内容,speech token往往会比textual token长很多。不过最终的训练姿势到底应该是什么样的,最终还是要实验一把才行。
降低文本前端的依赖:做过传统TTS算法的同学应该都知道,用户上传的一条文本往往需要经过一系列非常复杂的文本前端处理,才能够作为最终的模型输入。这一系列的处理,包括了长句切分、text normalization(TN)、g2p、等等,逻辑是非常复杂的。现在大模型时代下的TTS,直接将文字作为text tokenizer的输入,所以g2p这步直接被省略掉了。但是TN这步还不能被完全跳过。CosyVoice3中就已经提出构造
写在结尾
执笔于此,时间已经来到了2025年的倒计时第二天了。站在当前的时间点会看整个2025年,新的技术范式在快速发展,各类开源工作让人应接不暇。有幸作为一名小小的算法工程师,我时常感觉自己置身于充满奥妙的浩瀚星海中,而宇宙的美妙还在持续铺展,从未停下闪耀的节奏。
展望2026年,属于TTS的"Nano Banana"时刻也许就在不远处。而置身于大模型浪潮中的你我,原永葆追求未知的勇气和好奇心。技术的疆域从不是平铺直叙的坦途,俯身掀开每一块"石头",谁又知道这里藏着一个怎样生机盎然的"昆虫世界"呢?
愿各位,2026年,更加美好!
