
 语音小管家
标题:IndexTTS 2.5 Technical Report
链接:https://arxiv.org/pdf/2601.03888
发表日期:2026年1月9日
作者团队:bilibilidemo
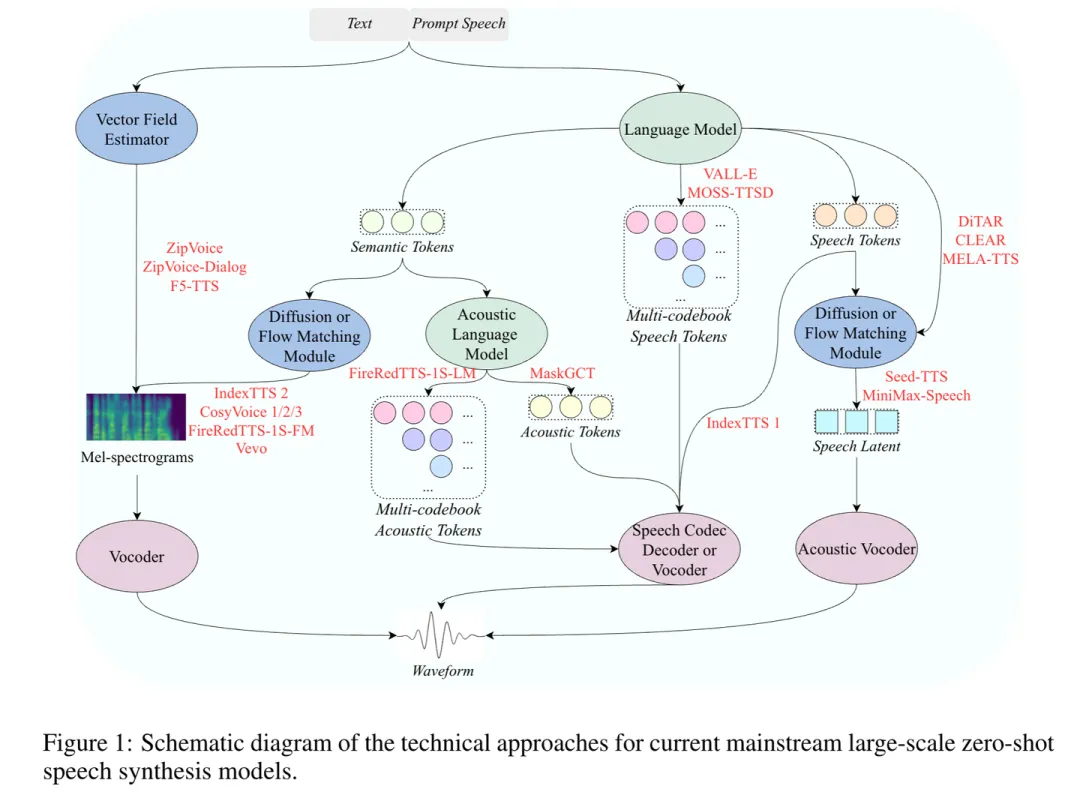
01、先聊聊背景:现在主流零样本TTS是啥样的?
02、多语言数据 pipeline:好模型得有好数据
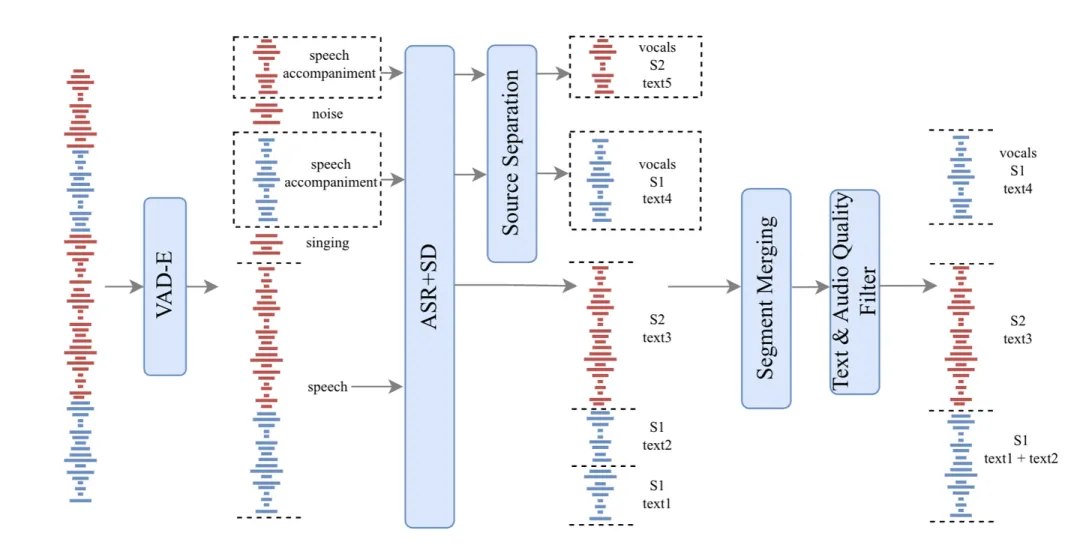
语音活动检测与分割(VAD-E):不只是切分语音片段,还能估计每个片段里“语音、唱歌、伴奏、背景噪音”的比例,过滤掉没用的部分。
ASR+多任务处理:集成了ASR、说话人 diarization(区分不同说话人)和标点恢复——输出的结果里,除了转录文本,还有说话人ID,甚至会标记“有没有多说话人、是不是唱歌、有没有伴奏”。
声源分离:如果检测到有伴奏,就用开源的Demucs工具提取纯人声;但不会所有片段都处理,只在必要时用,避免音频质量下降。
片段合并:把短片段按“说话人一致、文本连贯、段间静音短”这三个条件合并,最后每个片段最长不超过25秒(太长了训练效率低)。
质量过滤:分两步——音频用预训练的质量评估模型筛,文本则检查ASR转录的准确性,比如有没有错字、漏字,确保数据靠谱。
03、IndexTTS 2.5的核心创新点:四大改进
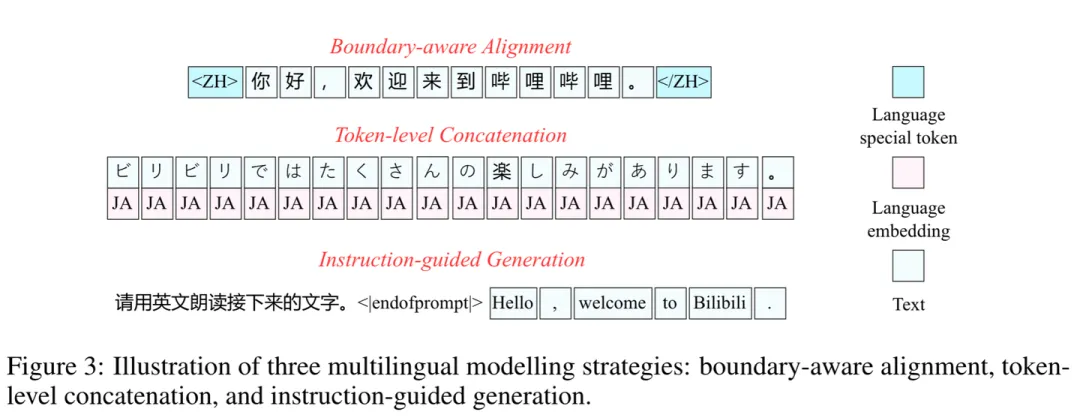
边界感知对齐:最简单直接的办法——在输入句子前后加语言专属的边界token,比如中文加和,日语加和。训练时模型能明确区分语言边界,不过长句子容易“ hallucination ”(脑补错发音)。
令牌级拼接:给每个文本token的embedding,都拼上一个“语言分类embedding”。这样能精准解决“同字不同音”的问题,但需要前端模块做“逐token语言识别”,系统集成会复杂点。
指令引导生成:在输入文本前加自然语言指令,比如“请用英文朗读接下来的文字”,训练时还会随机选不同的prompt模板。好处是推理时不用额外的语言标记模块,很灵活;但如果是“中英混说”的场景,指令可能有点冗余,用处不大。
语义codec帧率减半:把原来50Hz的语义codec帧率降到25Hz——这意味着语义token的序列长度直接砍半,训练时占的内存少了,推理时计算量也降了,还没丢关键的语言信息。
S2M模块换 backbone:原来S2M(语义转Mel谱)用的是U-DiT架构,现在换成了Zipformer。Zipformer参数更少,建模效率更高,生成Mel谱的速度快了不少,还没影响质量。
04、实验:数据、指标、结果都很实在
中文/英文:用现成的SeedTTS测试集——test-zh(2000句,来自DiDiSpeech)、test-en(1000句,来自Common Voice)。
日语/西班牙语:自己建的测试集——test-ja(500句)、test-es(300句),都来自Common Voice和FLEURS;还专门搞了情感测试集test-ja-emo和test-es-emo(从公开资源里挑的)。
WER(词错误率):中文用FunASR算,其他语言用Whisper-large-v3,越低越好。 SS(说话人相似度):用FunASR的预训练说话人验证模型提embedding,算余弦相似度,越高说明克隆的声音越像。 ES(情感相似度):用emotion2vec提情感embedding,算余弦相似度,越高说明情感复刻越准。 MOS(主观评分):让母语者给自然度打分(1-5分),越高越好。 基线模型:CosyVoice3、FireRedTTS-2、原版IndexTTS 2。
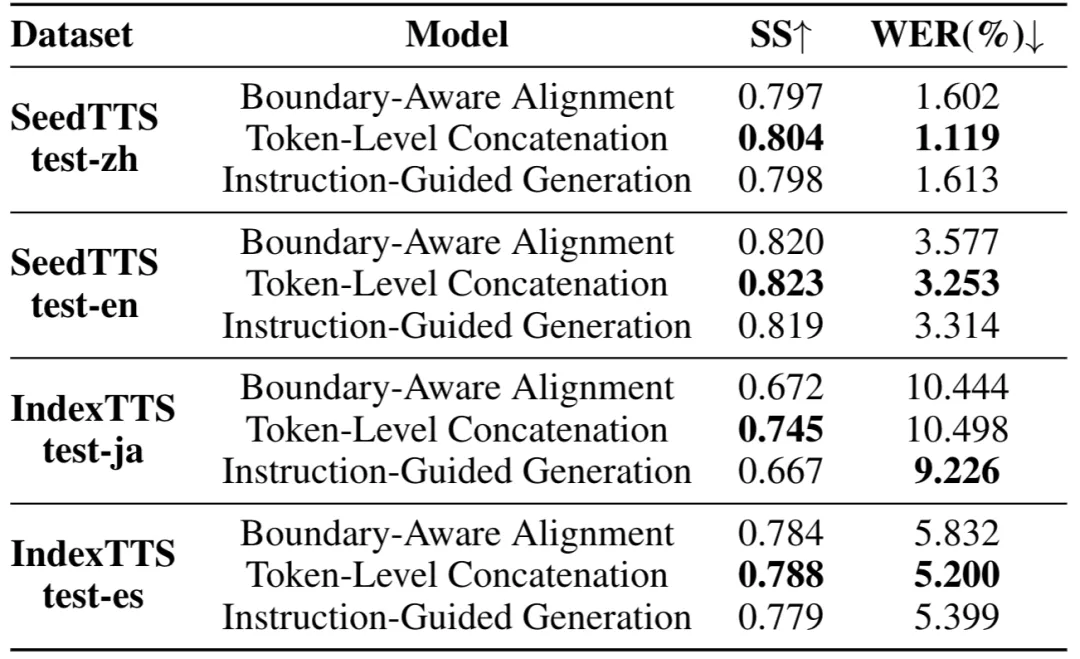
所有语言的SS都是最高的,说明能更好保留说话人身份; 中文(1.119%)、英文(3.253%)、西班牙语(5.200%)的WER最低,解决同字异音效果好; 但日语WER(10.498%)比指令引导(9.226%)略高——因为日语形态复杂,刚性拼接可能有点错位; 边界感知对齐在中日西表现一般,尤其WER偏高,适合简单场景。
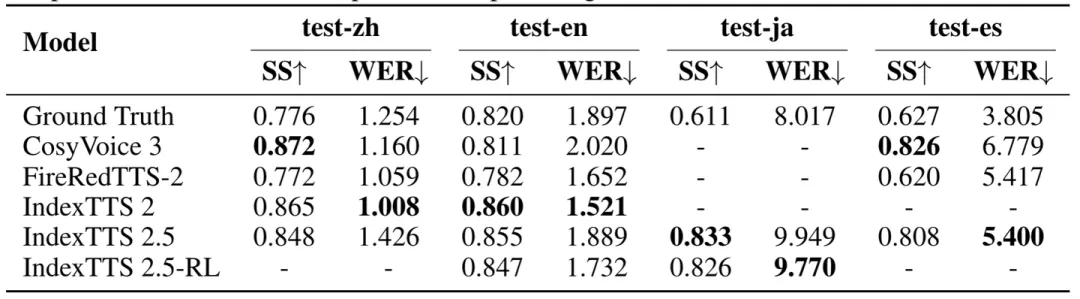
中文/英文:SS和基线(CosyVoice3、FireRedTTS-2)相当或更好,WER也低(中文1.426%、英文1.889%),说明文本-语音对齐准,克隆声音像。 日语:虽然WER(9.949%)比真值(8.017%)高,但SS(0.833)远高于真值(0.611)——跨语言克隆说话人身份的能力很强。 西班牙语:SS(0.808)和WER(5.400%)都比CosyVoice3(SS0.826、WER6.779%)好,泛化能力够。 还有个小惊喜:IndexTTS 2.5-RL(英文/日语用RL微调后),WER又降了——英文从1.889%降到1.732%,日语从9.949%降到9.770%,说明RL优化真有用。
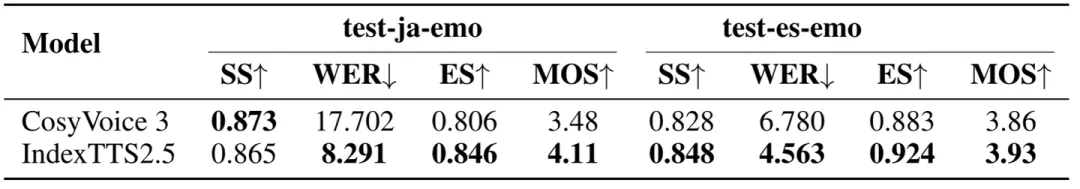
日语test-ja-emo:MOS4.11(Cosy3是3.48)、WER8.291%(Cosy3是17.702%)、ES0.846(Cosy3是0.806)——又自然、又准、情感还像。 西班牙语test-es-emo:MOS3.93(Cosy3是3.86)、WER4.563%(Cosy3是6.780%)、ES0.924(Cosy3是0.883)——同样碾压,零样本跨语言情感传递很稳。
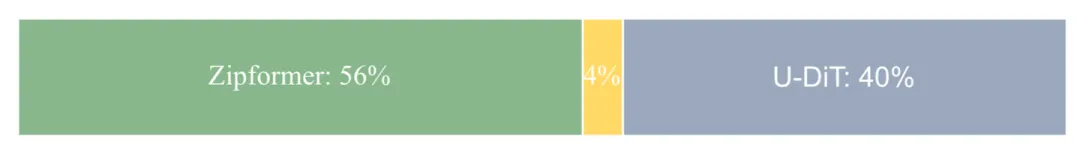
Zipformer被选中的比例是56%,U-DiT是40%,还有4%没偏好——说明Zipformer生成的语音更自然,说话人一致性也更好。原因是Zipformer能高效建模长距离依赖,训练更稳定,比复杂的U-DiT性价比高。
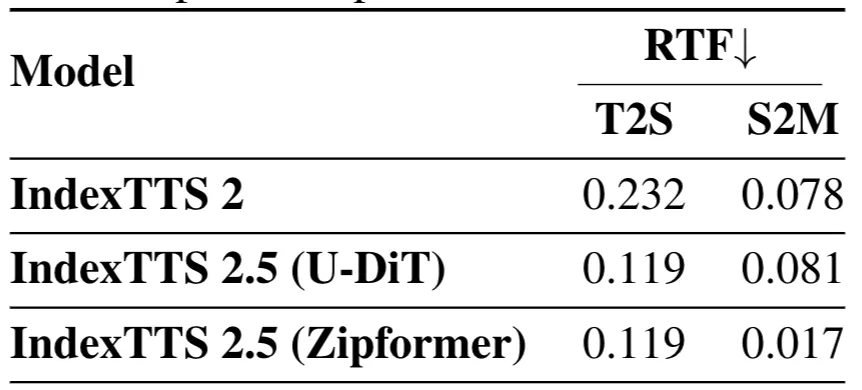
原版IndexTTS 2:T2S的RTF(实时因子)0.232,S2M的RTF0.078; 2.5(U-DiT):T2S降到0.119(帧率压缩的功劳),S2M0.081; 2.5(Zipformer):T2S还是0.119,S2M直接降到0.017; 整体RTF提升了2.28倍,还没牺牲WER和SS——这对实际部署太重要了,延迟低了才能用在实时场景。
05、总结:2.5到底强在哪?
多语言覆盖广:支持中、英、日、西四种语言,还能零样本跨语言传递情感和说话人身份;
推理速度快:RTF降了2.28倍,满足低延迟场景;
质量不打折:WER低、SS高、MOS高,发音准、声音像、自然度好。
