语音小管家
标题:Unifying Speech Recognition, Synthesis And Conversion With Autoregressive Transformers
链接地址:https://arxiv.org/pdf/2601.10770
作者单位:AutoArk-AI
发表日期:2026年1月15日
01、开头:传统语音系统太“分家”,GPA就是来“统一战线”的
TTS要么用“自回归生成token”,要么用“扩散模型”,还有多阶段的混合架构,步骤多还复杂;
ASR虽然有Whisper、Qwen-Audio这些大模型,但它们只擅长“认声音转文字”,想让它们合成语音或者变声,得大改架构;
VC靠“解纠缠”把语音拆成“内容”“音色”这些部分,但得要大量平行数据,还得额外微调才能适配新说话人。
02、GPA的核心创新:四个“狠活”,解决“分家”问题
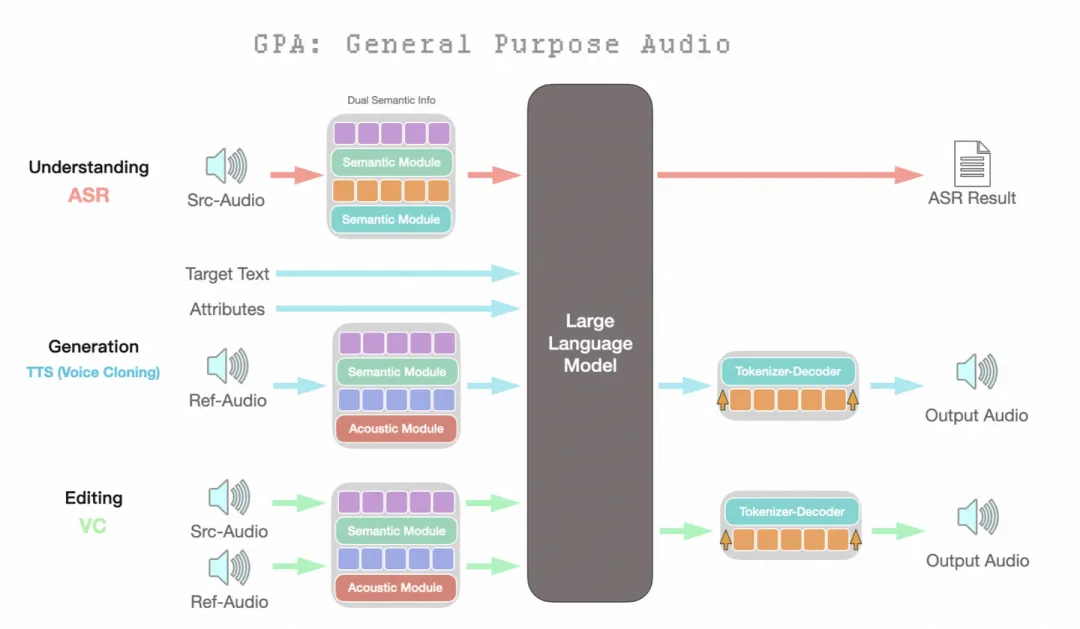
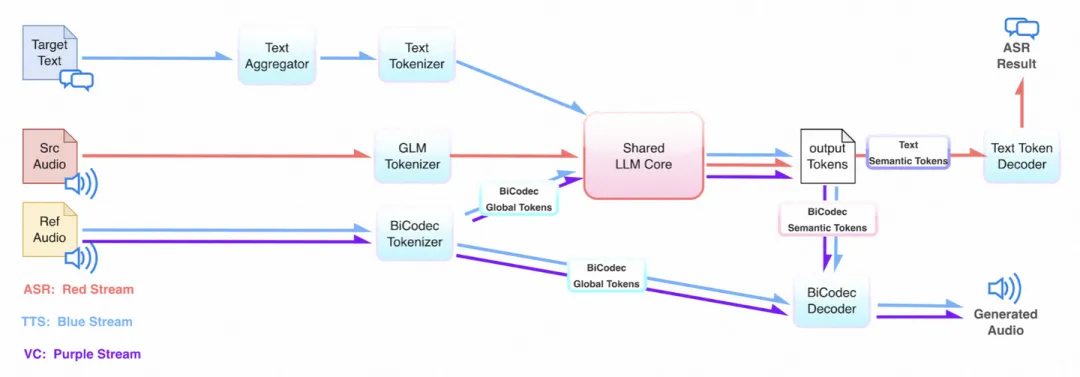
BiCodec Tokenizer:负责抓语音的“声学特征”和“内在语义”,比如说话的调子、快慢、音色;
GLM Tokenizer:从ASR模型来的,专门抓“和文本对齐的语言学语义”,比如哪个声音对应“你好”,哪个对应“吃饭”,避免模型生成的语音“听不懂”。
预训练:用100万小时语音数据,覆盖多说话人、多场景、多语言,让模型先学“声音和语义的基本对应”,不针对任何单个任务;
微调:用20万小时专门数据,针对TTS/ASR/VC调优,比如给TTS加“说话人标签”,给ASR加“精准文本标签”。
ASR帮模型“锚定语义”,让模型知道“这个声音对应这个词”,避免TTS生成“听不懂的话”; TTS和VC帮模型“保留声学细节”,让合成/变声的声音“像真人”,避免ASR只认文字不管“听感”; 三个任务一起训,还能互相“纠错”,减少过拟合——比如ASR防止模型只关注音色忽略内容,TTS防止模型只认文字不管节奏,泛化性更好。
GPA-0.3B:超轻量,只有0.3B参数,专门给手机、嵌入式设备这种“内存小、算力弱”的场景用,能跑多任务还不占地方;
GPA-3B:大参数版本,3B参数,追求性能上限,适合云端服务(比如大规模语音合成、企业级ASR)。
03、实验咋做的?细节拉满,保证结果靠谱
预训练:100万小时数据,覆盖多说话人、多场景(比如安静办公室、嘈杂街道)、多语言(中英文为主),让模型先“打好基础”;
微调:20万小时针对性数据,比如TTS加“说话人+文本”对,ASR加“音频+精准文本”对,VC加“源音频+参考音频”对,优化每个任务的精度。
音频归一化+去噪:把所有音频归一化,避免有的声音大有的小;还用自己训的去噪模型,去掉回声、背景说话声这些干扰;
说话人分割:用VAD+话者分离工具,把一段音频里“张三说的”、“李四说的”拆开,删掉有交叉说话、非语音(比如咳嗽、关门声)的部分,还过滤掉“说一半被截断”的句子;
高置信度转录:找了好几个ASR模型(Faster-Whisper Large-V3、Canary-1B这些)一起给音频转文字,然后算它们之间的“平均 pairwise WER”(pWER,就是互相之间的词错误率),只有pWER<15%(也就是大家意见特别一致)的文本才留用,避免标签错;
韵律对齐标点:用Montreal Forced Aligner强制对齐,根据说话的停顿加标点——比如300ms以上的停顿加逗号,50ms以内的流畅片段删掉多余标点,让文字和说话的节奏匹配,TTS合成时更自然。
04、实验结果:GPA到底行不行?看图表说话
TTS的表现
TTFC(Time-to-First-Chunk):生成第一块音频的时间,越短用户等得越久 RTF(Real-Time Factor):生成音频的时间÷音频本身的时长,说明生成比实时快(比如RTF0.2,生成10秒音频只花2秒)。
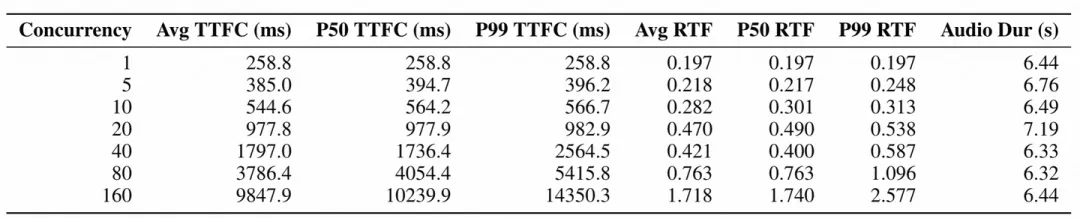
并发1的时候:TTFC才258.8ms(不到0.3秒),RTF0.197,生成6.44秒的音频实际只花1.27秒,特别快;
并发160的时候:TTFC涨到9847.9ms(不到10秒),RTF1.718(生成6.44秒音频花11秒)——虽然负载高了延迟涨,但还在“能接受”的范围,比如实时语音助手用着不卡。
ASR的表现
TTFT(Time-to-First-Token):输出第一个文字token的时间,越短“实时感”越强; 总延迟:从输入音频到输出完整文本的时间。
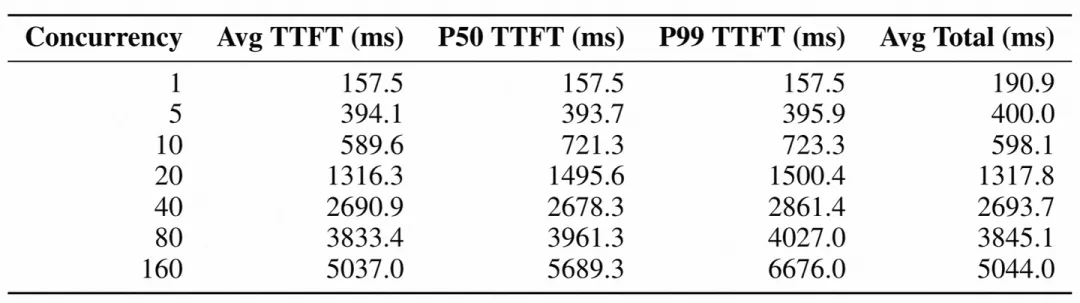
并发1的时候:TTFT157.5ms(0.16秒),总延迟190.9ms(0.2秒),差不多“说完就出字”;
并发160的时候:TTFT5037ms(5秒),总延迟5044ms(5秒)——对于实时会议转写、语音输入,这个速度够用。
TTS精度(分“多阶段模型”和“单阶段AR模型”比) :
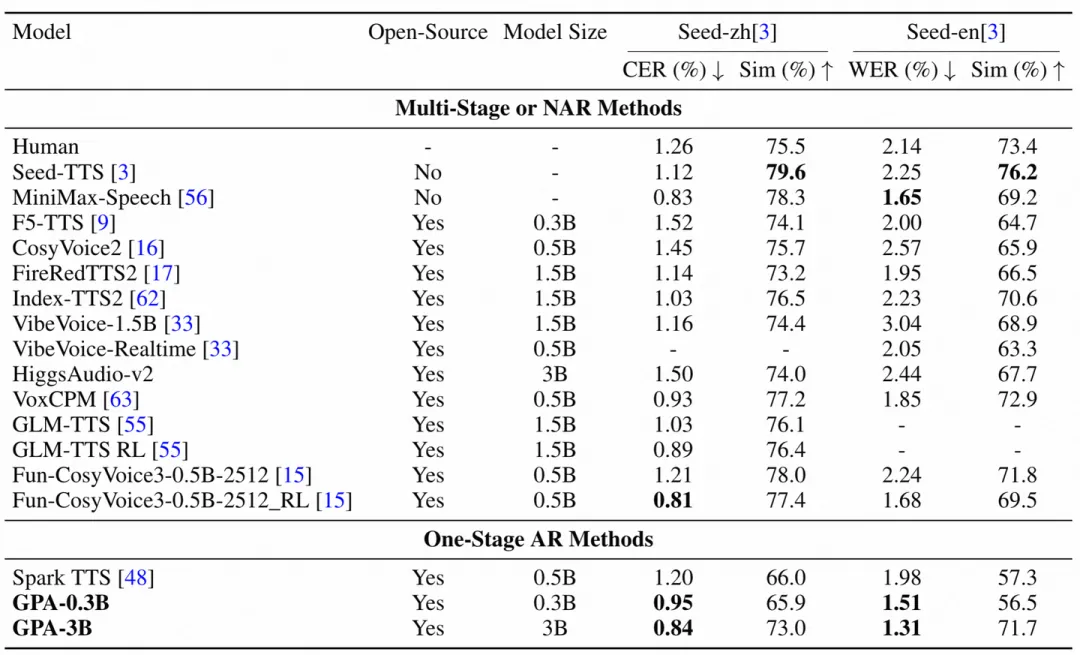
小模型GPA-0.3B(0.3B参数):中文Seed-zh数据集CER0.95%,比同参数的F5-TTS(1.52%)好太多;相似度65.9%,和同类型的Spark TTS(66%)差不多——作为边缘模型,能打成这样很牛;
大模型GPA-3B(3B参数):中文CER0.84%,英文Seed-en的WER(词错误率)1.31%,相似度73%——虽然比专门的Seed-TTS(相似度79.6%)差一点,但GPA能同时干ASR/VC,已经很能打了。
ASR精度(按模型参数分“<0.5B”和“≥0.5B”比):
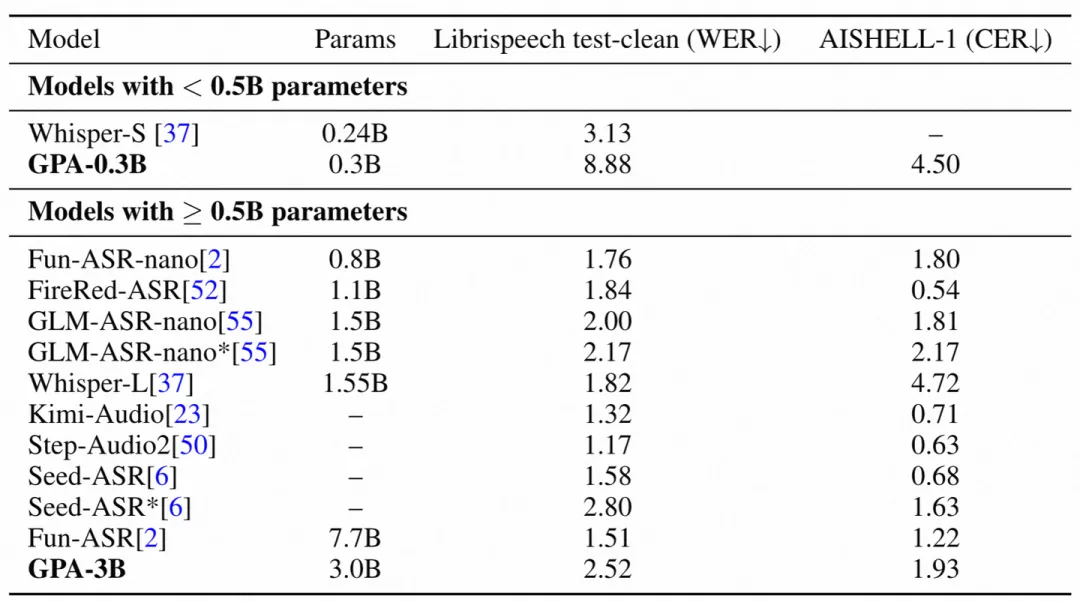
小模型GPA-0.3B:Librispeech英文数据集WER8.88%,比同参数的Whisper-S(3.13%)差——论文认为不是架构问题,是参数少容量不够,装不下太多“语音知识”;
大模型GPA-3B:Librispeech WER2.52%,中文AISHELL-1数据集CER1.93%——虽然不如专门的Fun-ASR-nano(WER1.76%),但GPA是3B参数,比Fun-ASR的7.7B小很多,还能同时干TTS/VC,性价比很高。
05、总结:GPA的亮点和小遗憾
第一次用纯自回归架构把TTS/ASR/VC整合成一个模型,不用改架构靠指令切换; 做了轻量版,边缘设备能跑;
实验证明它在同参数下比很多专门模型强,部署起来还方便——特别适合需要多语音功能的场景(比如智能音箱、实时翻译)。
共享token空间有瓶颈,比起专门为单个任务设计的模型(比如Seed-TTS),GPA的峰值性能还是差点;
长语音推理时,延迟会跟着token长度涨;0.3B的ASR性能偏弱,得靠增大参数改进。
打算用强化学习优化,因为GPA的“next-token预测”目标很明确,能直接针对“语音质量”、“指令跟随”这些指标调优,潜力还很大。
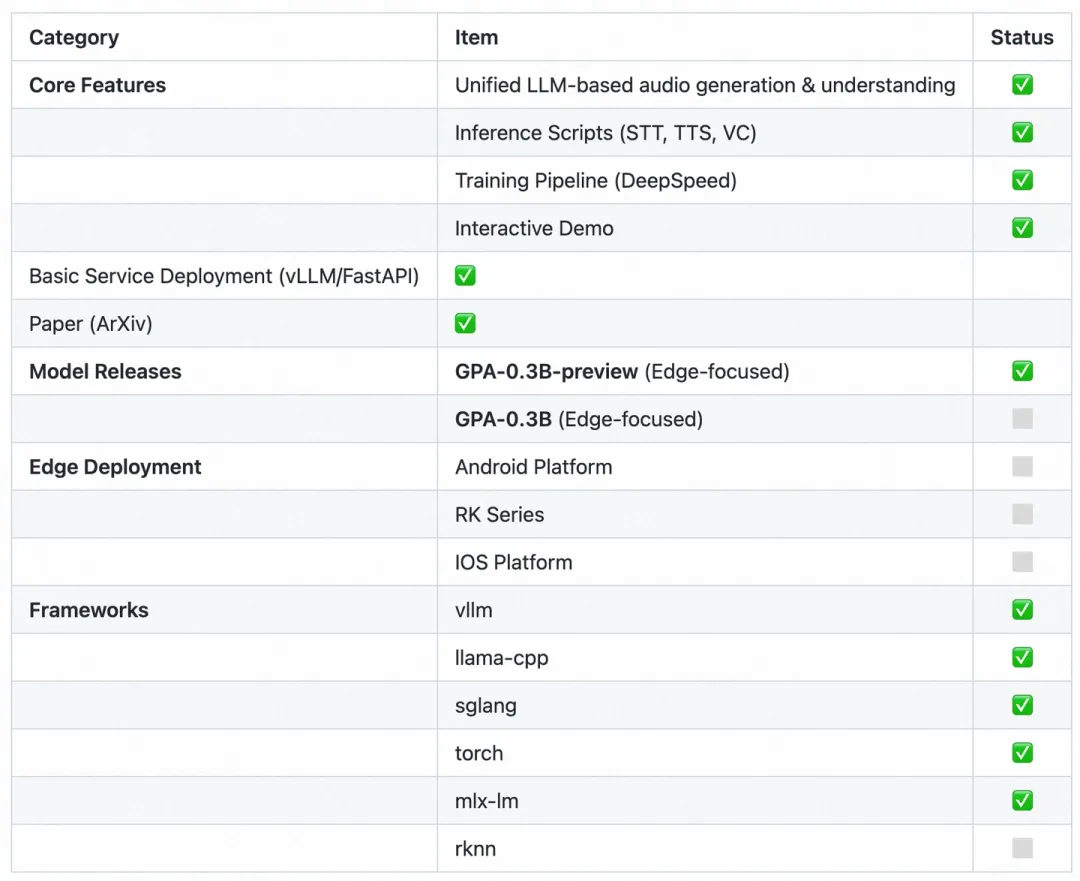
06、开源状态