
 语音小管家
「 现存问题 」
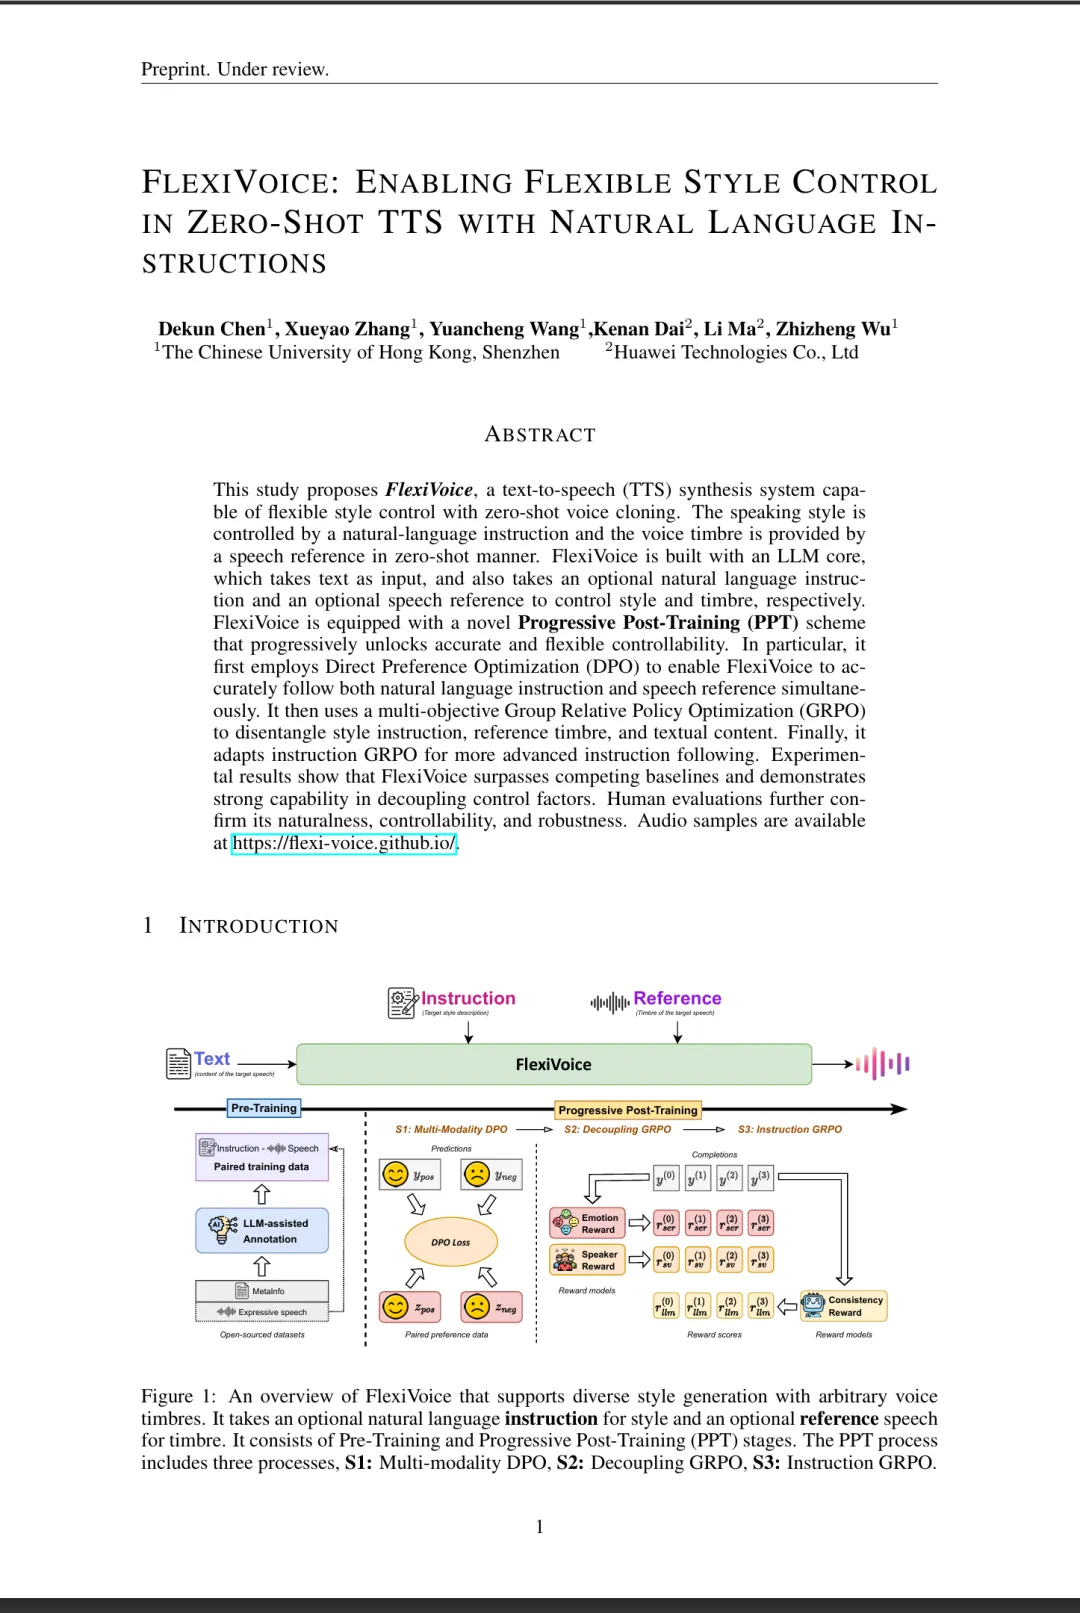
用户在进行指令语音合成时,常常希望用自然语言指令控制情绪、语气、语速等风格,同时又希望用一段参考音频实现零样本音色克隆。但现实中参考音频往往会把自身的情绪与韵律一起“带进来”,文本也可能自带隐含风格,导致模型忽略指令,出现“音色、内容、风格纠缠”的失控现象,尤其在指令与参考音频风格相冲突时最明显。
「 解决办法 」
✅「FlexiVoice」的核心贡献在于明确让“风格由自然语言指令决定、音色由参考音频决定、内容由目标文本决定”。我们首先构建了4000+小时的大规模指令语音数据集,同时提出一套面向解耦与可控性的渐进式后训练范式,让模型能从“简单明确的情绪指令”逐步泛化到更日常、更复杂的真实指令控制。
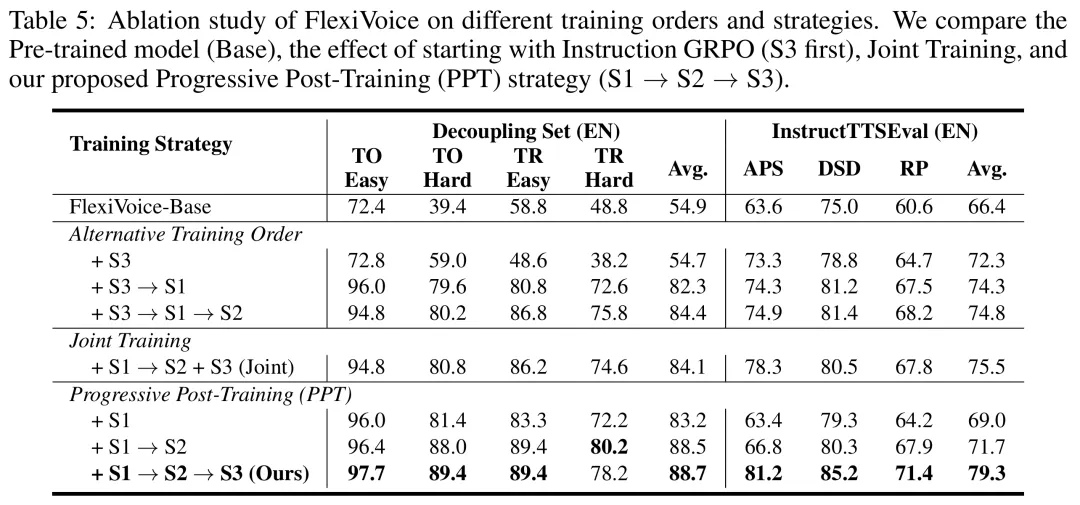
✅技术上最关键的是Progressive Post-Training(PPT)这条训练路线,它把后训练拆成三个阶段,并引入强化学习去“硬约束”解耦目标:先用偏好对齐(DPO)让模型学会基本的指令跟随与音色保持,再在冲突样本里用多目标GRPO同时约束“风格对齐”和“音色一致”,最后再用更通用的“指令是否满足”的判别信号,把能力推到开放式复杂指令上。实验结果显示,按这条渐进顺序训练最稳、收益最大。若跳过中间某个阶段或多个阶段同时优化,整体效果都会明显变差(Table 5)。
「 评测表现 」
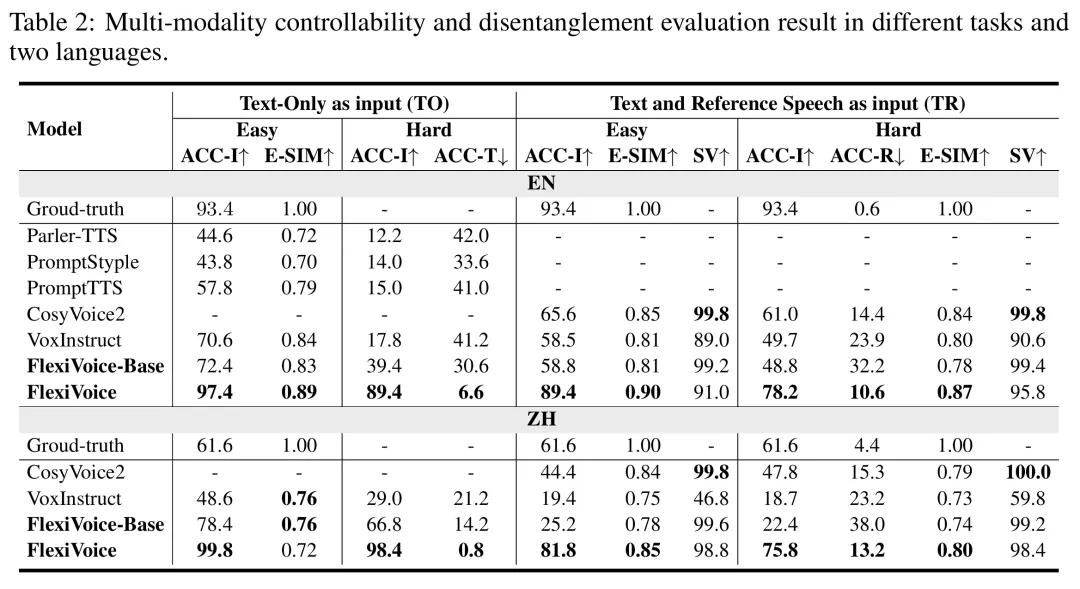
✅从结果看,「FlexiVoice」最突出的提升首先体现在解耦能力上:在专门设计的“文本/参考与指令相互打架”的困难场景里,它能显著减少被参考音频或文本带偏的情况,同时仍然保持音色一致性(Table 2)。
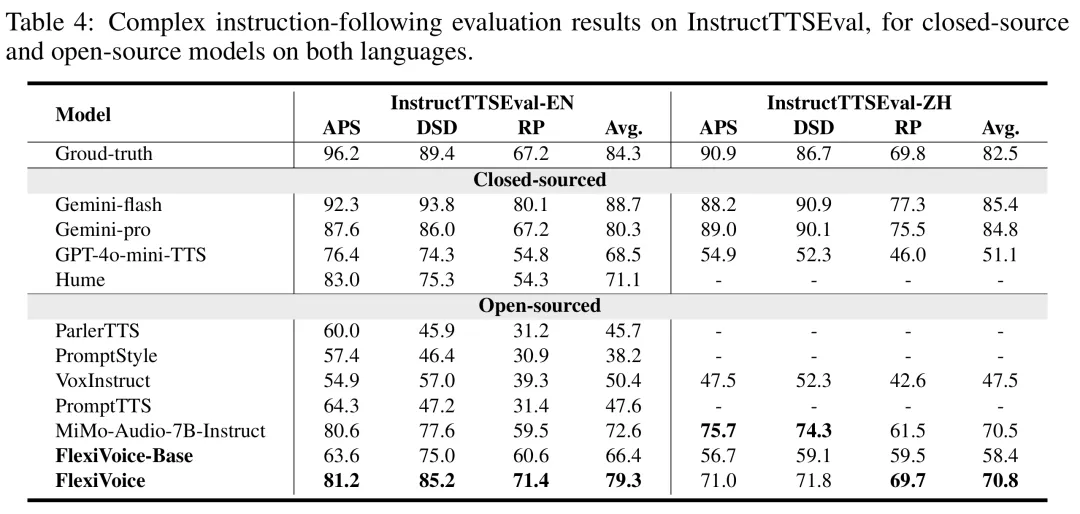
在更贴近真实使用的指令 TTS 基准上,它也取得了开源系统中的领先水平,并且整体表现已经逼近 Gemini-Pro 这类闭源强基线,说明它不仅能“更听话”,也能在复杂指令下保持稳定泛化(Table 4)。
✅总结来说,「FlexiVoice」把指令控制与零样本音色克隆这两个容易互相干扰的目标,通过“大规模指令数据预训练 + 基于强化学习的渐进式后训练”系统性地实现了:保证音色像的同时遵循风格指令,从而更接近真正可用的“任意音色 × 任意风格”指令语音生成。
