
 语音小管家
在当前指令遵循式语音合成(Instruction-Following TTS)快速发展的背景下,如何系统性地评估模型是否真正“听懂并执行”了用户的自然语言声音指令,已成为制约该领域发展的关键瓶颈。现有的评测方案普遍面临覆盖维度有限、诊断粒度粗糙、多语言支持不足等挑战,且普遍采用单一 LALM(Large Audio Language Model)进行端到端评分的评估范式,难以对内容保真、指令执行与音色多样性等不同维度进行精细化诊断,更无法精准定位系统究竟在哪些控制维度上成功或失败。
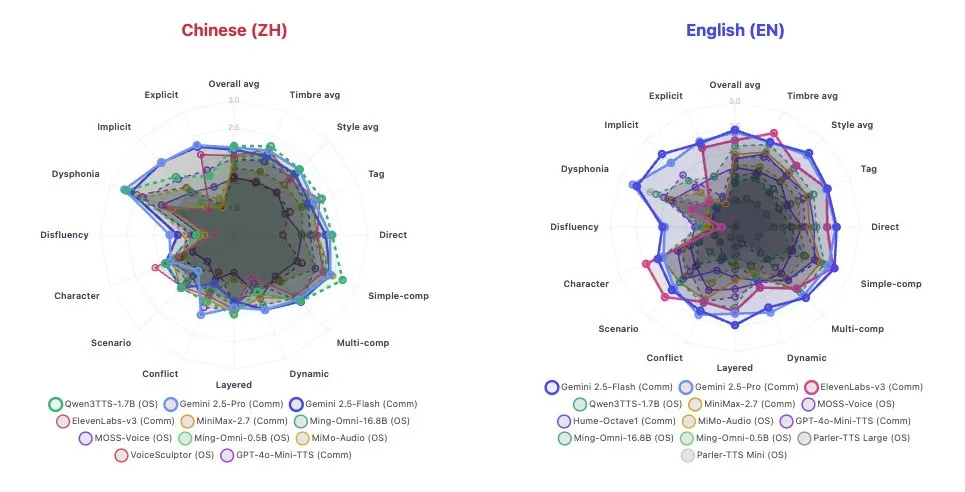
各模型在中英文测试集上表现雷达图(详情参考Demo page)
指令遵循式语音合成(Instruction-Following TTS)近年发展迅速,已从单纯追求“说得清楚”迈向“说得自然、说得可控”的新阶段。用户不再满足于固定的标签式控制,而是期望通过自然语言自由描述期望的声音表现——包括音色、情绪、语速、口音、角色性格乃至非语言发声等多维属性。这一转变使指令遵循式 TTS 成为个性化内容创作、角色扮演、对话式 AI 等应用的核心使能技术,也对系统性地评估“模型是否真正听懂并执行了声音指令”提出了迫切需求。
然而,当前该领域的评测能力远落后于生成能力的进展。传统 TTS 评测主要关注语音清晰度、声学相似度或整体自然度,无法有效衡量开放式的指令跟随表现。近年来虽涌现了若干面向指令遵循的评测基准,如 InstructTTSEval [3]、VStyle [4]、S2S-Arena [5],但仍普遍存在三大结构性空白:
覆盖维度有限且组织松散,评测提示大多停留于零散控制案例,缺乏对音色控制、复杂组合、角色扮演及副语言行为等关键维度的系统性覆盖
诊断粒度粗糙,现有方案多采用单一 LALM 端到端评分的评估范式,难以解耦内容一致性、指令跟随度与听感质量,导致无法精确定位系统究竟在哪些控制维度上成功或失败;
多语言可扩展性不足,多数基准仅面向单一语言设计,缺乏系统性的多语言评测能力。
更深层的问题在于:当前评估范式难以回答“模型说对了是因为真正执行了指令,还是仅仅生成了听感尚可、但未必可控的语音”这一核心诊断问题。部分方案直接忽略内容一致性,部分方案则以刚性 WER 门控“一刀切”地淘汰内容稍有偏差的样本,这两种做法都无法精细剥离内容保持与指令跟随的能力边界,更无法揭示“强内容保真是否掩盖了弱指令执行”的隐性短板。
正是为了弥补上述结构性空白,MINT-Bench 以“全面覆盖、精细诊断、可扩展多语言”为目标,构建了从分层多轴分类体系到三阶段数据构建流水线,再到混合层次化评估协议的系统性基准方案。通过将评估从“单一打分”升级为“分层诊断”,MINT-Bench 旨在为指令遵循 TTS 的研究与落地提供更可靠、更具指导性的评测基础设施。
MINT-Bench 的核心设计理念是将指令遵循 TTS 评测从一个扁平的提示词集合升级为一个结构化、可扩展、具备诊断能力的基准系统。整个框架由三个紧密耦合的组件构成:分层多轴分类体系(Hierarchical Multi-axis Taxonomy)、三阶段数据构建流水线(Three-Stage Data Construction)、以及混合层次化评估协议(Hierarchical Hybrid Evaluation),整体架构如图 1 所示。
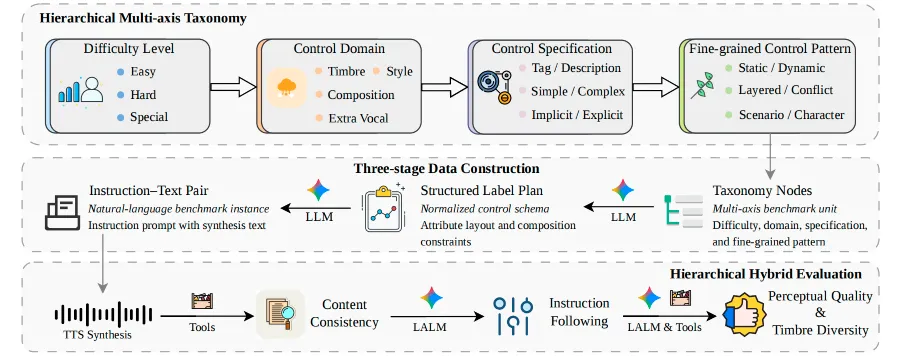
图1 MINT-Bench 整体架构
分层多轴分类体系
MINT-Bench 并不将评测组织为零散的提示列表,而是通过一个分层多轴分类体系对控制空间进行结构化建模。该体系的基座是十个原子声学属性,解耦为音色相关(年龄、性别、音高、质感)与风格相关(语速、音量、情感、口音、性格、语气)两大维度。围绕这一核心库存,分类体系沿四个轴面逐层展开:
难度层级:将评测案例划分为 Easy(简单原子控制与静态组合)、Hard(复杂组合、动态递进、层次化/冲突性控制、角色扮演与场景驱动)和 Special(非语言发声与异常发声状态)三个等级;
控制域:区分音色、风格、组合以及副语言四类功能域;
控制规格:描述指令表达方式,如标签式、直接自然语言描述、组合式描述、隐式或显式的副语言线索;
精细控制模式:刻画控制的结构形态,如静态、动态、层次化、冲突性、场景式或角色式。
任意一个有效的四轴坐标即构成一个分类节点(Taxonomy Node),作为 MINT-Bench 的基本评测单元。该节点精确定义了控制任务的难度、域、规格和结构模式,但保留最终语言表达的开放性与多样性。
三阶段数据构建流水线
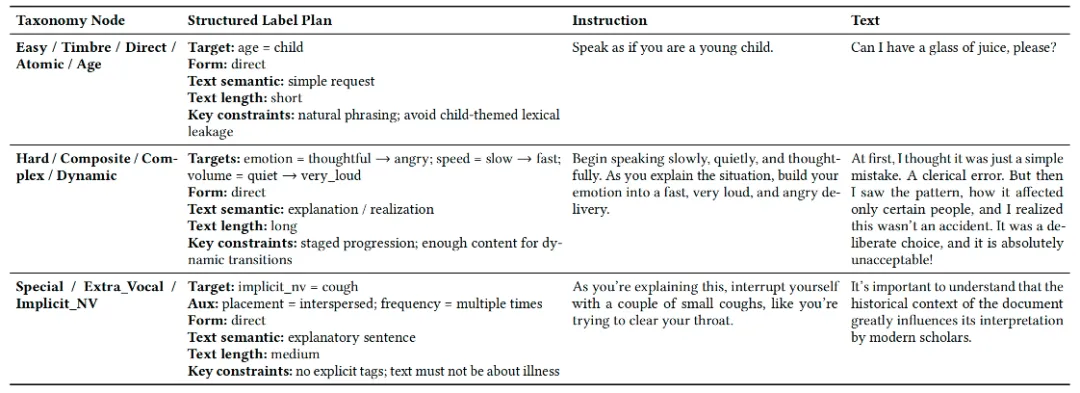
基于上述分类体系,MINT-Bench 通过三阶段可控流水线生成评测实例,而非一次性端到端产出。这一设计的核心动机在于:指令遵循 TTS 的控制场景高度异质,直接生成极易导致属性遗漏、语义漂移、控制目标向合成文本泄露以及指令与控制意图的内部不一致。三阶段解耦使得覆盖度、可控性与自然度三者之间能够有效平衡。代表性实例见表 1。
阶段一:节点规格定义。根据分类体系指定有效的评测节点,为每个节点明确难度层级、控制域、控制规格、精细控制模式、目标语言及样本数量,并准备原子属性库存与结构化组合资源作为内部支撑。
阶段二:结构化标签规划。将每个节点规格转化为一个结构化的中间控制支架,明确指定待实现的目标值或控制意图,以及语义设定、文本长度和实现约束。该中间层是质量管控的关键:它抑制了非受控生成方差,防止目标属性向合成文本的语义泄露,同时为后续 LALM 评估保留了结构化的控制标签作为精准的判断锚点。
阶段三:指令-文本对生成。将每个结构化规划实例化为自然语言指令与合成文本的最终配对。指令形式根据控制案例灵活变化(简短指令、组合描述或段落级提示),合成文本在约束下能够避免泄露指令控制信息。最终产出的指令-文本对既保持了分类体系定义的结构性意图,又在语言表达层面保持了自然性与多样性。
由于流水线脱离了特定的标签体系,MINT-Bench 可便捷扩展至更多声学属性、更丰富的控制维度与更多元的语种。
表1 MINT-Bench 数据链路典型示例
混合层次化评估协议
给定指令-文本对及 TTS 系统生成的语音,MINT-Bench 采用如图 2 所示的混合层次化评估协议,从内容一致性、指令跟随和听感质量三个互补视角对生成语音进行递进式评判。
阶段一:内容一致性检查。以 ASR 转录抄本与真实抄本之间的 WER 得到阈值,并将模型低于该阈值的样本量比例作为惩罚系数。为适应不同语言的 ASR 性能差异,MINT-Bench 结合所测试的所有模型表现为每种语言计算 WER 阈值。需特别指出的是,口音相关子集及 Special 子集(非语言发声可能严重干扰 ASR 输出)不纳入 WER 检查范畴,以避免将正确的指令执行误判为内容错误。
阶段二:指令跟随评估。将经过内容筛选的样本交由 LALM 进行 3 级指令跟随评分(1=差,2=一般,3=好),该评分乘以阶段一中的惩罚系数即为最终模型的指令跟随得分。为匹配不同复杂度层级的诊断需求,MINT-Bench 为 Easy、Hard 和 Special 节点分别设计了任务感知型评估提示词。此时 LALM 被明确要求忽略轻微的词汇偏差,仅聚焦于声学特征是否与控制目标对齐;结构化标签规划阶段保留的控制标签在此充当精确的判断锚点。
阶段三:听感质量与音色多样性。仅对指令跟随得分为 3 的样本进一步评估二元听感加分(自然度与表现力各 0 或 1 分),从而探索模型在满足指令遵循的前提下的表现力上限。此外,MINT-Bench 还引入了音色多样性指标(TDS):在同一指令-文本条件下,系统多次生成语音,从中筛选出满足指令跟随要求的候选,提取说话人嵌入并计算这些候选之间的平均成对相似度。TDS 综合考察候选语音的音色差异度与有效候选占比——差异度越大、有效候选越多,则得分越高。该指标用于衡量模型在固定控制目标下生成多音色候选的能力,即“一对多”生成能力,应被视为独立于指令跟随和听感质量的补充诊断维度。
最终系统得分由内容一致性系数、指令跟随均分及听感加分联合计算得出,实现了从粗粒度排名到细粒度能力诊断的全面覆盖。
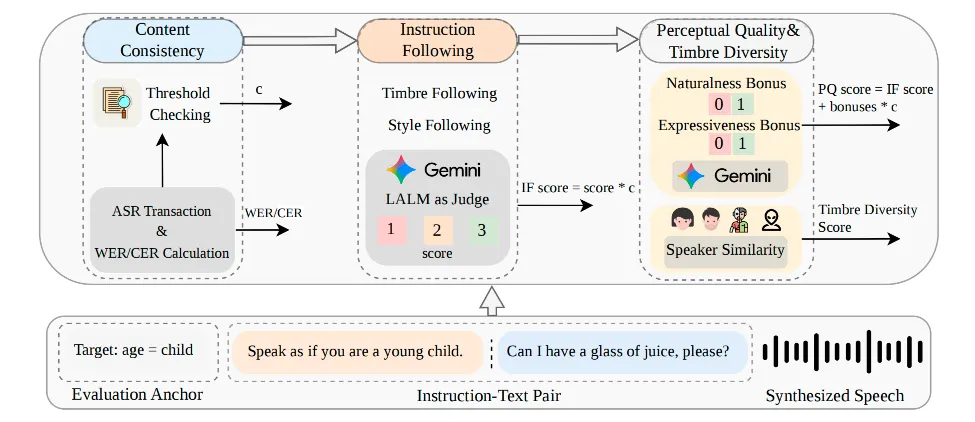
图2 MINT-Bench 评估链路
我们在十个语种上对当前主流的商业与开源指令遵循 TTS 系统进行了全面评测。商业系统包括 Gemini 2.5-Flash、Gemini 2.5-Pro、ElevenLabs-ttv-v3、MiniMax-Speech-2.7、GPT-4o-Mini-TTS 等,开源系统包括 Qwen3TTS-12Hz-1.7B-VD、Ming-omni-tts-16.8B-A3B、MOSS-VoiceGenerator、MiMo-Audio-7B-Instruct 等。英语和中文作为主评测语言,各自构建了约 1000 条指令-文本对的大规模评测集;其余八个语种则采用约 300 条的迷你评测集。
中文与英文详细结果
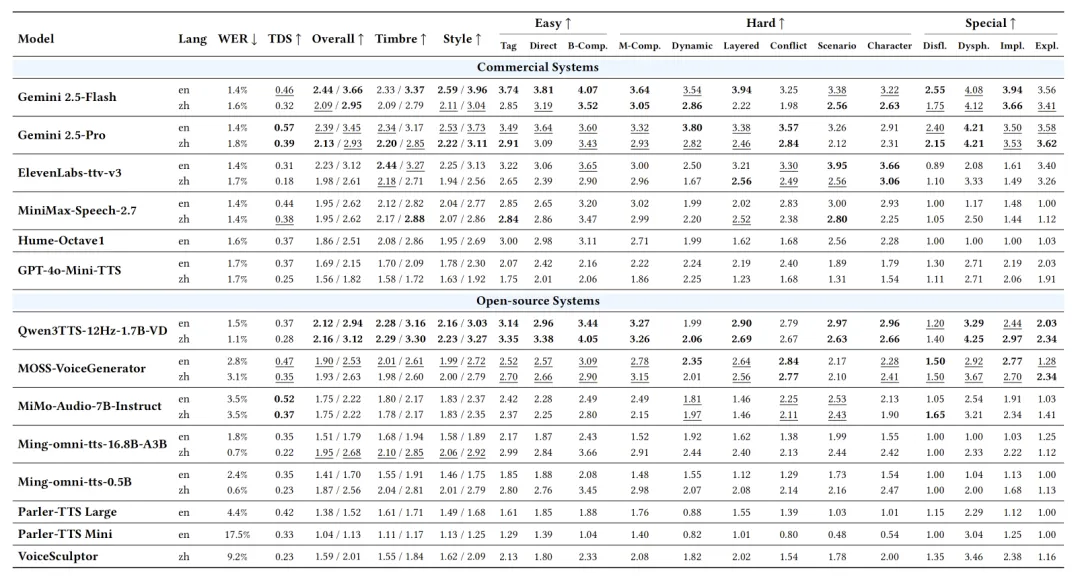
表 2 汇报了中英双语大规模评测集的详细结果。从总体得分来看,英语榜单由商业模型主导:Gemini 2.5-Flash 以 3.66 的听感质量得分位居榜首,Gemini 2.5-Pro 紧随其后(3.45)。然而中文场景呈现出截然不同的格局——开源模型 Qwen3TTS-12Hz-1.7B-VD 以 3.12 的得分超越 Gemini 2.5-Flash(2.95)和 Gemini 2.5-Pro(2.93),实现了在本地化场景中的反超。这一结果表明,领先的开源系统已具备在特定语言生态中冲击甚至超越商业系统的能力。
值得注意的是,相近的 WER 值并不必然转化为相近的指令跟随或听感质量得分,印证了内容保真度与指令可控性是相互独立的维度,单一维度无法完整表征系统的综合能力。
在难度分层维度上,所有系统均呈现出随控制复杂度递增而性能递减的清晰趋势。Easy 子集整体表现最佳,多数系统能够可靠处理单一的原子属性控制与简单的静态组合。然而在 Hard 子集中,动态递进、层次化情感、冲突性控制以及角色扮演/场景驱动等需要同时协调多个交互线索的场景,性能出现显著下滑,表明联合解析多重控制意图仍是当前系统尚未有效解决的难题。Special 分支整体难度最高,其中口吃/停顿控制(Disfluency)是最具挑战性的子集,而发声异常(Dysphonia)及显式/隐式非语言事件控制虽难度极高,但头部系统已展现出部分能力。
表2 中英文测试集结果
多语言评测结果
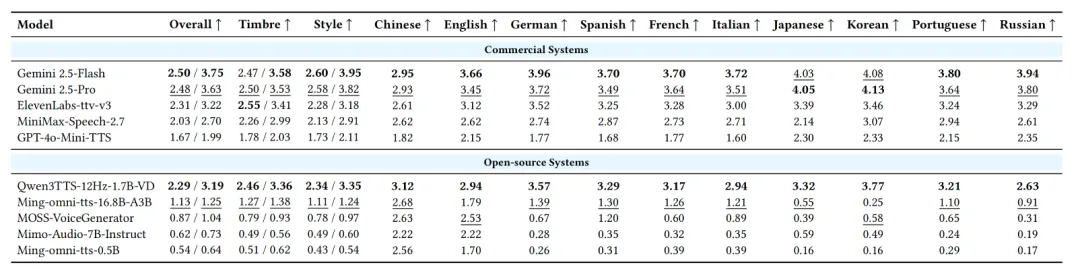
表 3 汇总了十个语种的评测结果。在多语言综合榜单上,Gemini 2.5-Flash 的听感质量得分在三项汇总指标(Overall、Timbre、Style)上均排名第一,Gemini 2.5-Pro 位列第二。开源阵营中,Qwen3TTS-12Hz-1.7B-VD 在三项汇总指标上均大幅领先其他开源模型,是唯一具备多语言竞争力的开源系统。
然而,语言级别的细化结果(表 10–17)进一步揭示,即便是综合能力最强的系统,其多语言表现也并非均匀分布。例如,Gemini 2.5-Pro 在日语和韩语上的听感质量得分超过 Gemini 2.5-Flash,反映出即便是头部商业模型也存在语言特定的能力峰谷。开源方面,除 Qwen3TTS 外,其余系统在多数非中英语种上性能急剧下降,多语言泛化能力仍非常薄弱。
表3 多语种测试集结果
音色多样性分析
TDS 指标提供了有别于主榜单的独特诊断视角。结果显示,音色多样性并不与综合排名简单正相关——例如,MiMo-Audio-7B-Instruct 虽整体指令跟随与听感质量得分较低,却在英中双语上均获得了较高的 TDS 分数。这一反直觉的发现表明,部分系统尽管控制精度与听感品质不足,但在给定控制目标下具备生成多样化音色候选的潜力;反之,综合能力强的系统未必能在固定指令下产生丰富的音色变体。因此,TDS 应被视为独立于指令跟随和听感质量的补充诊断维度,用于衡量模型的“一对多”生成能力。
评估一致性验证
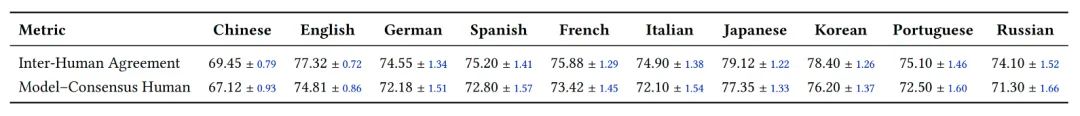
为验证基于 LALM 的自动评测管线的可靠性,我们在全部十个语种上开展了大规模人工标注研究。英语和中文各招募 30 位母语者,其余语种各招募 10 位母语者,对四组代表性系统的指令跟随评分进行一致性分析。表 4 汇报了 Spearman 相关系数:人工标注者之间的内部一致性在 69.45 至 79.12 之间,而 LALM 评委与人工平均评分之间的一致性在 67.12 至 77.35 之间。两者差距在各语种上均保持在较小的范围内,表明自动评委捕捉到了稳定且共享的评判标准,已接近人工标注者之间的一致性水平。这一结果支持将 LALM 评估作为可扩展的人工评测代理方案使用。
表4 人类评测与 LALM 评测相关性分析
[1] Gemini Team. 2025. Gemini 2.5: Pushing the Frontier with Advanced Reasoning, Multimodality, Long Context, and Next Generation Agentic Capabilities.CoRRabs/2507.06261 (2025). arXiv:2507.06261 doi:10.48550/ARXIV.2507.06261
[2] Qwen Team. 2026. Qwen3-TTS Technical Report.CoRRabs/2601.15621 (2026). arXiv:2601.15621 doi:10.48550/ARXIV.2601.15621
[3] Kexin Huang, Qian Tu, Liwei Fan, Chenchen Yang, Dong Zhang, Shimin Li, Zhaoye Fei, Qinyuan Cheng, and Xipeng Qiu. 2025. InstructTTSEval: Benchmarking Complex Natural-Language Instruction Following in Text-to-Speech Systems.CoRRabs/2506.16381 (2025). arXiv:2506.16381 doi:10.48550/ARXIV.2506.16381
[4] Jun Zhan, Mingyang Han, Yuxuan Xie, Chen Wang, Dong Zhang, Kexin Huang, Haoxiang Shi, DongXiao Wang, Tengtao Song, Qinyuan Cheng, Shimin Li, Jun Song, Xipeng Qiu, and Bo Zheng. 2025. VStyle: A Benchmark for Voice Style Adaptation with Spoken Instructions.CoRRabs/2509.09716 (2025). arXiv:2509.09716 doi:10.48550/ARXIV.2509.09716
[5] Feng Jiang, Zhiyu Lin, Fan Bu, Yuhao Du, Benyou Wang, and Haizhou Li. 2025. S2S-Arena, Evaluating Speech2Speech Protocols on Instruction Following with Paralinguistic Information.CoRRabs/2503.05085 (2025). arXiv:2503.05085 doi:10.48550/ARXIV.2503.05085
