
 语音小管家
以下文章来源丨模型之声
标题:《WavCube: Unifying Speech Representation for Understanding and Generation
via Semantic-Acoustic Joint Modeling》
链接:https://arxiv.org/pdf/2605.06407
作者单位:上海交通大学、上海创智学院、腾讯、北京大学、天津大学、浙江大学
发表日期:2026 年 05 月 07 日
开源地址:https://github.com/yanghaha0908/WavCube作者简介:陈谐(Xie Chen)现任上海交通大学计算机学院副教授、博士生导师,主要研究方向为智能语音信号处理,涵盖音频理解、音频生成和语音对话。曾任微软语言与对话研究组资深研究员(Principal Researcher),是 F5-TTS ¹ 的通讯作者。
值得参考的点
compress-then-enrich 两阶段训练策略:先用语义蒸馏将 1024 维 SSL 特征压缩到 128 维紧凑瓶颈,再解冻 SSL 编码器端到端注入声学细节,两阶段各解决一个核心矛盾。 语义锚定(Semantic Anchoring)机制:Stage 2 解冻编码器时,用冻结的原始 WavLM 输出作为参考锚点,防止端到端声学优化破坏已建立的语义流形结构。 SSL 特征直接用于扩散生成的可行性论证:通过系统消融揭示了 SSL 特征的两个内生缺陷(高维冗余和重建-保真度鸿沟),并给出了从语义表征到生成友好表征的完整转化路径。 统一表征的多任务验证:同一个 128 维表征在 SUPERB 理解、波形重建、零样本 TTS、SUPERB-SG 生成四个维度上均达到有竞争力的性能。
背 景
语音处理领域长期存在理解与生成的表征割裂问题。理解任务依赖自监督学习(SSL)编码器(如 wav2vec 2.0、HuBERT、WavLM)学到的语义导向特征,而生成任务依赖 Mel 频谱图、VAE 潜变量等声学导向表征。这种割裂导致统一语音系统难以实现——理解模型和生成模型各自维护独立的表征空间和编码器架构。
视觉领域已率先完成这一统一:DINOv2、SigLIP 等预训练视觉基础模型的特征可直接替代 VAE 潜变量用于扩散生成,同一表征既支持判别性理解也支持高保真生成。语音领域能否构造类似的统一表征?
直接将 SSL 特征用于生成面临两个根本障碍:
高维冗余问题:1024 维 WavLM-Large 特征直接送入扩散模型会导致灾难性失败——338M 参数的 DiT 在此设置下 zero-shot TTS 的 WER 达 110.28%,即使将 DiT 扩大到 753M 参数,说话人相似度也仅有 0.27。 重建-保真度鸿沟:SSL 编码器以判别性目标训练,有意丢弃了高频、相位敏感的声学线索,直接解码 SSL 特征会产生可感知的语音质量退化。
WavCube 通过 compress-then-enrich 两阶段训练策略系统地解决这两个问题。
核心方法
整体架构
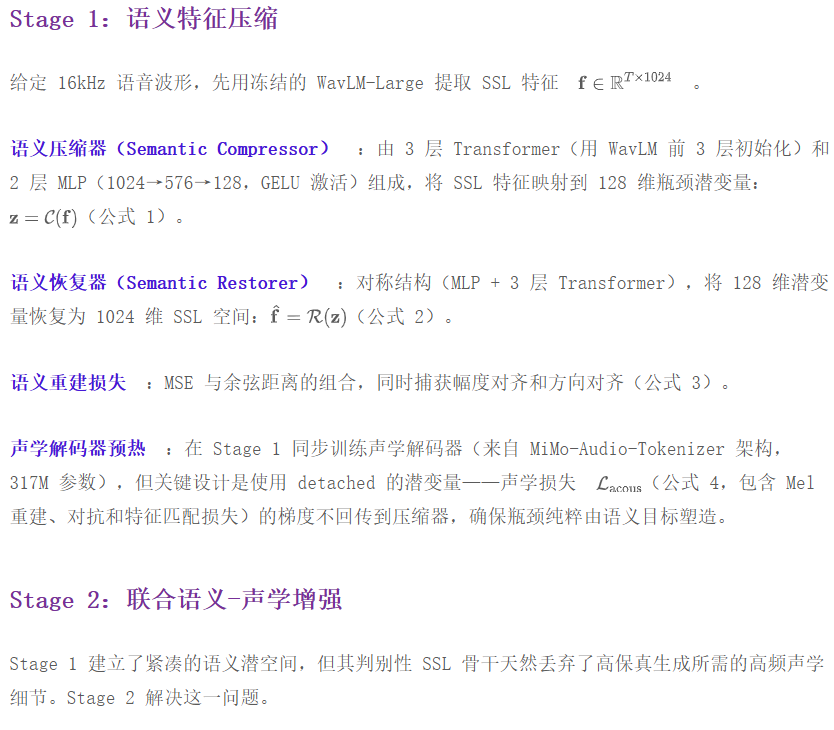
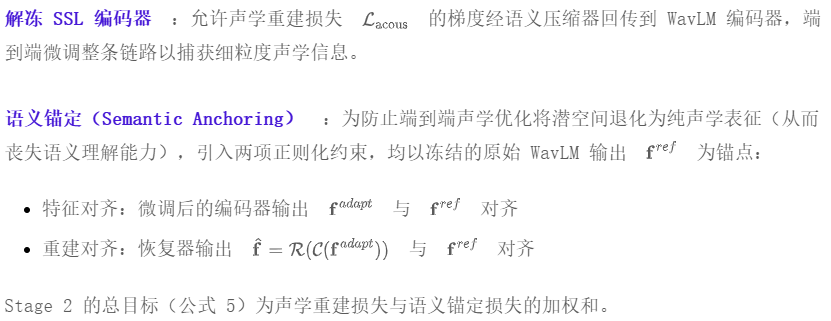
WavCube 构建在冻结的 WavLM-Large 之上,通过对称的适配器式自编码器将 1024 维 SSL 特征压缩为 128 维紧凑潜变量
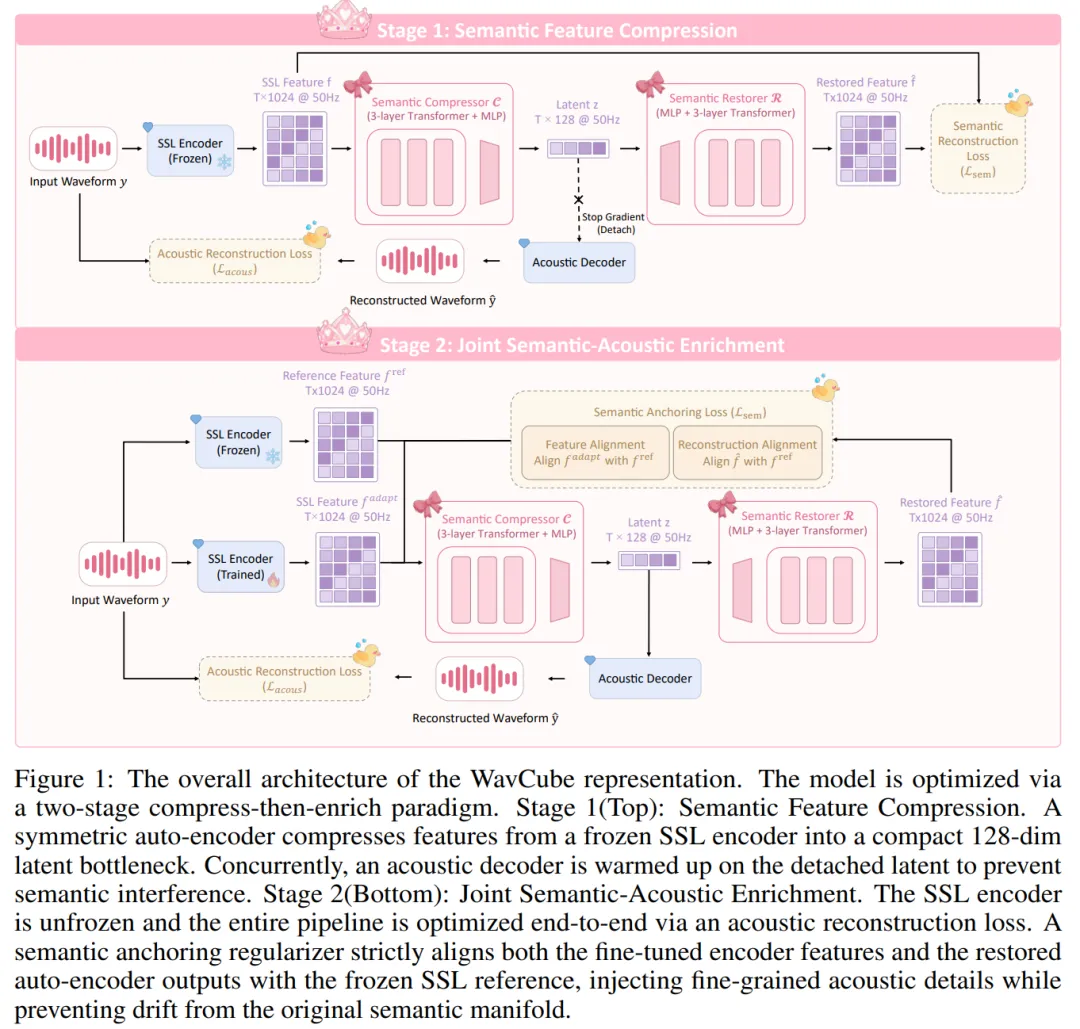
题注内容:WavCube 整体架构,展示 Stage 1 语义特征压缩和 Stage 2 联合语义-声学增强的两阶段训练流程
数据情况
下游 TTS 实验的训练数据:
小规模:LibriTTS 大规模:Emilia-ZH-EN(约 95,000 小时英文和中文语音)
评估均在 LibriSpeech test-clean 上进行。TTS 评估使用 LibriSpeech-PC test-clean 子集(1,127 条,时长 4-10 秒)。
下游生成任务统一采用 DiT 架构(F5TTS_v1_Base 配置,22 层,hidden dim 1024,337.2M 参数)。
实验与结果
语音重建
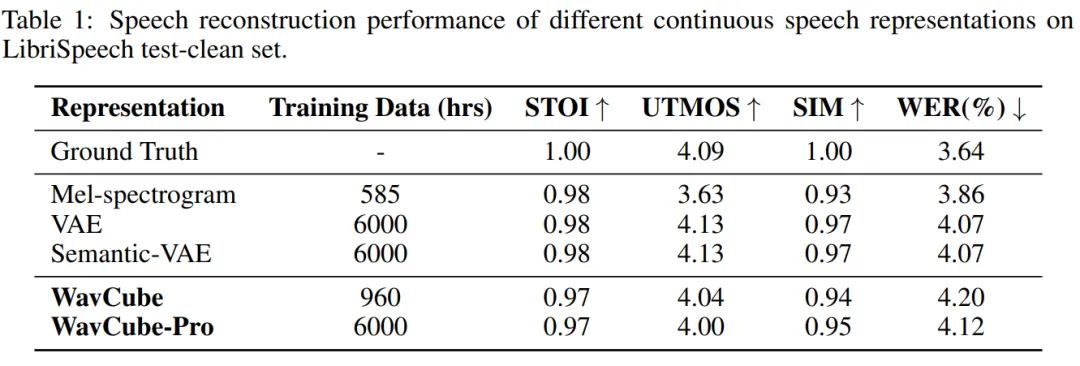
题注内容:不同连续语音表征在 LibriSpeech test-clean 上的重建性能对比
WavCube 在语义严格正则化条件下仍取得接近声学表征的重建性能:STOI0.97,UTMOS4.04,SIM0.94。与专门为重建训练的 Mel 频谱图、VAE、Semantic-VAE 相比具有竞争力。
语音理解(SUPERB)
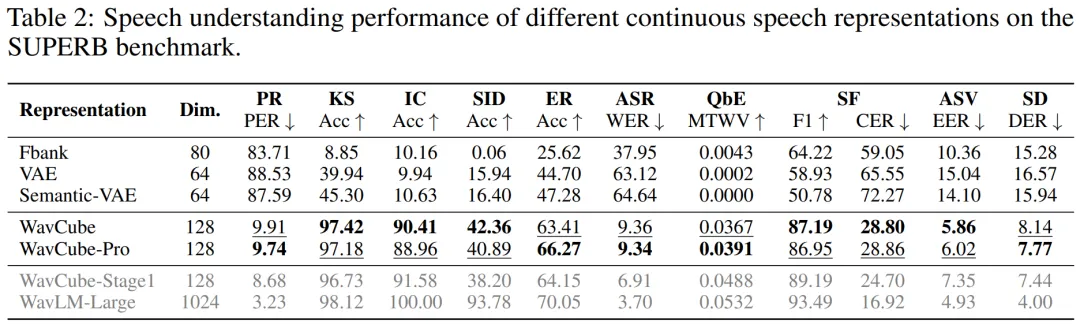
题注内容:不同连续语音表征在 SUPERB 理解基准上的性能对比
WavCube 在 128 维下实现了接近 1024 维 WavLM-Large(性能上界)的理解能力,尽管存在 8 倍维度压缩。在所有 10 个 SUPERB 任务上全面超越 Fbank、VAE 和 Semantic-VAE。Stage 2 的声学增强未破坏语义结构——WavCube 和 WavCube-Pro 与仅做 Stage 1 的 WavCube-Stage1 表现相当,验证了语义锚定机制的有效性。
零样本 TTS
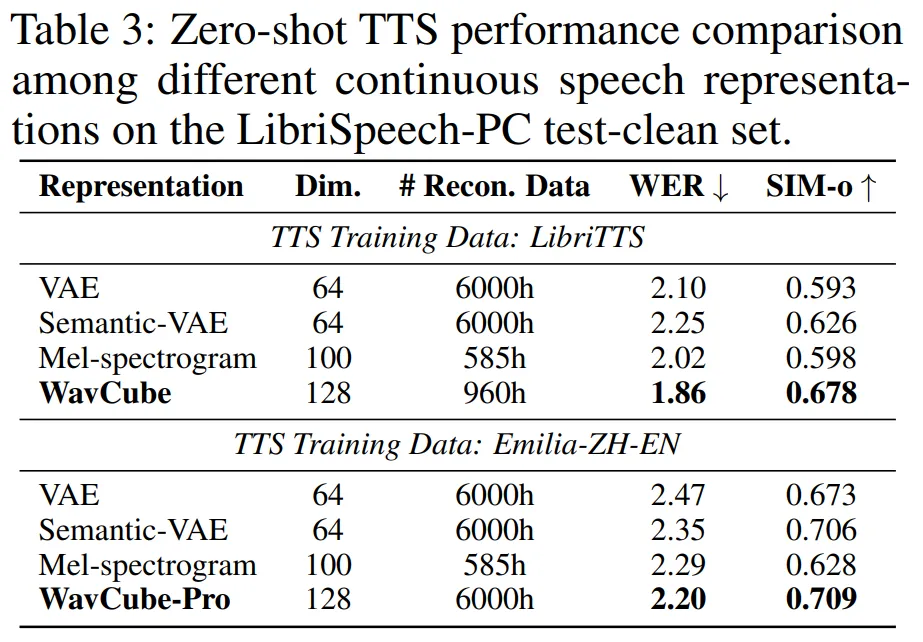
题注内容:不同连续语音表征在零样本 TTS 任务上的性能对比
在统一 DiT 架构下仅替换底层表征进行对比,WavCube 在 LibriTTS 上达到 WER1.86%、SIM-o0.678,在两个指标上均优于 VAE、Semantic-VAE 和 Mel 频谱图。WavCube-Pro 在 Emilia 大规模数据上达到 WER2.20%、SIM-o0.709。
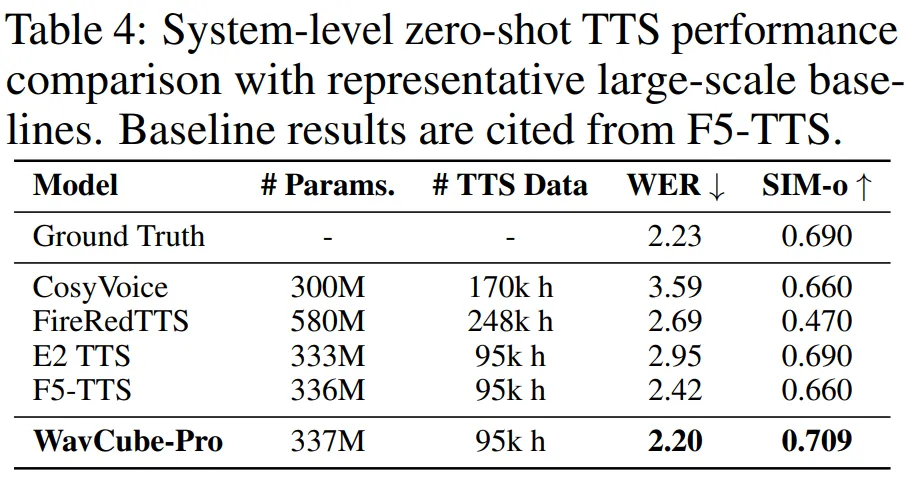
题注内容:WavCube-Pro 与 CosyVoice、FireRedTTS、E2 TTS、F5-TTS 等系统级零样本 TTS 基线的对比
在系统级对比中,WavCube-Pro(337M 参数,95k 小时数据)在 WER 和 SIM-o 上均超越 CosyVoice(300M,170k 小时)、FireRedTTS(580M,248k 小时)、E2 TTS(333M,95k 小时)和 F5-TTS(336M,95k 小时)。
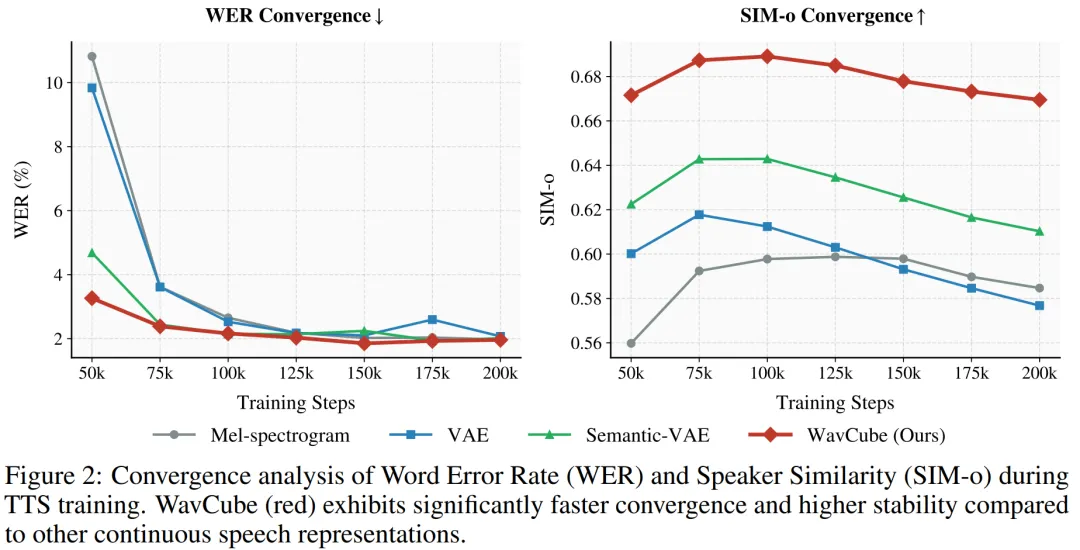
题注内容:不同表征在 TTS 训练过程中的 WER 和 SIM-o 收敛曲线对比
训练收敛分析显示 WavCube 收敛速度最快、稳定性最高。语义丰富的表征(WavCube、Semantic-VAE)整体收敛速度明显快于纯声学表征(Mel 频谱图、VAE),表明高层语义结构对扩散模型更友好。
SUPERB-SG 生成任务
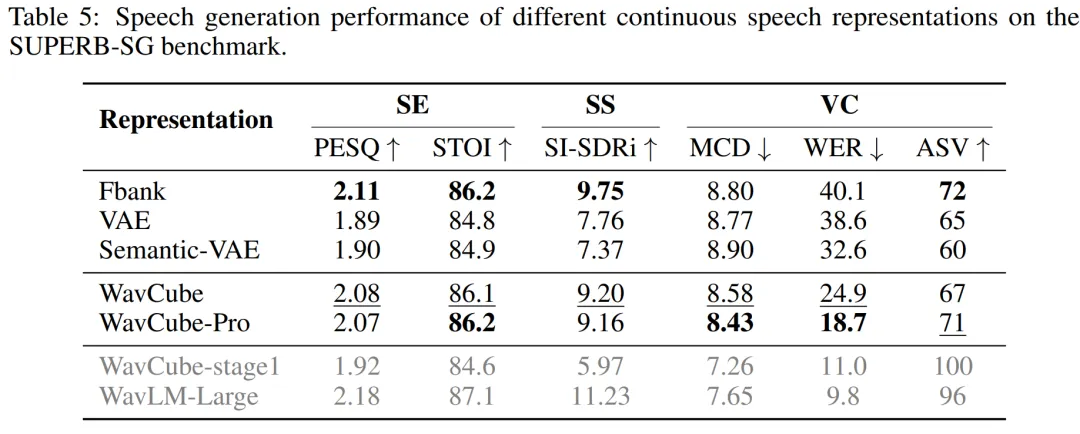
题注内容:不同连续语音表征在 SUPERB-SG 生成基准(语音增强、语音分离、声音转换)上的性能对比
在语音增强(SE)和语音分离(SS)等底层信号恢复任务上,WavCube 与经典声学表征 Fbank 持平;在声音转换(VC)任务上,WavCube 在 WER 上取得最优的18.7%,在需要语言内容和说话人身份解耦的复杂任务上展现出语义表征的优势。
核心消融:SSL 表征的困境与两阶段训练的作用
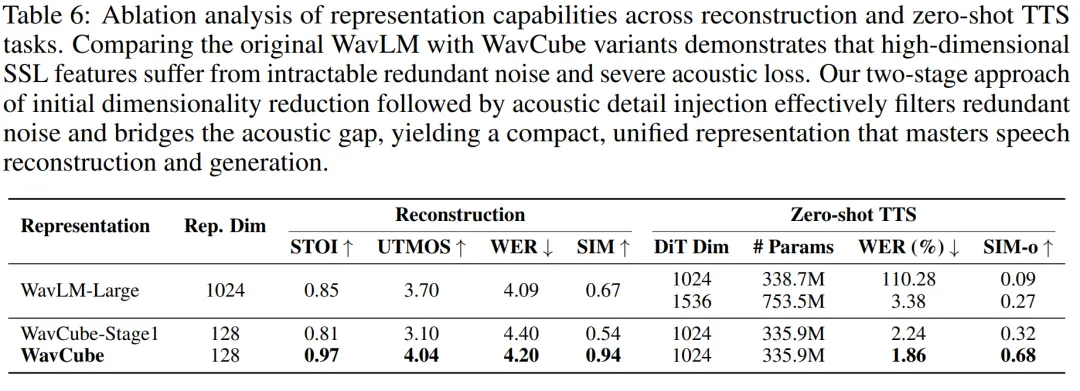
题注内容:原始 WavLM 与 WavCube 各阶段变体在重建和零样本 TTS 上的消融对比
这组消融实验是论文最关键的分析之一:
原始 WavLM-Large(1024 维)直接用于 DiT:338M DiT 完全崩溃(WER 110.28%,SIM-o 0.09);即使将 DiT 扩大到 753M 参数也仅勉强可读(WER 3.38%),但 SIM-o 仅 0.27。暴力扩大模型规模无法解决高维冗余问题。 WavCube-Stage1(仅压缩,128 维):TTS 生成显著改善(WER 2.24%),但 SIM-o 仅 0.32,声学保真度严重不足——这是 SSL 编码器天然丢弃声学细节的直接后果。 WavCube(两阶段完整,128 维):WER1.86%,SIM-o0.68,重建 STOI0.97。Stage 2 的声学注入彻底解决了保真度瓶颈。
文章小结
WavCube 提出了一种将 SSL 语义特征转化为统一生成友好表征的系统方法。通过 compress-then-enrich 两阶段训练——先压缩去冗余、再解冻注入声学细节,配合语义锚定机制保持语义流形不被声学优化侵蚀——在 128 维紧凑空间内同时实现了接近 WavLM-Large 的理解能力、高保真波形重建、以及超越 F5-TTS 等系统的零样本 TTS 性能。其核心价值在于对 SSL 特征两个内生缺陷(高维冗余、声学缺失)的系统诊断与逐一化解。
参考链接
F5-TTS 论文:Yushen Chen, Zhikang Niu, Ziyang Ma et al., "F5-tts: A fairytaler that fakes fluent and faithful speech with flow matching," Proc.ACL, 2025 论文 arXiv 页面:https://arxiv.org/abs/2605.06407 开源代码:https://github.com/yanghaha0908/WavCube 陈谐个人主页:https://chenxie95.github.io/
