
 语音小管家
本期分享国防科技大学近期被IEEE Transactions on Audio, Speech and Language Processing接收的音频表示质量评估方面的工作。
Unifying Variables in Neural Scaling for General Audio Representations via Embedding Effective Rank
【论文作者】Xuyao Deng(邓旭尧), Yanjie Sun(孙彦洁), Yong Dou(窦勇), Kele Xu(许可乐,通信作者)
【论文单位】College of Computer Science and Technology, National University of Defense Technology国防科技大学计算机学院,中国长沙
【作者邮箱】dengxuyao@nudt.edu.cn; sunyanjie21@nudt.edu.cn; yongdou@nudt.edu.cn; xukelele@nudt.edu.cn
【论文亮点】
提出统一度量指标:发现嵌入有效秩(RankMe)可作为音频领域的统一无标签度量,能够封装掩码率、模型大小、数据量、计算预算和架构配置等多种变量对表示质量的影响,解决了传统缩放定律难以处理复杂超参数和多变量复杂交互的问题。
验证幂律关系:通过大量实验证明 RankMe 与音频表示质量(HEAR 基准分数)之间存在一致且显著的幂律关系。
扩展 RankMe 应用范围:将原本用于图像任务超参数选择的 RankMe 扩展到通用音频领域,验证了其在语音、环境音、音乐等多种声音类型上的有效性。
实现早期模型筛选:证明预训练早期的 RankMe 值与模型最终性能高度相关,可在预训练早期筛选出有潜力的模型,大幅节省计算资源。
统计验证优越性:通过方差分析和多元回归分析,证明 RankMe 在控制了传统缩放变量(模型大小、数据量、计算量)后,仍然是下游性能的极强独立预测因子。同时证明RankMe 的表征能力显著优于传统缩放定律,其体现在:能处理传统缩放定律无法建模的变量、预测误差显著更小、提供了独立于传统变量的增量信息。
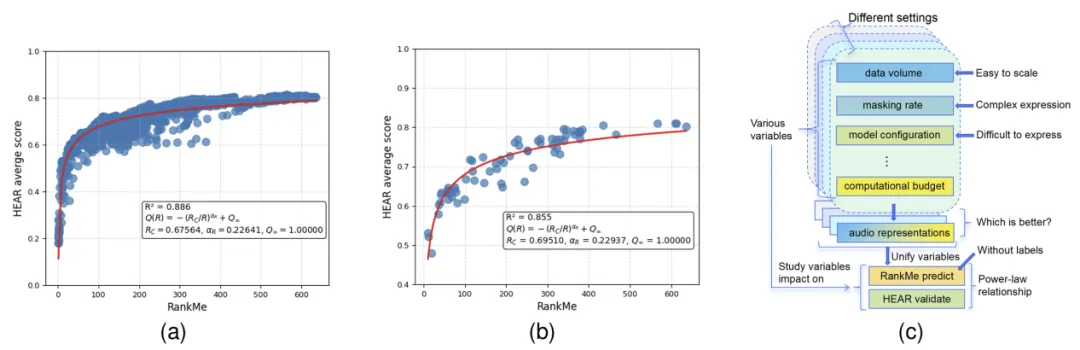
图1 嵌入有效秩可作为音频领域的统一无标签度量并与音频表示质量之间存在一致且显著的幂律关系
【引言】
神经缩放定律深刻影响了我们对模型性能与可扩展参数之间关系的理解,并已得到广泛验证。然而传统缩放定律通常只关注少数易于量化的独立变量(如模型参数数、数据量、计算预算),而实际音频表示学习中,模型性能还受到掩码率、嵌入维度、模型深度、架构设计等多种复杂超参数的影响。这些变量之间存在复杂的相互作用,部分变量(如掩码率)表现出非单调的缩放行为,难以用传统的解析公式进行建模。此外,预训练损失的高低也不能准确反映模型的实际音频表示能力。受 Cover 定理(线性分类器的性能随特征秩的增加而提高)的启发,本文提出使用嵌入有效秩(RankMe)作为统一度量,从信息论角度无监督地量化音频表示的质量。RankMe 无需数据标签,能够自然地容纳可扩展和不可扩展的变量,为解决音频领域多变量缩放问题提供了新的思路。本文通过系统的实验研究,验证了 RankMe 作为音频表示质量代理指标的有效性,并通过方差分析证明其表征能力显著优于传统缩放定律,最后提出了基于 RankMe 的早期模型筛选框架用于大幅节省计算资源。
【研究背景】
传统神经缩放定律揭示了模型参数量(N)、训练数据量(D)和计算预算(C)与模型性能之间的幂律关系。然而,这类研究通常仅聚焦于一两个易于量化的独立变量,难以应对音频表示学习中广泛存在的复杂且相互作用的超参数体系。例如,掩码自编码器中的关键超参数 —— 掩码率,与下游性能呈现出非单调关系,无法用传统幂律公式进行有效建模;而架构设计、嵌入维度、模型深度等因素的影响更是缺乏统一的量化分析框架。为解决传统矩阵秩过于刚性、离散且无法直接优化的问题,研究者提出了有效秩概念,提供了一种连续的、信息论意义上的近似度量。2023 年提出的 RankMe 方法进一步通过香农熵从概率角度量化嵌入矩阵的有效秩,最初应用于图像领域联合嵌入自监督学习(JE-SSL)的超参数选择。后续研究虽将 RankMe 初步引入语音领域,用于学习率调优和早期性能预测,但尚未系统探索其在涵盖语音、音乐、环境声的通用音频领域的适用性,更未将其作为统一度量来分析多变量对音频表示质量的综合影响。音频表示学习旨在从原始信号中提取紧凑且语义丰富的特征,支撑下游分类、分割与生成等任务。HEAR 基准的建立为不同模型提供了统一的评估标准,但目前仍缺乏对各类因素如何共同作用于通用音频表示质量的系统性实证与理论研究。与此同时,自监督音频模型的超参数空间选择增长,下游评估依赖大量标注数据且成本高昂,传统方法无法在训练早期识别优质模型配置,导致计算资源的严重浪费。在此背景下,探索一种能够统一封装多变量影响、无标签且可早期监控的表示质量度量,成为音频领域亟待解决的关键问题。
【研究方法】
本文采用掩码自编码自监督学习框架(主要是 Dasheng 架构,同时也测试了 SSAST、HuBERT、Wav2Vec2等多种架构)进行实验。数据集构建了包含约 1 亿个 10 秒音频片段(约 27.7 万小时)的大规模通用音频数据集,由 AudioSet 的不平衡子集和 ACAV100M 语料库组成。通过子采样模拟不同的数据规模,训练数据量从 55 小时到 27.7 万小时不等。使用 AudioSet 的平衡子集作为验证集。模型设置主要使用 Dasheng 架构,通过调整编码器的嵌入长度(128 到 1536)和深度(1 到 24 层)来缩放模型大小,参数范围从 27M 到 707M。解码器保持固定配置。默认掩码率为 0.75,在研究掩码率影响时,将其从 0.3 到 0.95 以 0.05 为步长进行变化。所有模型训练 746,000 步,除非在小数据集上触发早停以防止过拟合。在进行RankMe 计算时,对嵌入矩阵 Z 进行奇异值分解,将奇异值归一化为概率分布:
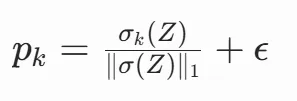
然后计算 RankMe 分数:
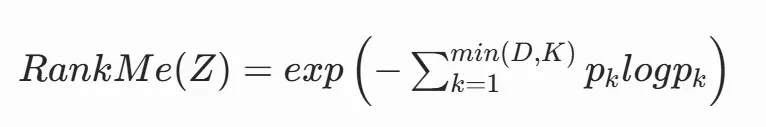
其中 ϵ 为小常数(通常取 10⁻⁷)。RankMe 分数范围为 1 到 K(嵌入长度,通常D>K),值越高表示嵌入越丰富、分布越均匀。实验中随机采样 30,000 个样本来估计 RankMe。
在下游评估时,使用 HEAR 基准的 16 个场景分类任务进行评估。最终性能报告为 16 个任务的平均 HEAR 分数。同时也单独分析了每个任务上的HEAR分数。另外对实验结果进行了统计分析,通过执行方差分析(ANOVA)、Kruskal-Wallis H 检验、Dunn 事后检验和 bootstrap 检验,以验证 RankMe 在不同超参数、架构和任务上的一致性。还进行了多元回归分析,以量化 RankMe 在控制传统缩放变量后的独立解释能力。
表1 Dasheng模型实验设置
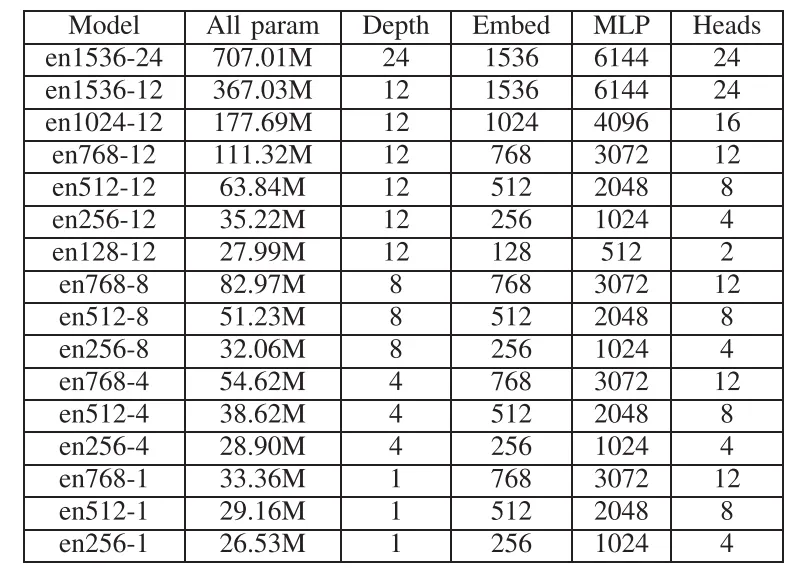
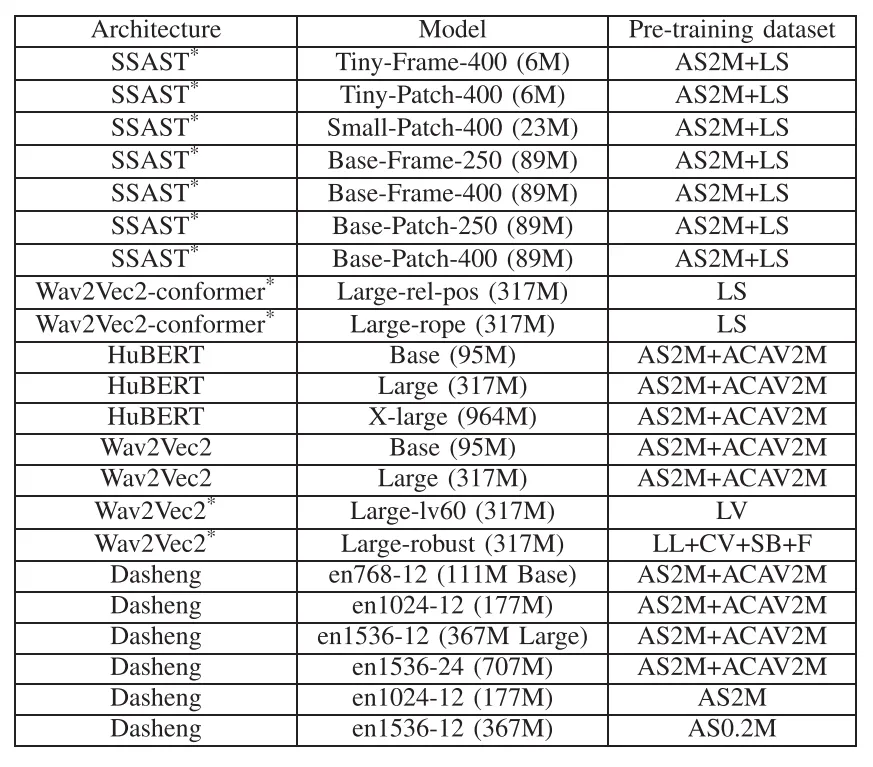
表2 不同架构模型实验设置
【实验结果】
幂律关系验证:RankMe 与 HEAR 平均分数之间呈现显著的幂律关系:
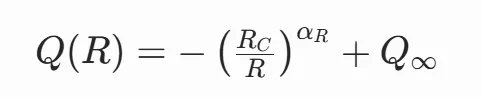
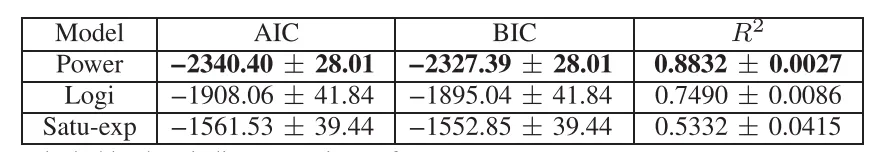
其中 R 为 RankMe 分数,Q 为 HEAR 分数。该模型的 R² 达到 0.8832,显著优于logistic模型(R²=0.7490)和饱和指数模型(R²=0.5332)。
表3 幂律关系验证
多变量统一表征:RankMe 能够统一捕捉多种变量对音频表示质量的影响,包括传统缩放定律难以处理的掩码率。尽管掩码率与 HEAR 分数之间呈现非单调关系,但通过 RankMe 转换后,仍符合上述幂律关系。
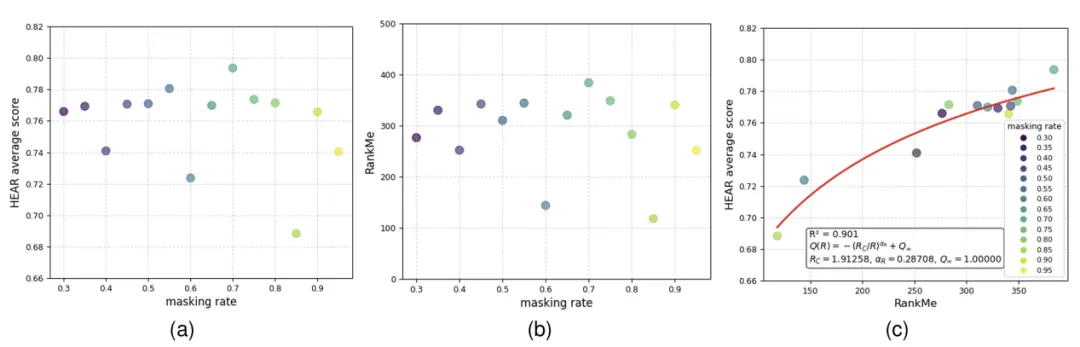
图2 RankMe 能够统一捕捉多种变量对音频表示质量的影响,包括传统缩放定律难以处理的掩码率,通过 RankMe 转换后符合幂律关系。
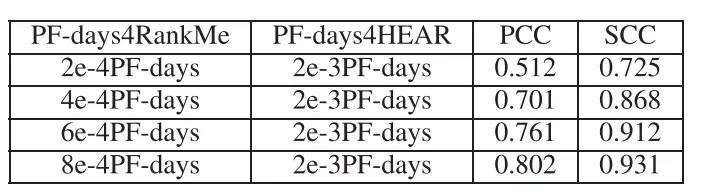
早期预测能力:预训练早期的 RankMe 值与模型最终性能高度相关。在 50k、100k、200k 和 300k 步时,RankMe 与 700k 步时 HEAR 分数的 Spearman 相关系数分别为 0.747、0.865、0.921 和 0.933。这表明可以在预训练早期筛选出低性能模型,节省大量计算资源。
表4 预训练早期的 RankMe 值与模型最终性能高度相关
(不同step)
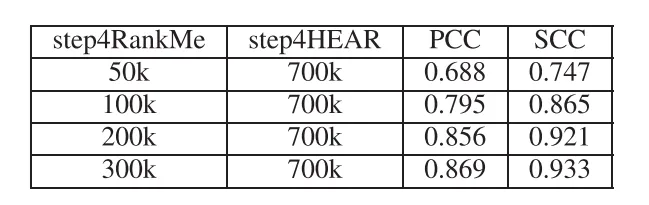
表5 预训练早期的 RankMe 值与模型最终性能高度相关
(不同计算量)
架构通用性:在 Dasheng、SSAST、HuBERT、Wav2Vec2 等多种不同架构上,RankMe 与 HEAR 分数之间都表现出幂律关系。方差分析表明,在 0.05 的显著性水平下,没有统计证据表明不同的预训练架构会影响 RankMe 的幂律模式,但每个架构有其自身独特的缩放曲线。
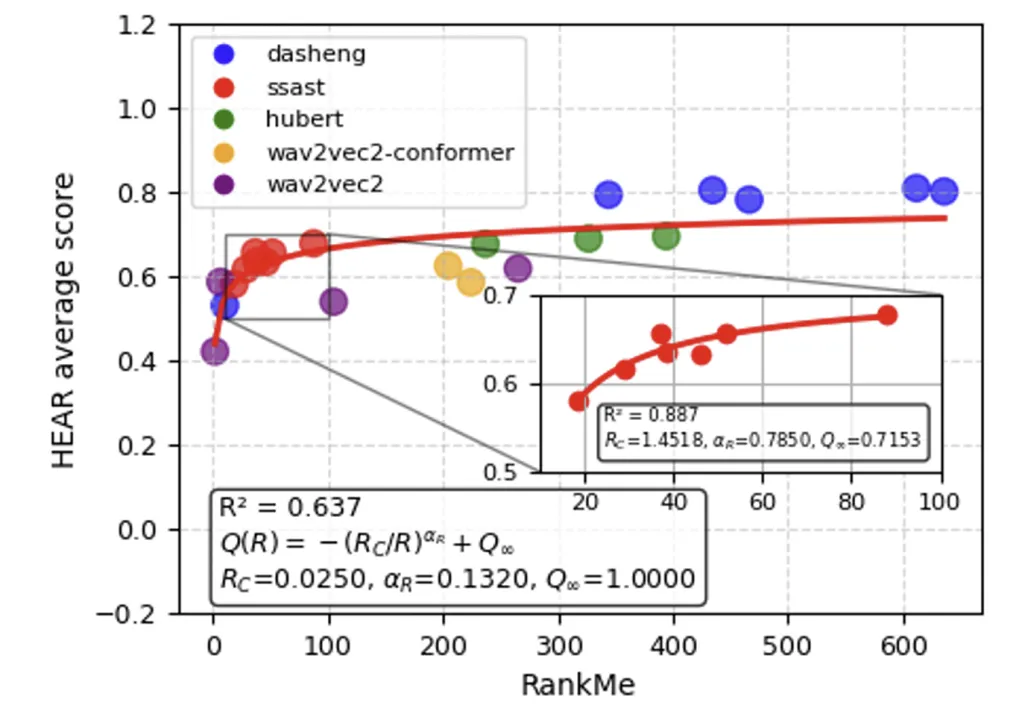
图3 RankMe 在不同框架下与 HEAR 分数之间表现出幂律关系
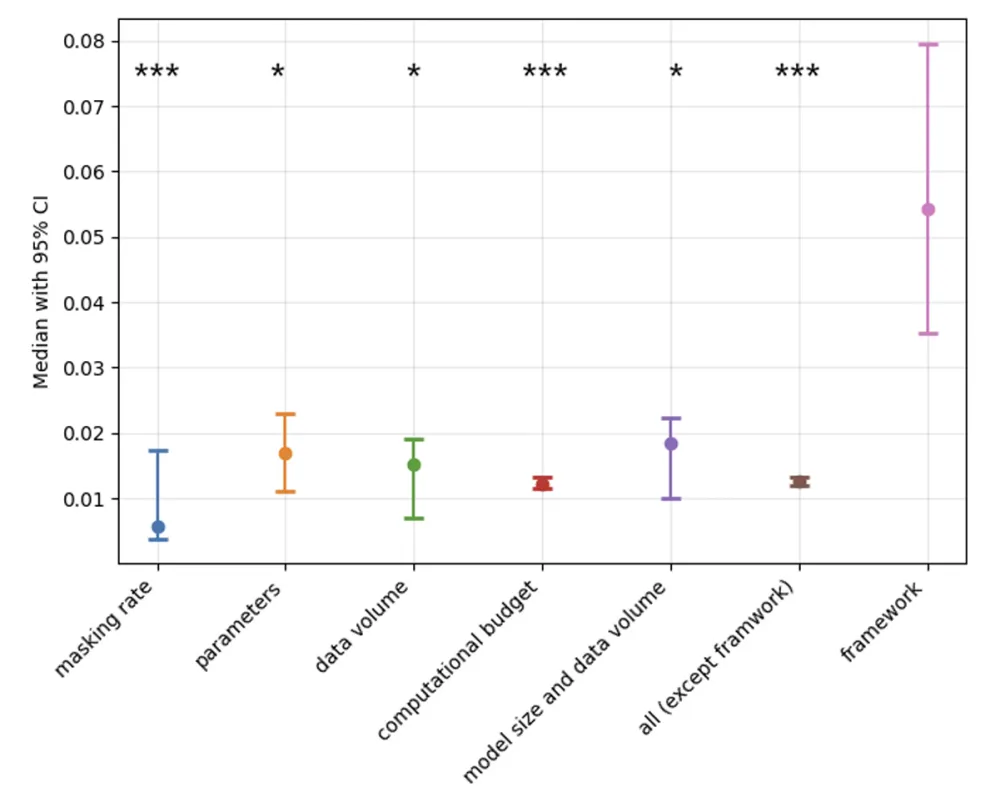
图4 方差分析表示RankMe在除架构外其他超参数上无显著差异。对于架构超参数,结合图3,每个架构有其自身独特的缩放曲线。
统计验证优越性:通过方差分析,证明 RankMe 的表征能力显著优于传统缩放定律,其体现在:能处理传统缩放定律无法建模的变量、预测误差显著更小、提供了独立于传统变量的增量信息。
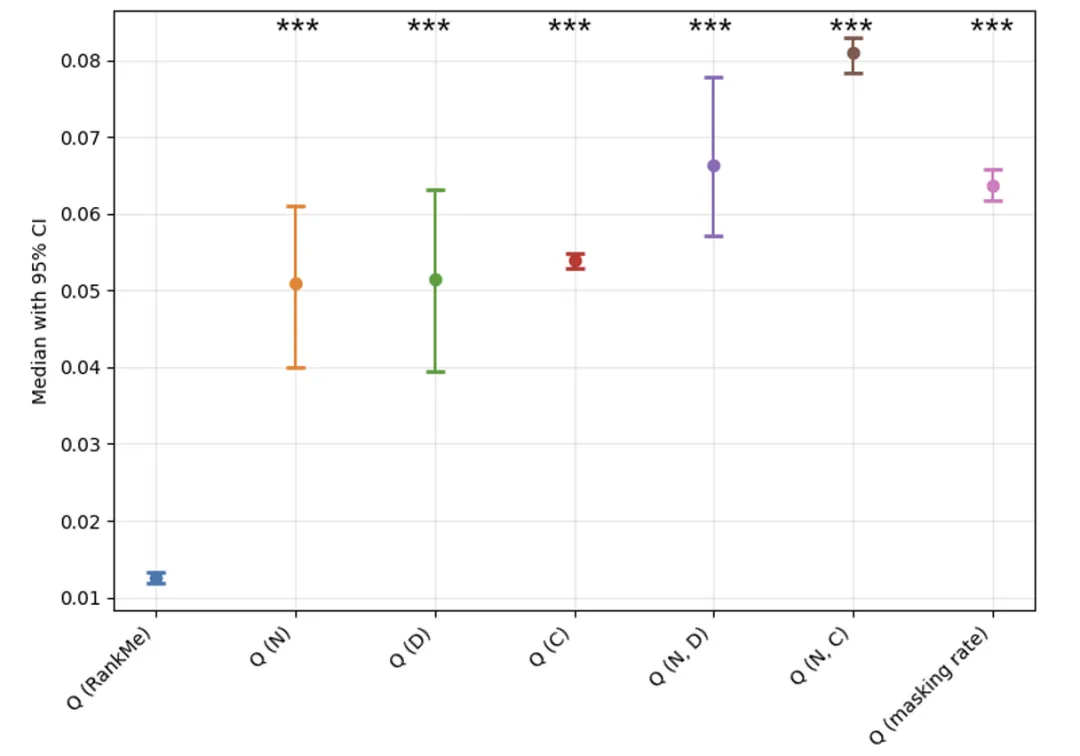
图5 RankMe 的表征能力显著优于传统缩放定律。
独立解释能力:多元回归分析显示,在控制了模型大小、数据量和计算量后,RankMe 仍然是下游性能的极强预测因子,标准化系数达到 0.9588。这表明 RankMe 捕捉到了传统缩放变量之外的、更全面的表示质量信息。
计算效率:计算 RankMe 的复杂度主要来自嵌入矩阵的奇异值分解,为 O (DK²)。在实际应用中,计算 RankMe 的成本远低于训练下游 MLP 分类器,且不需要数据标签。
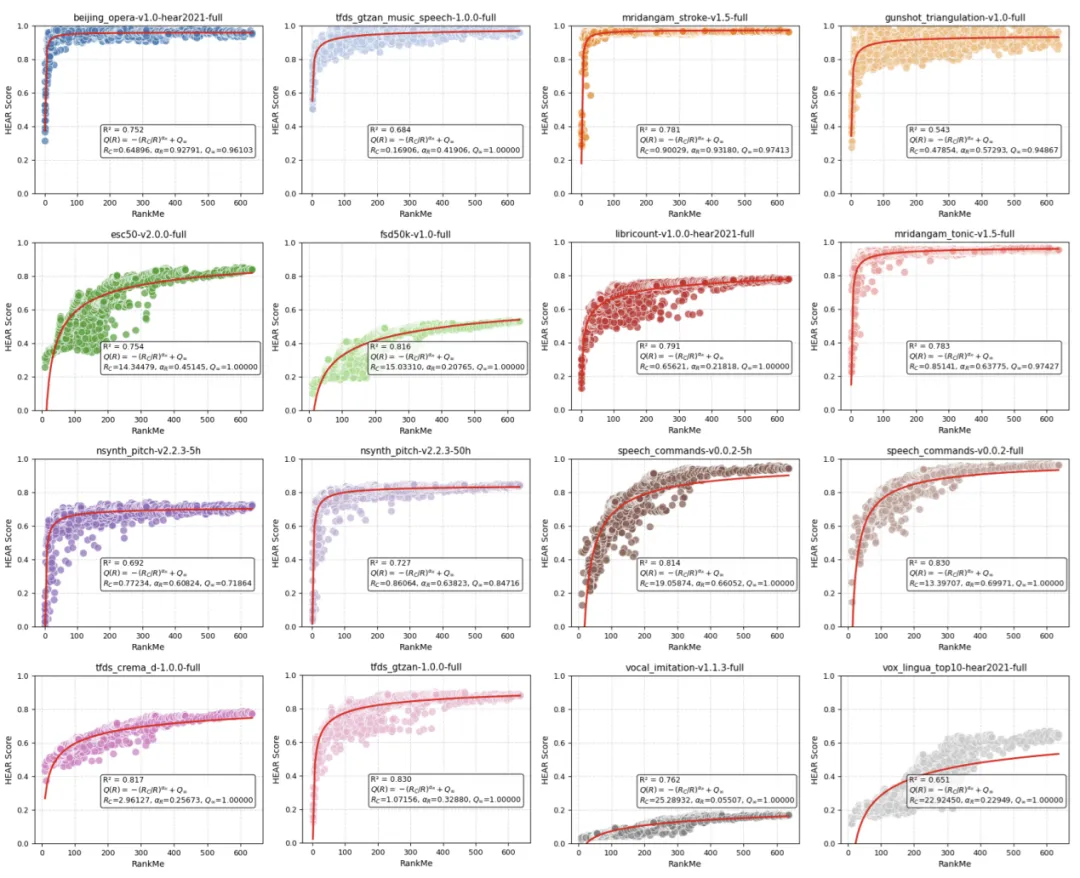
图6 RankMe 在不同数据集上展现的幂律关系
【结论】
本文提出将嵌入有效秩(RankMe)作为评估音频表示质量的无标签代理指标,解决了传统缩放定律难以处理复杂超参数和多变量复杂交互的问题。通过大量实验,证明了 RankMe 与音频表示质量之间存在一致的幂律关系,该关系在不同超参数、架构和任务上都具有良好的泛化性。RankMe 不仅能够统一封装模型大小、数据量、计算预算、掩码率和架构配置等多种变量的影响,还具有强大的早期预测能力。利用 RankMe,可以在预训练早期筛选出有潜力的模型,避免对所有模型进行完整训练,从而大幅节省计算资源。本文的工作为音频模型开发提供了一种可靠、可解释、高效且无标签的评估方法,推进了音频表示学习领域的理论理解和实践流程。未来的研究可以进一步探索不同架构之间 RankMe 缩放曲线的转换关系,以及将 RankMe 应用于更多模态和更广泛的任务中。
编辑:张雯,李雅
初审:吴锡欣,复审:朱璇,终审:凌震华
