
 语音小管家
南京大学与Video Rebirth 等单位联合提出并开源 Foley-Omni。区别于仅同时支持多种单任务的通用生成模型,Foley-Omni 进一步面向完整视频音轨生成,在统一框架中联合建模语音、音效与音乐,实现自然、同步、协调的完整声轨一次生成。
目前,Foley-Omni已开放论文、模型权重和代码,开发者可以直接体验相关能力。
完整论文:https://arxiv.org/abs/2606.03672
项目主页:https://ty0402.github.io/Foley-omni-Web/
项目地址:https://github.com/NJU-Speech/Foley-Omni
模型地址:https://huggingface.co/CocoBro/Foley-Omni
完整视频音轨生成任务
最近,闭源视频生成模型比如veo3等正在快速从“只生成画面”走向“同时生成画面和以及同步的包含语音和音效的音频”。但在学术研究中,视频相关的音频生成仍然比较割裂:
VisualTTS 主要解决人物口型和语音内容的同步 Foley / V2A 主要解决动作、事件和环境声音的生成
而真实视频往往同时包含语音、音效和背景音乐。如果这些声音分别由不同模型生成,再进行后期混合,往往会带来新的问题:语音和音效彼此干扰,不同轨道之间缺少整体协调,最终听感不像一个自然视频。
因此,我们希望重新思考这个任务:
能否不再把视频对应的音频合成拆成多个孤立任务,而是直接生成完整视频声轨?
为此,我们提出Foley-Omni:一个面向完整视频音轨生成的统一多模态音频生成模型。不仅能够支持单任务级的合成,在给定视频和文本提示,Foley-Omni 还可以一次性生成包含语音、音效和音乐的完整视频声轨。
Foley-Omni 方法设计
Foley-Omni 的方法可以概括为三个关键词:结构化条件、混合条件注入、渐进训练。
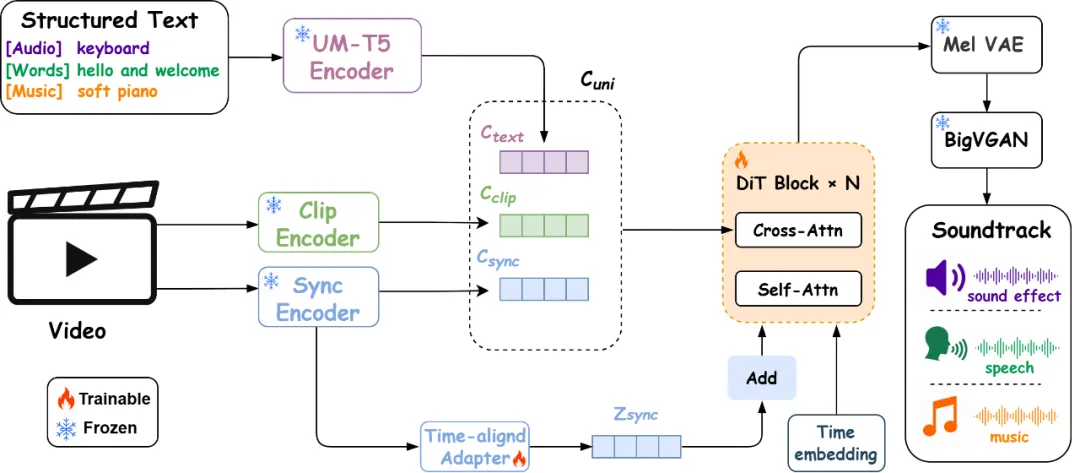
1. 结构化文本条件:统一描述语音、音效和音乐Foley-Omni 使用特定的标签来分割描述人物语音、场景音效和背景音乐的文本,然后统一注入到同一个文本编码器中,而不是对于每个类型使用不同的编码器。
2. 混合条件注入:让模型同时理解内容与同步关系完整视频音轨生成不仅需要知道画面中发生了什么,还需要让声音与动作、口型和场景节奏对齐。为此,Foley-Omni 采用混合条件注入方式:一方面,将结构化文本、视频语义特征和同步特征作为统一条件上下文,通过 cross-attention 注入 DiT 主干,为生成过程提供全局语义控制;另一方面,将同步特征进一步对齐到音频 latent 序列并相加,为声音事件和视觉动作的同步提供更细粒度的引导。
3. 渐进训练:从单任务合成走向完整视频音轨为了减少多任务之间的相互干扰,Foley-Omni 采用三阶段训练策略:先学习文本到语音、音效和音乐的基础能力,再引入视频条件学习 V2A 和 VisualTTS,最后在多组件音轨样本上微调,逐步过渡到完整视频声轨生成。
因此,Foley-Omni 不只是一个同时支持多种任务的通用音频模型,更进一步面向完整视频音轨生成,将语音、音效和音乐统一到同一个生成过程中,实现一次性生成自然、同步、协调的完整声轨。
数据构建以及V2ST-Bench
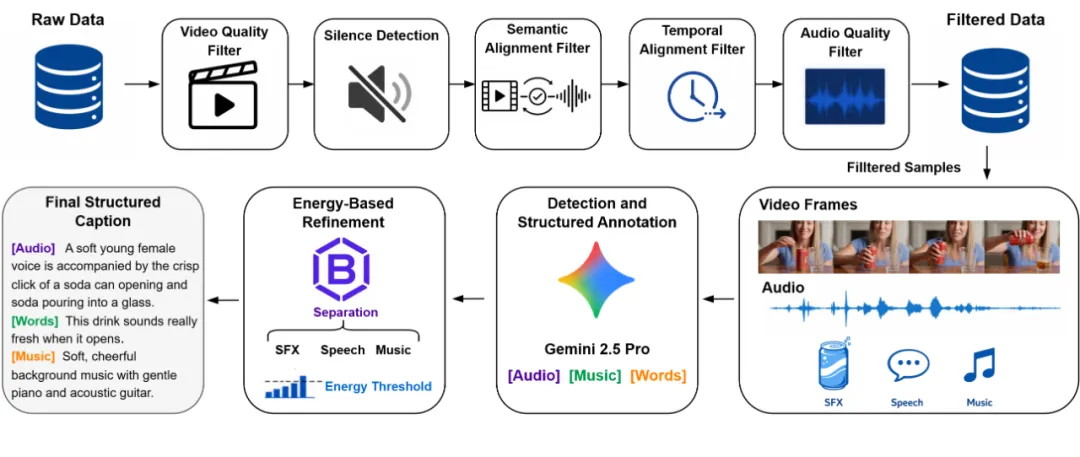
为了支撑完整视频音轨生成的训练,Foley-Omni 首先构建了一套视听数据筛选与结构化标注流程。我们从公开说话人视频、开源视听数据和公开视频中收集候选样本,并通过视频质量、音频质量、音画语义一致性等指标进行过滤;随后使用大模型生成[WORDS]、[AUDIO]和[MUSIC]结构化标注,并结合声源分离,去除声音组件缺失、标注不准的样本。
在此基础上,我们构建了V2ST-Bench,用于评估完整视频音轨生成。该 benchmark 聚焦语音、音效和音乐共存的视频场景,保留至少包含两类音频组件的高质量样本,最终包含 300 个视频-音频-文本样本。相比传统单任务评测,V2ST-Bench 更关注完整声轨中的语音可懂度、音画一致性、整体听感质量和多声音协调性。
实验结果
由于目前还缺少直接面向完整视频音轨生成的开源基线,我们构建了两种组合式 pipeline 在V2ST-Bench上进行对比:分别生成语音、音效和音乐,再进行后期混合。结果显示,Foley-Omni 在完整视频声轨生成中表现更稳定。相比组合式方案,它能够减少多轨混合带来的相互干扰,在音画一致性、时间同步和整体听感上取得更好的结果。例如,Foley-Omni 在 V2ST-Bench 上取得了 0.33 的 IB,并获得最低的 DeSync;主观评测中,音频质量、语义一致性和时间同步性MOS也均优于组合式 pipeline。
同时,单任务级生成评测中Foley-Omni的表现也极具竞争力。在文本条件任务中,模型在 AudioCaps 上取得 0.46 的 CLAP,在 LibriSpeech-PC 上取得 2.31 的 WER,并在 MusicCaps 上保持稳定的音乐生成表现,说明其在 TTA、TTS 和 TTM 等任务上依然具有扎实的基础能力。对于视频条件任务,Foley-Omni 在 VGGSound 上相比最新专家模型取得最优的DeSync,展现出更好的视听同步能力;在 VisualTTS 零样本场景中也取得最优性能,同时兼顾了较好的泛化性和语音可懂度。
整体来看,Foley-Omni 在完整视频音轨生成中能够全面超越组合式混合基线,同时在任务级音频合成上与专用专家模型相比保持强竞争力
总结
Foley-Omni 将语音、音效和音乐统一到同一个生成框架中,使模型能够从任务级音频合成进一步走向完整视频音轨生成。实验结果和 Demo 展示表明,Foley-Omni 在保留单任务生成能力的同时,能够围绕同一视频生成更加自然、同步、协调的完整声轨。
我们希望 Foley-Omni 能为开源社区提供一个可复现的完整视频音轨生成方案,也为未来的视频生成、自动配音和多模态内容创作提供新的基础。
