
 语音小管家
Cartesia 推出新一代实时语音端到端模型 Sonic-3.5 与 Ink-2。该系列模型基于状态空间模型架构开发,通过单一 API 整合语音转文字与文字转语音能力,旨在消除实时语音智能体在响应速度、自然度与准确度之间的传统架构折衷。
⏩双模型均位居第三方评测榜首
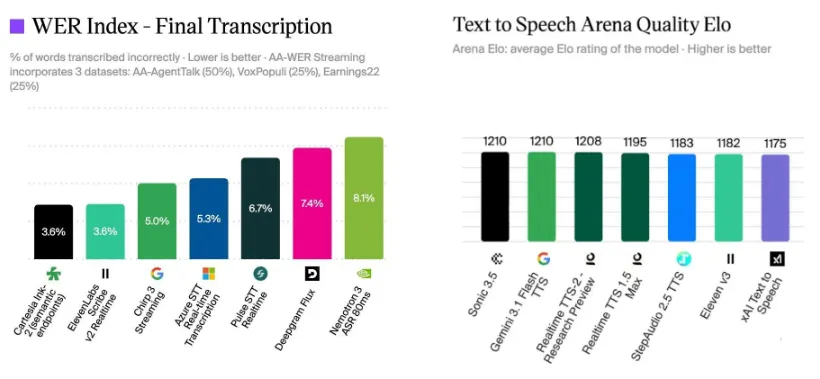
据Artificial Analysis发布的流式语音转文字排行榜和实时语音合成排行榜显示:
Ink-2在语音转文本(STT)赛道排名第一,字错率(WER)为3.6%;
Sonic-3.5在文本转语音(TTS)赛道排名第一,首音频延迟约82ms(P90首字节响应延迟为100ms)。
Cartesia成为目前唯一一家在“听”与“说”两个核心语音任务上同时占据榜首的AI提供商。
⏩关键性能指标
🎧Sonic-3.5(文本转语音)
首音输出时间(Time to First Audio)控制在90ms以内,实测榜单数据约82ms;
出厂支持42种语言,无需预处理即可正确朗读包含字母数字混合的英文异音词(如“AI 2.0”“Room 3B”);
具备较强的韵律和情感表现力,适用于实时对话场景。
🎤Ink-2(语音转文本)
字错率(WER)为3.6%;
转录延迟约100ms;
引入原生轮次检测(Native Turn-Detection),基于句意和语义判断用户是否结束发言,而非仅依赖静音时长;
噪声处理机制有所增强;
目前仅支持英文,多语言版本计划后续推出。
两款模型在设计上支持双向流式协同,以降低因拼接不同供应商服务而产生的传输延迟和系统损耗。开发者可通过单个API同时调用二者。
⏩技术架构
与主流语音模型采用Transformer架构不同,Sonic-3.5和Ink-2均基于状态空间模型(State Space Model, SSM)开发。SSM在长上下文推理和高并发扩展方面具有理论优势,计算开销相对较低。
这一技术路线源自Cartesia团队在斯坦福AI实验室多年的研究成果。其首席科学家兼联合创始人Albert Gu是Mamba架构的主要作者之一,Mamba被视为Transformer的一种高效替代方案,在序列预测任务中可实现较低的延迟和较高的精度。
⏩团队与公司背景
Cartesia成立于2023年,由斯坦福AI实验室的五位成员共同创立,包括四位博士生及他们的导师Chris Ré。联合创始人中,Albert Gu(华人)和Brandon Yang(华人)为技术核心,后者曾在谷歌大脑团队工作;CEO Karan Goel(印度裔)为斯坦福博士,硕士期间曾获Siebel Scholar奖学金。
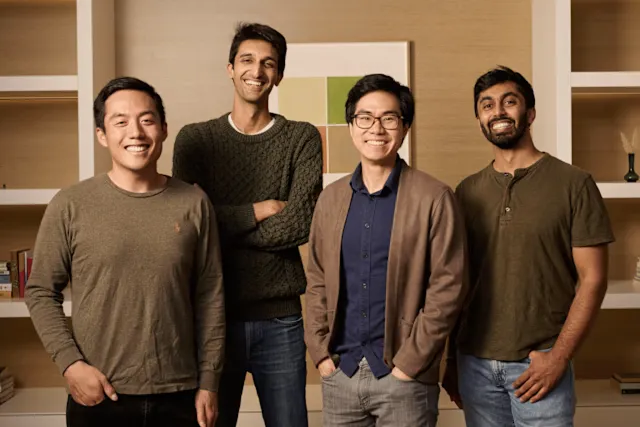
团队过去四年将SSM理论扩展至文本、音频、视频、图像和时间序列等多种模态,并在此基础上选择了语音作为首个商业化方向。Cartesia为企业提供AI语音平台,支持开发者基于Sonic和Ink构建实时语音Agent。
⏩小 结
Cartesia此次同时发布Sonic-3.5和Ink-2,并在第三方评测中分别取得TTS和STT赛道榜首,表明其在实时语音交互的低延迟和识别准确率两方面具备一定技术优势。其采用的SSM架构区别于Transformer路线,能否在更广泛的企业场景中保持竞争力,仍有待市场进一步验证。多语言支持和更丰富的应用生态,将是其下一步发展的关键观察点。
