
 语音小管家
AudioCC交我学
作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。我们将用通俗易懂的语言拆解复杂理论,用数据与实验结果验证技术价值,带你快速了解最新、最有趣的学术论文,打破学术与大众之间的壁垒,让你在碎片化的时间里也能 get 到前沿知识!
一、引言
近年来,文本到语音(Text-to-Speech, TTS)技术飞速发展,从“能发声”逐步迈向“会表达”。如何让合成语音不仅自然流畅,还能按照用户需求精准控制风格、情感、音色乃至副语言细节,成为学术界和工业界关注的热点。在最近的一系列工作中,研究者们探索了两条不同的控制路径:宏观控制(通过自然语言描述或标签指定整体风格)和精细控制(在词级或帧级对韵律、情感强度、音效等进行细粒度调节)。本文基于近期多个代表性工作,梳理这两条路线的最新进展。
二、宏观控制:用自然语言“描述”想要的语音
宏观控制的核心是让用户用自然语言或风格标签来指定语音的整体特征,如“一个十几岁女孩用高亢明亮的声音快速说话”。系统需要理解描述并生成符合要求的语音。
1. CapSpeech:大规模风格标注数据集与交叉注意力交互
CapSpeech(Wang et al., 2025)的核心贡献是构建了超过1000万条的“语音-风格描述”配对数据。预训练数据来自Emilia、GigaSpeech等开源集,通过WER、SNR筛选,并利用自动化模型(w2v2-age-gender、PENN)提取年龄、性别、基频、表现力等闭集属性,再交由Mistral-7B-Instruct生成多样化的自然语言描述。针对下游任务,他们还构建了情感、口音、聊天代理(专业配音演员录制25小时)及音效(咳嗽、笑声等10种)等特化数据集。为多种控制任务提供丰富且高质量的数据支持。
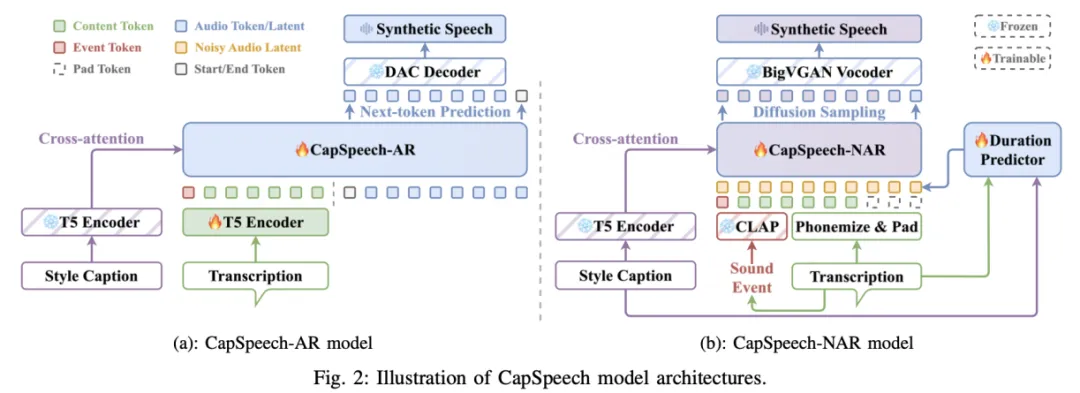
模型方面,CapSpeech尝试了基于Parler-TTS的自回归架构和基于F5-TTS的非自回归架构,移除了原来zero-shot任务中的prompt音频通道,而添加了caption文本通过Cross Attention的方式加入模型的通道,进而实现相应的音色控制。实验表明其具有较为良好的风格控制能力,但局限在于:细微风格描述仍有不足,风格迁移质量不稳定,目前仅支持英文且不提供语音克隆。
2. BatonVoice:LLM驱动的结构化声学特征控制
BatonVoice(Wang et al., 2025)提出了一种“操作主义”框架——利用大语言模型的语义理解能力,将自然语言指令转化为结构化的声学特征表(如音高、语速、能量等词级标签)。其模型以Qwen3-1.7B为骨干,采用CosyVoice2语音tokenizer,分三阶段训练:预训练(VoxBox)、SFT(500小时高表现力数据,带词级声学特征)、偏好优化(近万条对比数据)。
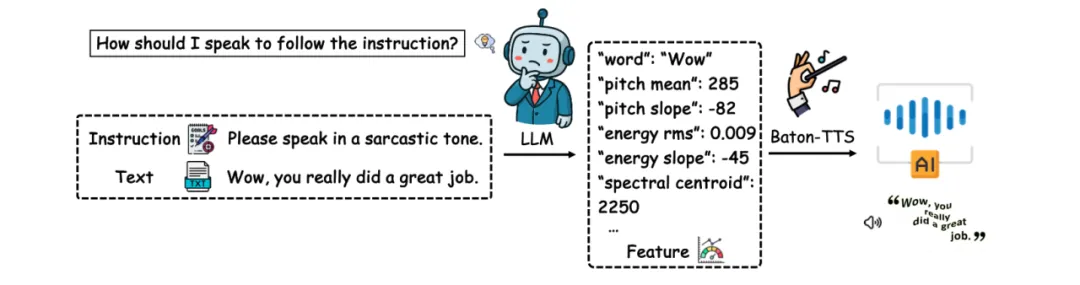
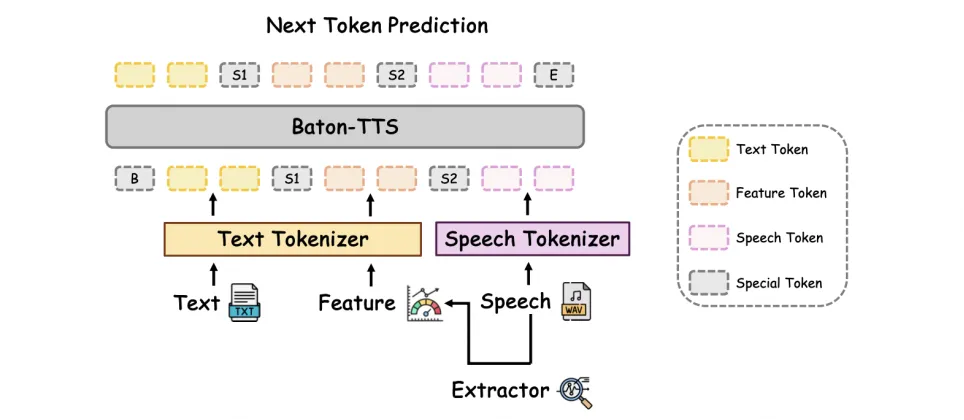
该方法在情感控制和跨语言能力上表现出色,但训练流程复杂(高度依赖LLM),且精细控制能力尚待验证。
3. Qwen3-TTS:语义-声学双轨建模,支持自然语言交互
Qwen3-TTS(Hu et al., 2026)提出了一种“语义-声学双轨”统一建模框架,核心在于设计了两款互补且深度融合语义与声学信息的 Tokenizer,并以此构建高表现力、低延迟的流式语音合成系统。其中,25 Hz 版本建立在 Qwen2-Audio 的强语义表征之上,采用单码本(codebook size=32 k)设计。该单码本并非传统意义上的纯语义或纯声学 token,而是将语音中的副语言信息、韵律线索与说话人音色细节高度压缩在同一个离散空间中,属于“重语义”的高信息密度表示,能够精细刻画丰富的语音细节。为了实现流式生成,25 Hz 版本搭配了一个 Block-wise DiT(Diffusion Transformer)解码器。DiT 通过多步去噪带来极强的波形重构能力,但必须依赖固定长度的“前瞻(Look-ahead)”上下文来维持生成连贯性,因此首包延迟(TTFA)相对略高。12 Hz 版本则采用多码本残差量化设计,共 15 组码本,每组尺寸 2048,形成层次化解耦:第一层码本专门负责粗粒度的语义结构,后续层则递进编码音高、能量、频谱包络等精细声学细节。最精妙的是,该版本舍弃了需要未来信息的解码器,转而采用纯因果卷积网络(Causal ConvNet)进行波形解码。此解码器在时序上严格因果,可以“看到一个 Token 就立即生成一段高质量波形”,无需任何 Look-ahead 缓存,将等待时间极大压缩,为实现 97 ms 首包延迟的流式体验提供了关键支撑。
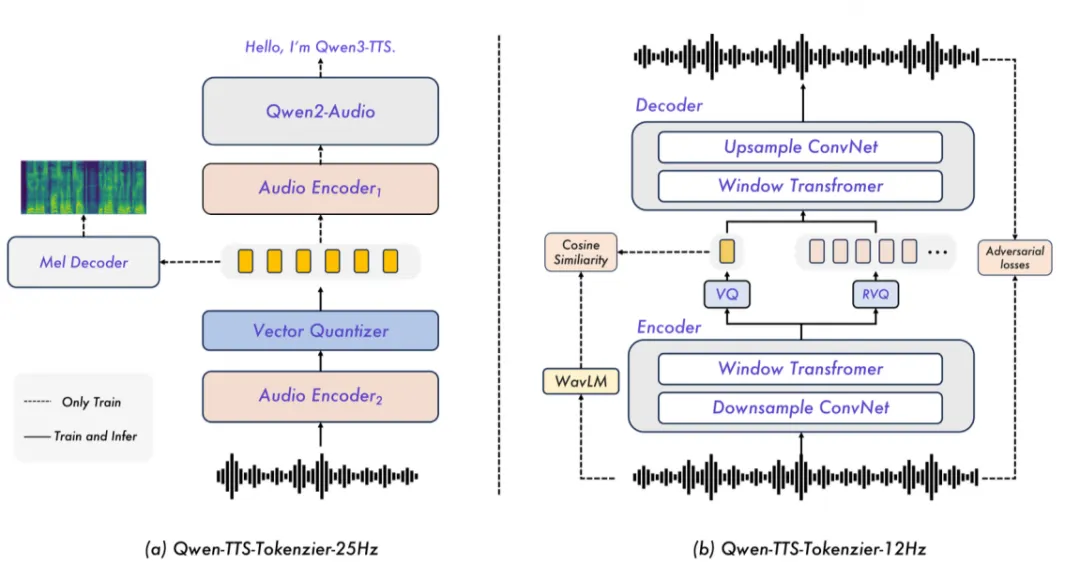
在模型主干部分,Qwen3-TTS 提出了 Dual-Track LM(双轨语言模型):它将文本 Token 与声学 Token 在通道维度进行拼接,构成一条交替融合的联合序列。当模型接收到一个文本 Token 时,会即刻预测对应的声学 Token,本质上实现了文本到声学的端到端直路映射,免去了传统级联系统的信息瓶颈。针对 12 Hz 版本,团队进一步引入了 多 Token 预测(Multi-Token Prediction, MTP) 模块。其机制是:主模型先自回归生成最重要的第 0 层语义码本,然后由 MTP 头一次性“并行补全”所有的残差码本。这种“主干预测骨架、MTP 一次性补充细节”的并行解码策略,显著提升了生成吞吐量,同时保留了层次化解耦带来的声学精细度。此外,在指令微调阶段,模型以一定概率触发 thinking 机制:即在生成语音序列前插入少量隐式“思考 Token”,让模型完成全局声学规划(例如综合自然语言描述中的风格、情感、语速等约束),从而有效提升了可控性。
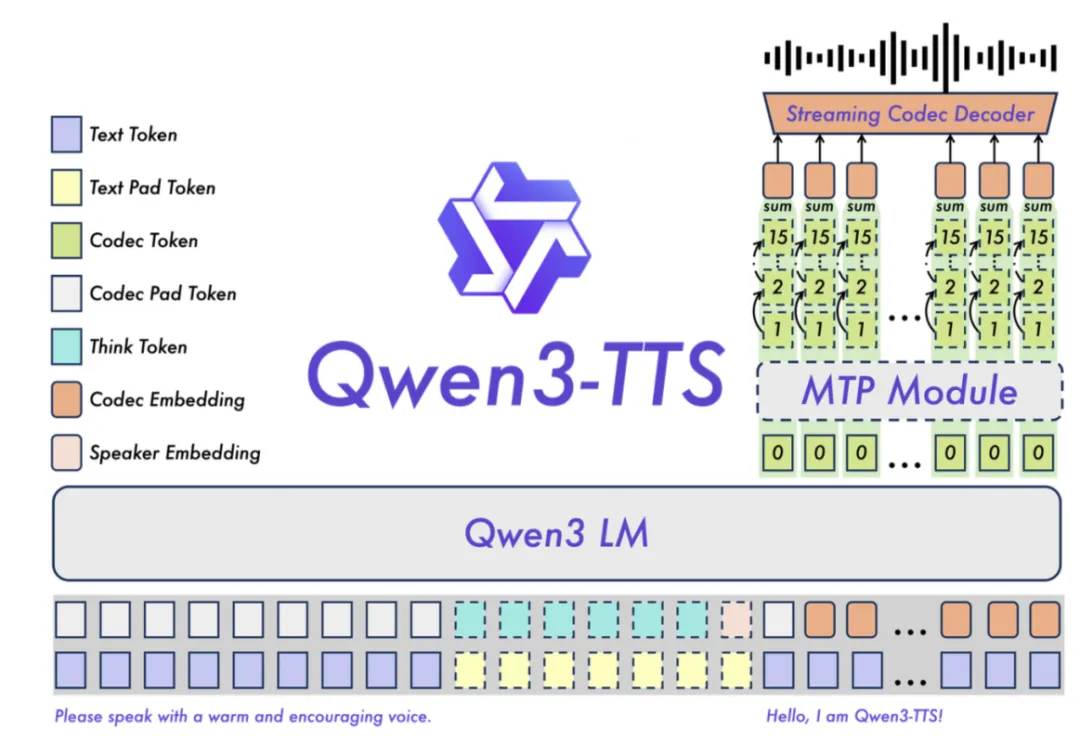
综合而言,Qwen3-TTS 实现了当前 SOTA 的自然度和声学细节还原能力,并原生支持自然语言风格控制、超低延迟流式推理(首包 97 ms)以及仅需 3 秒音频的语音克隆。不过,在可控性方面仍有提升空间:因离散码本空间有限,音色设计的多样性受到一定制约;同时,基于自然语言的粗粒度指令在精细控制(如精确调整重音、停顿、局部能量)上难度较高,这为未来基于“thinking tokens”和混合粒度指令的演进指出了方向。
4. OmniVoice:扩散语言模型实现超多语种零样本合成
OmniVoice(Zhu et al., 2026)面向600多种语言的零样本TTS,采用双向Transformer(从Qwen3-0.6B初始化)和Higgs-audio tokenizer(8码本)。其解码策略为全码本掩码+迭代式非掩码解码,置信度引导32步生成,RTF低至0.03。除了基础合成,还支持通过去噪步数、token操作来控制音色设计和副语言。
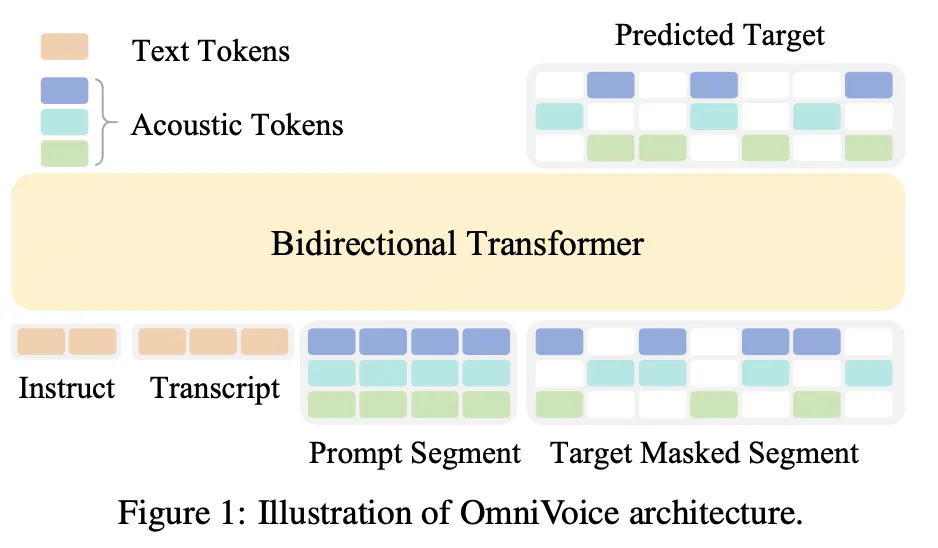
虽然自然度接近SOTA(UTMOS略低于Qwen3-TTS),但长文本表现下降,细腻表达刻板,且控制方式局限于token级操作,不支持自然语言。
三、精细控制:词级、帧级甚至音效级的精准调节
精细控制追求对语音的局部细节(如特定单词的情感强度、某个位置的咳嗽声、音高轮廓)进行独立调节,同时保持整体自然性。
1. TADA:文本-声学双对齐,实现0幻觉长音频生成
TADA(Dang et al., 2026)的核心是CTC强制对齐和局部注意力掩码机制。 CTC(强制对齐模块,在文本和声学 Token 序列之间建立单调、无歧义的硬对齐映射。基于此,解码器便无需再学习“文本到声学”的软注意力漂移,从根本上杜绝了传统自回归模型中因注意力错位而产生的添加、遗漏或重复字词等幻觉。在解码过程中,每个位置的注意力接受域被限制在以对齐位置为中心的极小窗口内,完全阻断远程注意力分支。这一方面强制模型在生成当前语音帧时只聚焦于紧邻的文本-声学上下文,避免因长程依赖衰减而导致内容漂移。
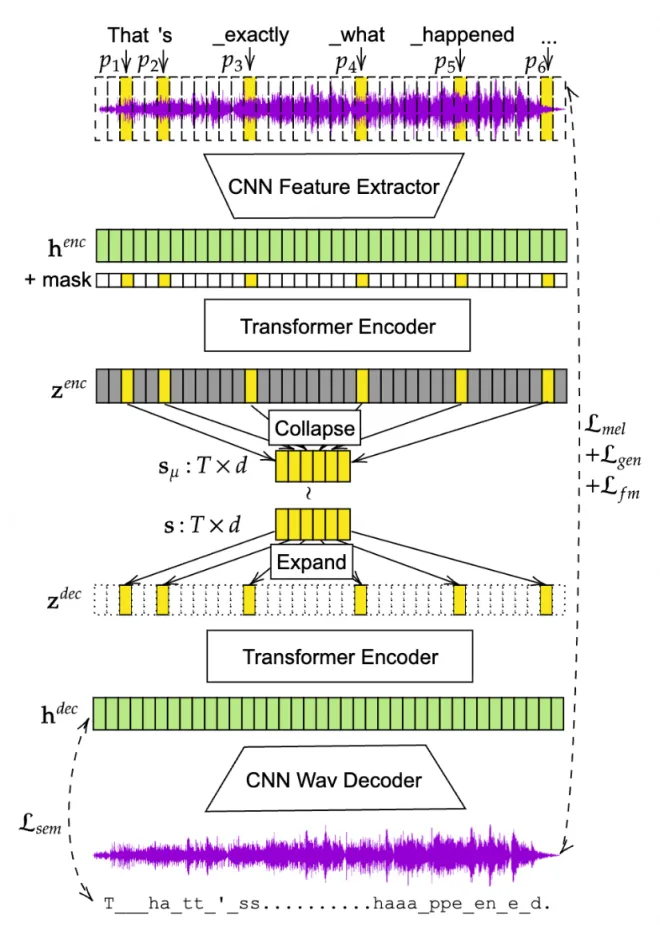
TADA 实现了1:1的文本-声学token对齐,完全消除语音合成中普遍存在的幻觉。它支持一次性生成最长700秒的音频,RTF为0.09。应用场景包括有声书、长对话等。但缺点是音频质量仍有差距,且存在音色飘逸(不稳定)问题。
2. FishAudio S2:双自回归+多码本,支持自然语言精细化控制
FishAudio S2(Liao et al., 2026)采用10层RVQ并注入w2v-BERT语义信息。核心创新是双自回归架构:Slow AR(Qwen3-4B)负责高层次规划,Fast AR(4层Transformer)负责快速声码,二者通过MCF模块互补。他们还微调了Qwen3-Omni-30B作为ASR奖励模型,训练数据超1000万小时、50种语言。
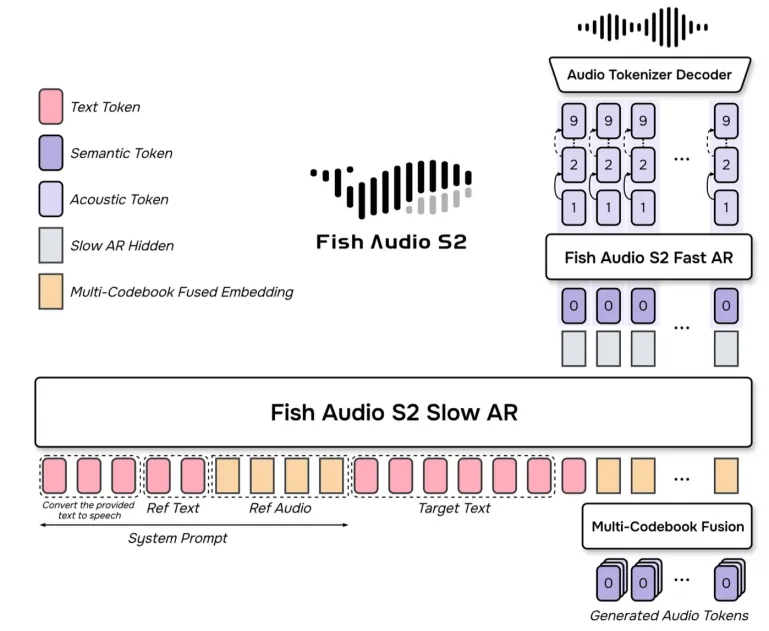
该模型实现了SOTA自然度和0.195的RTF,并支持自然语言指令对语速、情绪等做精细控制。但精细控制能力仍不够完美(情绪、音量等复杂调节)。
3. Affectron:情感与副语言深度融合的情感语音合成
Affectron(Cho et al., 2026)专注于情感语音与非语言发声(笑声、叹息等15种NVs)的协同合成。基于VoiceCraft骨干,他们从EARS数据集中提取100小时干净语音和4小时NVs,设计了情感驱动的Top-K NV匹配、情感感知路由和NV结构掩码,迫使模型利用语言上下文作为条件。
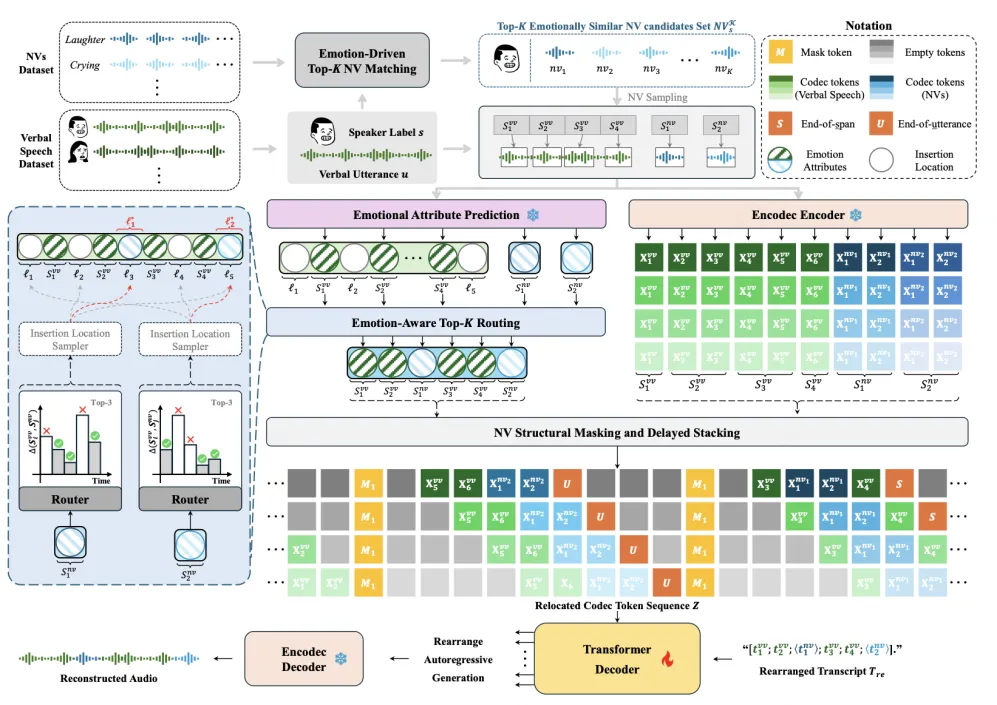
该方法在情感匹配和自然融合方面展现出潜力,但受限于基线模型能力,整体表现力和自然度仍有提升空间。
四、总结与展望
从上述工作可以看出,宏观控制路线受益于大语言模型的语义理解和大规模高质量数据集的构建,能够实现以自然语言为接口的灵活风格控制;精细控制路线则通过对齐技术、双自回归、情感-副语言联合建模,在词级、帧级乃至音效级上追求更精准的调节能力。
当前挑战依然明确:
数据:需要更高质量、更高精度标注的数据集(尤其是多语言、多情感、带副语言标签)。
控制定位:如何同时支持全局风格和局部细节控制,且不相互干扰。
表现质量:精细控制后仍要保持衔接自然、表达多样,避免机械感。
未来,数据驱动与更精巧的模型设计将继续推动TTS从“可控”走向“高表现力”。让我们期待语音合成真正成为随心所欲的表达工具。
五、参考文献
[1]Wang H, Hai J, Chong D, et al. Capspeech: Enabling downstream applications in style-captioned text-to-speech[J]. arXiv preprint arXiv:2506.02863, 2025.
[2]Wang Y, Ma R, Chen X, et al. BatonVoice: An Operationalist Framework for Enhancing Controllable Speech Synthesis with Linguistic Intelligence from LLMs[J]. arXiv preprint arXiv:2509.26514, 2025.
[3]Hu H, Zhu X, He T, et al. Qwen3-TTS Technical Report[J]. arXiv preprint arXiv:2601.15621, 2026.
[4]Zhu H, Ye L, Kang W, et al. Omnivoice: Towards omnilingual zero-shot text-to-speech with diffusion language models[J]. arXiv preprint arXiv:2604.00688, 2026.
[5]Dang T, Rao S, Gupta A, et al. TADA: A Generative Framework for Speech Modeling via Text-Acoustic Dual Alignment[J]. arXiv preprint arXiv:2602.23068, 2026.
[6]Liao S, Wang Y, Liu S, et al. Fish audio s2 technical report[J]. arXiv preprint arXiv:2603.08823, 2026.
[7]Cho D H, Oh H S, Kim S B, et al. Affectron: Emotional Speech Synthesis with Affective and Contextually Aligned Nonverbal Vocalizations[J]. arXiv preprint arXiv:2603.14432, 2026.
供稿 | 周庭孝,编辑 | 方楠,审核 | 韩冰
