
 语音小管家
论文题目:SemanticAudio: Audio Generation and Editing in Semantic Space
Demo:https://semanticaudio1.github.io/
论文地址:https://arxiv.org/abs/2601.21402
近几年,文本生成音频(Text-to-Audio, TTA)技术发展很快:只需要输入一句自然语言描述,模型就能生成相应的环境声、动作声、自然声或复杂声音场景。这类技术在游戏、影视后期、虚拟现实、内容创作和人机交互中都有很大的应用潜力。
不过,一个核心问题仍然存在:很多模型生成的声音虽然听起来不错,却不一定真正“听懂”了文本。尤其当提示词里包含多个声音事件、事件顺序或细粒度属性时,模型可能会漏掉某个事件、混淆先后关系,或者生成与描述不够匹配的音频。
我们的论文提出了SemanticAudio,一个在语义空间中进行音频生成和编辑的新框架。它的核心思想很直观:不要一开始就直接生成复杂的声学细节,而是先在更高层的语义空间里规划“会发生什么声音、什么时候发生、顺序是什么”,再把这个语义计划渲染成高质量音频。换句话说,SemanticAudio 让模型先把声音场景“想清楚”,再把它“说出来”。
一句话概括:SemanticAudio 将文本到音频生成拆成“语义规划”和“声学合成”两个阶段,在保持音质的同时显著提升文本与声音事件的对齐,并支持无需训练的文本引导音频编辑。
Motivation
现有主流文本生成音频方法通常直接在声学潜空间中建模,例如基于VAE 的压缩声学表示。这种做法很适合保留音色、纹理、频谱等低层声学细节,但它也把“声音是什么”和“声音怎么听起来”混在了一起。
问题在于,文本描述首先表达的是高层语义:比如“狗叫之后传来汽车鸣笛”,重点是声音事件的身份、出现与顺序,而不是一开始就指定所有声学纹理。若模型直接在高维声学空间中生成,它需要同时解决语义理解和声学渲染两个问题,因此更容易出现文本对齐不足。
我们希望构建一个更加符合人类创作流程的生成范式:先确定声音场景的整体结构,再补充具体声学细节。这也是SemanticAudio 选择引入高层语义空间的原因。
方法:两阶段语义音频生成框架
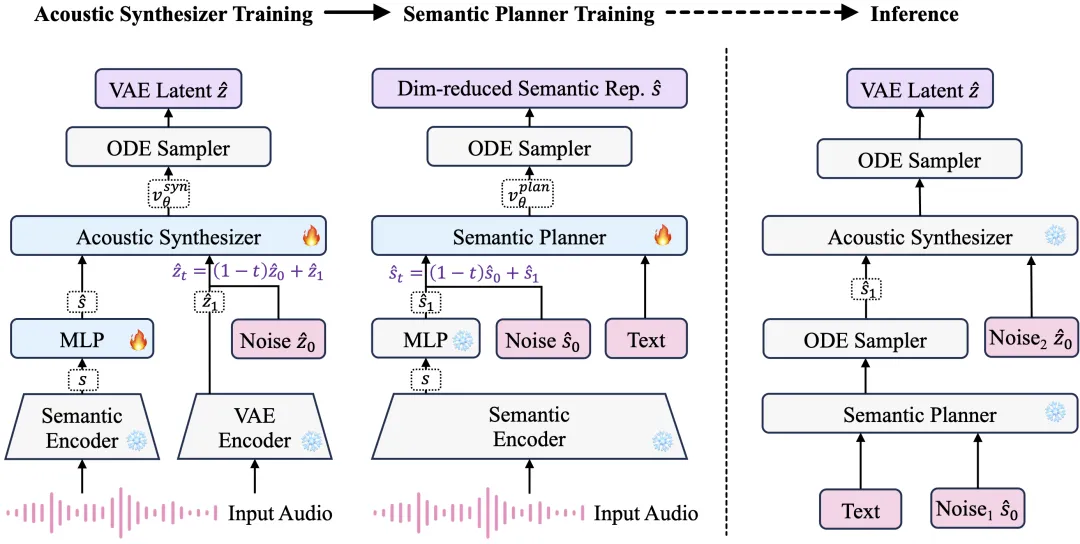
图1:SemanticAudio 框架概览:先生成语义计划,再合成声学细节
SemanticAudio 由两个 Flow Matching 模块组成:Semantic Planner 和 Acoustic Synthesizer。
Semantic Planner 负责从文本生成紧凑的语义表示。它的任务不是直接生成波形或频谱,而是先描绘声音事件的全局布局,包括有哪些声音、什么时候出现、事件之间的顺序关系如何。
Acoustic Synthesizer 则负责把上述语义计划转化为高质量声学潜变量,最后通过 VAE 解码器还原成音频。这样一来,模型内部形成了清晰分工:Semantic Planner 专注于“生成什么”,Acoustic Synthesizer 专注于“怎么生成得好听”。
为了得到合适的语义空间,SemanticAudio 使用 Perception Encoder 提取帧级语义嵌入。相比只给出一个全局向量的音频文本表示,帧级表示能够保留声音事件的时间结构,因此更适合描述复杂音频中的事件顺序和局部变化。论文进一步使用轻量 MLP 将高维语义嵌入压缩到 128 维,使其既保留关键信息,又更容易被生成模型学习。
无需训练的音频编辑
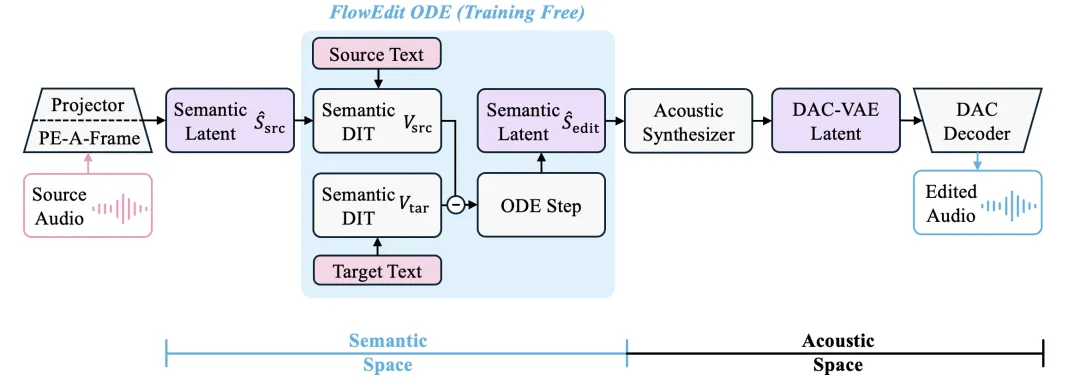
图2:SemanticAudio 的文本引导音频编辑:直接在语义空间中改变声音事件
除了生成音频,SemanticAudio 还自然支持文本引导的音频编辑。传统音频编辑方法往往依赖特定任务训练,或者只能完成添加、删除等预定义操作;而 SemanticAudio 可以直接在语义空间中改变声音事件,从而实现更灵活的属性级修改。
具体来说,方法利用源文本和目标文本对应的速度场差异来引导语义轨迹,从源音频的语义表示出发,朝目标描述方向移动。由于编辑发生在高层语义空间中,模型更容易理解“把男人说话改成女人说话”“把雨声改成风声”这类语义变化,同时尽量保留音频的整体结构和自然度。
这一编辑机制无需额外训练、不需要复杂反演,也不需要为每种编辑类型准备配对数据。对创作者来说,这意味着可以用自然语言直接修改通用音频内容。
实验结果
在AudioCaps 文本生成音频测试中,SemanticAudio(d=128)取得了 0.381 的 LAION-CLAP 分数,显著高于 TangoFlux 的 0.361 和同结构声学空间 Base Model 的 0.318,说明语义规划能够明显改善文本和音频之间的匹配。
在音频分布质量方面,SemanticAudio 的 FD 为 19.1,优于 TangoFlux 的 22.6 和 Base Model 的 25.0,并接近 Resonate 的 16.0。人工 MOS 评分达到 3.72,说明该方法在提升语义一致性的同时,仍保持了有竞争力的听感质量。
在更具挑战性的TTABench 上,SemanticAudio 的 CLAP 得分为 0.459,与 Resonate 持平,并接近 TangoFlux 的 0.464;其 AES-PQ 得分达到 5.936,几乎追平 Resonate 的 5.942,并明显高于 TangoFlux 的 5.701。这表明语义空间生成不仅在 AudioCaps 上有效,也能泛化到更多样的文本提示。
在无需训练的编辑任务中,SemanticAudio 的 CLAP 提升达到 +0.094,高于 TangoFlux FlowEdit 的 +0.081、Resonate FlowEdit 的 +0.065 和 DAC 声学空间基线的 +0.054。人工 MOS 评分也达到 3.71,说明它在完成语义修改的同时,能够更好地保持自然度。
为什么语义空间有效?
SemanticAudio 的关键优势来自“解耦”。直接在声学空间中生成时,模型必须同时学习文本语义、声音事件结构和具体声学细节;而在 SemanticAudio 中,高层语义先被显式规划出来,声学合成再围绕这个计划展开。
这种设计尤其适合处理复杂提示词。对于包含多个声音事件的描述,模型可以先在语义空间中决定事件身份与时间顺序,再生成具体声音,因此更容易避免事件缺失、顺序错误和文本对齐不足。
同时,语义空间也为编辑提供了更清晰的操作对象。相比在高维声学空间中做扰动,在紧凑语义空间中移动更接近于改变“声音内容本身”,因此可以实现更稳定、更可解释的文本引导修改。
总 结
SemanticAudio 提出了一种新的文本生成音频思路:把声音生成从直接建模声学细节,转变为先进行高层语义规划,再进行高保真声学合成。实验表明,这一框架在文本-音频对齐、生成质量和无需训练音频编辑方面都展现出良好效果。
随着生成式音频逐渐进入内容创作、影视游戏制作和交互式媒体,模型不仅要“听起来真实”,还要“生成得准确、可控、可编辑”。SemanticAudio 正是朝着这一目标迈出的一步:让音频生成模型不仅会合成声音,也更懂声音背后的语义结构。
