
 语音小管家
本期分享杭州电子科技大学智能语音课题组被语音信号处理领域旗舰会议Interspeech 2026录用的4篇论文,涵盖了神经形态语音增强、用户自定义关键词检测、生成式语音增强以及多任务语音理解测评四个主题。
1. Neuromorphic Speech Enhancement with Dual-Branch Spiking Neural Networks
【论文作者】蒙泰宇(23级本科生) 江文斌* 张颢议 周禹含 殷海兵
【论文单位】杭州电子科技大学
【作者邮箱】meng_taiyu@hdu.edu.cn; wbjiang@hdu.edu.cn
【论文亮点】提出GSU-DBNet,将门控脉冲单元(GSU)引入双路径双分支架构,以脉冲神经网络替代传统LSTM,破解神经形态语音增强"低能耗但低质量"的困境;通过幅度谱与复数谱双分支联合建模,挖掘多谱域互补信息,解决现有SNN方法只建模单一谱维度的局限。
【论文简介】
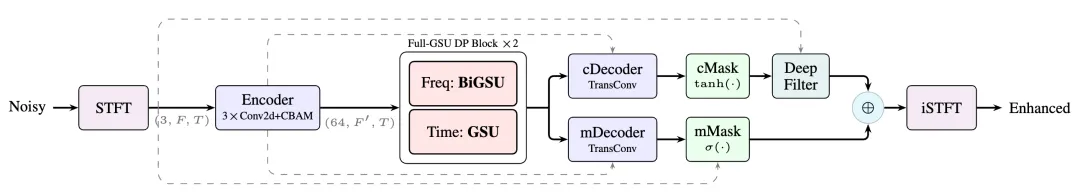
针对脉冲神经网络(SNN)语音增强"能效高但质量落后于人工神经网络(ANN)"的痛点,以及现有方法仅建模单一谱维度的局限,本文提出双分支脉冲语音增强框架 GSU-DBNet。模型采用编码器—分离器—解码器结构:分离器以频率路径双向 BiGSU 捕获全局谱结构、时间路径单向GSU实现因果时序建模;双分支解码器并行估计复数掩码与幅度掩码并加权融合,兼顾噪声抑制与相位恢复。该模型仅394K参数量,在VoiceBank+DEMAND数据集的PESQ评分可达3.04,参数量仅为主流ANN方案的 4.5%~10.6%,轻量化优势突出。同时,通过消融实验剖析了SNN领域普遍存在的 “二值输出性能瓶颈”内在机理,验证了单门GSU结构在脉冲语音处理框架下的有效性与优越性。
2. KFC-KWS: Keyframe Fusion with CTC for User-Defined Keyword Spotting
【论文作者】李锦(22级本科生) 江文斌* 胡冀
【论文单位】杭州电子科技大学
【作者邮箱】jinli@hdu.edu.cn; wbjiang@hdu.edu.cn
【论文亮点】
本文提出了一种基于CTC关键帧融合的用户自定义关键词检测方法KFC-KWS,利用CTC后验概率峰值自动提取具有判别性的音素关键帧,实现音频、音素与文本模态的精细对齐与融合,在提升发音相似关键词区分能力的同时兼顾全局语义信息。实验结果表明,该方法在LibriPhrase基准数据集上取得98.73%的Balanced AUC。
【论文简介】
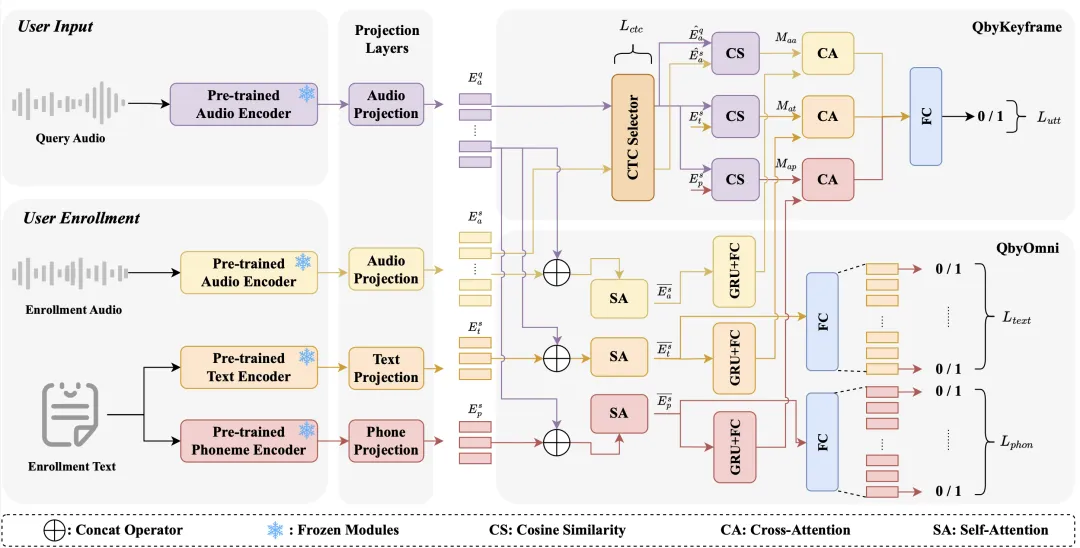
针对用户自定义语音关键词检测中难以区分发音高度相似关键词的问题,本文提出KFC-KWS。该方法利用连接时序分类(CTC)模型后验概率的峰值特性,自动提取具有高判别性的音素关键帧,并以此作为跨模态对齐锚点,实现查询语音与注册语音、音素序列及文本语义之间的精细匹配。为兼顾局部判别信息与全局上下文信息,本文设计了QbyKeyframe和QbyOmni双分支架构,并引入模态随机失活策略提升模型鲁棒性。实验结果表明,KFC-KWS在LibriPhrase数据集上取得98.73%的Balanced AUC,在困难测试集(LPH)上达到97.65%的AUC和7.75%的EER,相较于PLCL、MM-KWS等先进方法表现出更强的混淆关键词区分能力。虽然在简单样本上的性能存在一定权衡,但模型在困难场景下取得了更显著的性能提升,实现了更优的整体平衡性能,验证了CTC关键帧跨模态对齐策略在混淆关键词检测任务中的有效性。
3. Time-Unconditional Generative Speech Enhancement via Autonomous Rectified Flow
【论文作者】张雯(23级本科生) 江文斌* 张杨 周晓飞
【论文单位】杭州电子科技大学
【作者邮箱】zhangwen@hdu.edu.cn; wbjiang@hdu.edu.cn
【论文亮点】本文打破了传统生成式语音增强对时间步的固有依赖,提出移除时间嵌入的自洽流匹配(ARF)框架。通过数学推导,本文证明了在线性路径下目标向量场具有时间不变性且直接等价于噪声分布,改善了传统模型因时间嵌入而导致的轨迹过拟合问题。
【论文简介】
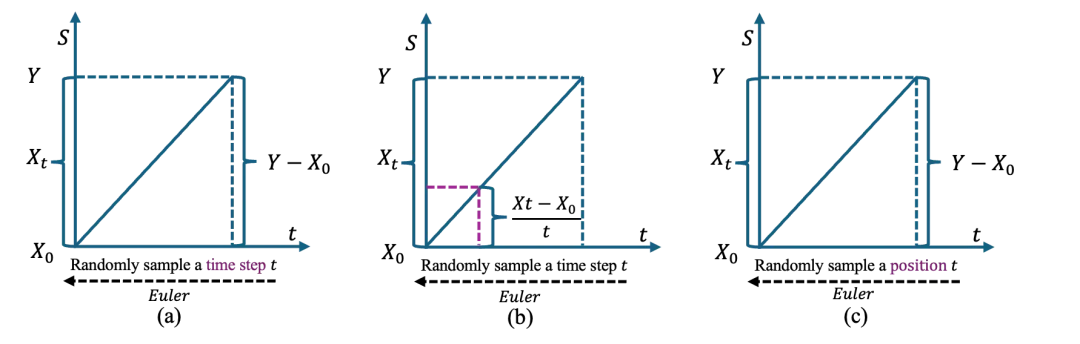
本文针对生成式语音增强模型(如扩散模型、流匹配模型)计算开销大、过度依赖时间步嵌入导致轨迹过拟合的痛点,提出了全新的自洽流匹配语音增强框架(Autonomous Rectified Flow, ARF)。
传统的流匹配方法虽然通过构建确定性普通微分方程(ODE)路径缓解了先验不匹配问题,但仍依赖时间步t来调制向量场。本文通过数学推导提出:在线性插值路径下,驱动生成轨迹的目标速度向量在时间上是恒定的,其物理本质即为声学噪声与注入高斯噪声的组合。基于此,本文摒弃了网络中的时间步嵌入模块,将语音增强重构为一个时间无关的自洽动力系统,只依靠当前状态与噪声观测之间的状态关系来推断去噪方向。
实验结果表明,基于ARF的增强网络(ARFSE)在 NFE=5时可取得 3.11的竞争性 PESQ 得分;在单步推理NFE=1下,将实时率压缩至 0.02。同时,该框架在跨数据集测试中展现出优异的跨域泛化鲁棒性。未来,该框架将进一步在通用语音增强中测试其性能。
4. A Unified and Reproducible Experimentation Framework for Speech Understanding
【论文作者】彭景 杜俊皓 王程昊 李翰奇 杨熠 王奕璇 顾笑与 陈冠豫 王雨诚 蒋李 赵章杰 王浩然 涂文明 李浩宇 马夺 钱丽蓉 奚彧 文雯 郭嘉琪 张辉 樊帅 江文斌 王帅 俞凯
【论文单位】上海交通大学,杭州电子科技大学,苏州思必驰股份有限公司,瑞士苏黎世联邦理工学院,南京大学,香港中文大学
【作者邮箱】jing.peng@sjtu.edu.cn
【论文亮点】搭建统一可复现的多任务语音理解测评基准SURE,全链路固定预处理与打分规则,解决行业评测标准不统一、指标无法横向对比的问题;划分三大测试Track,从声学扰动、语言学难题、可控复现训练三个维度全方面校验模型;覆盖CTC/AED、级联方案、端到端SLM、语音大模型四类主流架构,全主流音频大模型完成统一跑分,打破纸面SOTA乱象。
【论文简介】
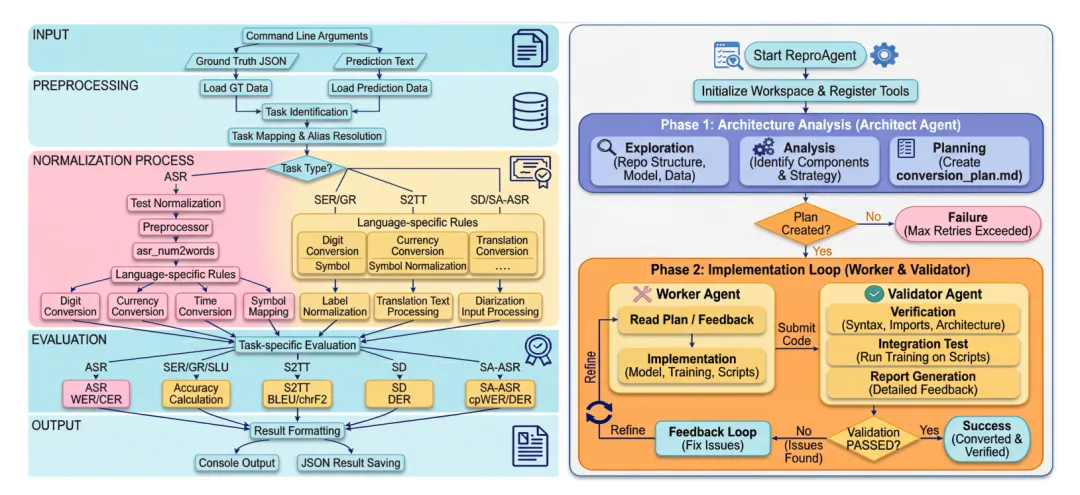
针对语音领域长期存在评测规则碎片化、实验难以复现、模型性能无法公平对比的行业痛点,本文设计 SURE 标准化语音理解实验框架。TrackⅠ依托车载、多人会议、方言、中英混杂等真实数据集,从声学噪声与语言学变体双向添加扰动,测试模型落地鲁棒性;TrackⅡ统一全任务评测细则,横跨ASR、语音翻译、情感识别、口语理解等任务横向比对市面主流语音大模型;TrackⅢ搭载智能Agent模块,自动解析论文与源码、生成标准化训练脚本,固定训练环境与数据集,剔除训练资源带来的性能干扰,客观衡量模型架构真实能力。相较SUPERB系列基准,SURE评测结果更贴合工业落地表现,是面向科研与工程选型的全场景测评基准。
初审:吴锡欣,复审:朱璇, 终审:凌震华
