
 语音小管家
近年来,语音合成模型的能力提升很快。只给一小段参考音频,模型就可以模仿目标说话人的音色,读出一段新的文本。但真正把语音克隆系统用起来时会发现,模型不能只"能发声"——它需要同时做到三件事:读对文字、像目标说话人,并且声音自然、清晰、稳定。
近期,阿里团队提出的FlowTTS-GRPO正是围绕这个问题进行研究的。它把在线强化学习带进 Flow-Matching 语音合成,让模型能够根据多目标 Reward 反馈,直接优化“说得准、说得像、说得好”的最终表现。论文全称为:“FlowTTS-GRPO: Online Reinforcement Learning with Multi-Objective Reward Optimization for Flow-Matching Based Text-to-Speech”,已被Interspeech 2026接收。
▎为什么 FM-TTS 的在线强化学习不容易?
当前主流语音合成(Text-to-Speech,TTS)架构大致可以分成两类。一类是 LLM-based TTS,先生成语音离散 Speech Token,再解码成波形;另一类是 Flow Matching-based TTS,直接在连续声学空间中建模生成过程。F5-TTS [1] 是 FM-only 架构的代表;CosyVoice 3.0 [2] 则是 LLM+FM 的混合架构,其中 LLM 负责语义相关的 Speech Tokens,FM 负责恢复声学细节。
想用强化学习来优化这类模型,第一个拦路虎出在采样过程上。标准 Flow Matching 的采样过程通常是一条确定性ODE 轨迹。给定初始噪声、条件输入和模型参数,采样路径基本由 velocity field 决定。这对普通生成没有问题,但对在线强化学习(Reinforcement Learning,RL)并不方便:确定性轨迹缺少探索,也很难像离散 Token policy 那样定义新旧策略之间的 policy ratio。
因此,FlowTTS-GRPO不只是直接套 Reward,而是先把 FM 采样过程变成一个可以探索、可以计算轨迹概率的过程。
FlowTTS-GRPO的整体思路是:对同一个输入生成多条候选语音,用多个 Reward model 评价它们,再让高分语音对应的生成轨迹在模型中变得更可能。
具体来说,训练时,系统会取一段 prompt audio 和对应 prompt text,再随机采样新的 target text,生成多条候选语音,并用外部 Reward 模型评价说话人相似度、内容一致性和感知音质。随后,GRPO 在同组候选内部计算相对 Advantage:谁更像、读得更准、音质更好,谁对应的生成轨迹就获得更高权重。
这里有一个容易被忽略的细节:FlowTTS-GRPO更新的不是文本侧 LLM Token policy,而是 FM Acoustic Model 的 velocity field。论文在 CosyVoice 3.0 和 F5-TTS 上都只微调 FM 组件,Tokenizer、LM、Vocoder 等其他模块保持不变。
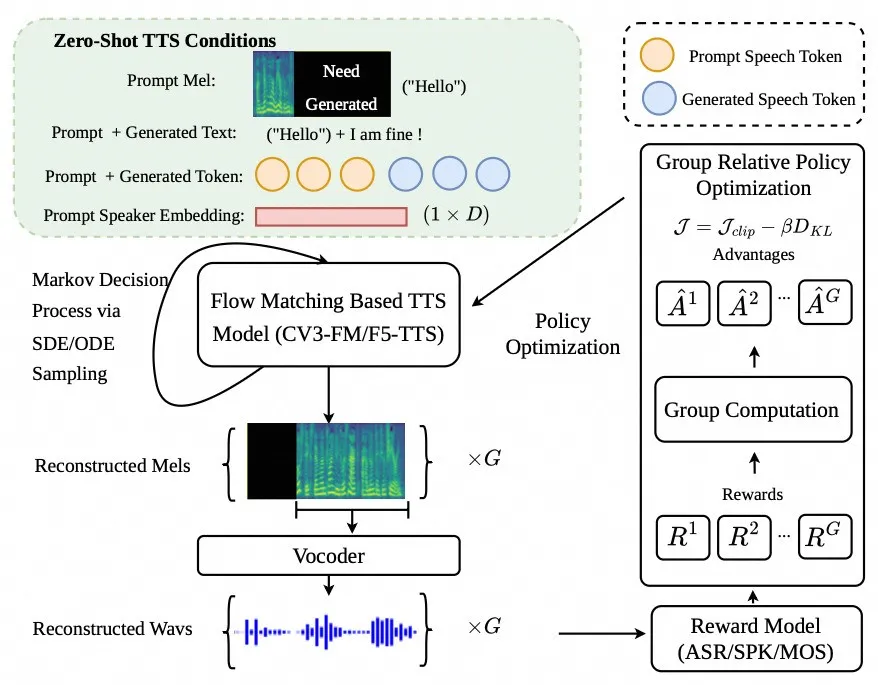
(图1:FlowTTS-GRPO 在 CosyVoice 3.0 和 F5-TTS 上的后训练流程)
▎关键机制一:从 ODE 到 SDE,让生成过程可以探索
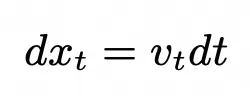
标准 Flow Matching 采样可以理解为一条从噪声走向语音的确定路线。模型在每个时间步预测 velocity,并沿着这个方向更新状态。这样的 Ordinary Differential Equation (ODE) 过程足够稳定,但也意味着同一条件下几乎只会走出同一条轨迹,随机性不足。
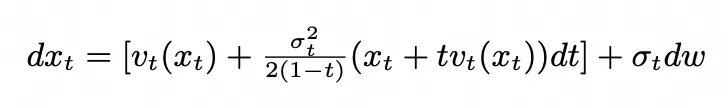
SDE 预测速度
FlowTTS-GRPO借鉴 Flow-GRPO [3] 和 FlowSE-GRPO [4],将确定性 ODE 轨迹转换为带随机性的Stochastic Differential Equation (SDE) 路径,在原本生成方向上加入可控高斯扰动,让同一个输入产生多条不同、但彼此可比较的轨迹。
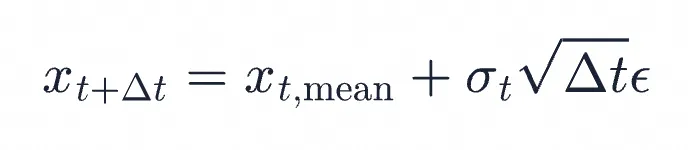
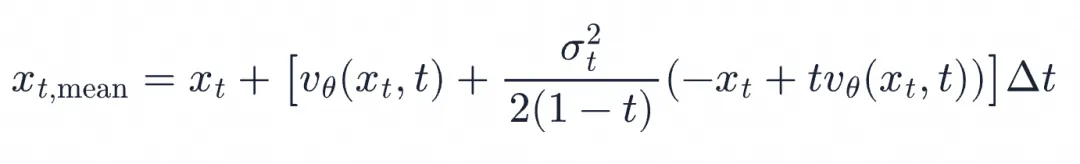
为了兼顾成本与稳定,论文还采用 Window Training:只在一小段早期 denoising steps 上加入 SDE 并计算优化,其余步骤仍使用确定性 ODE。
具体 GRPO 优化目标公式如下:
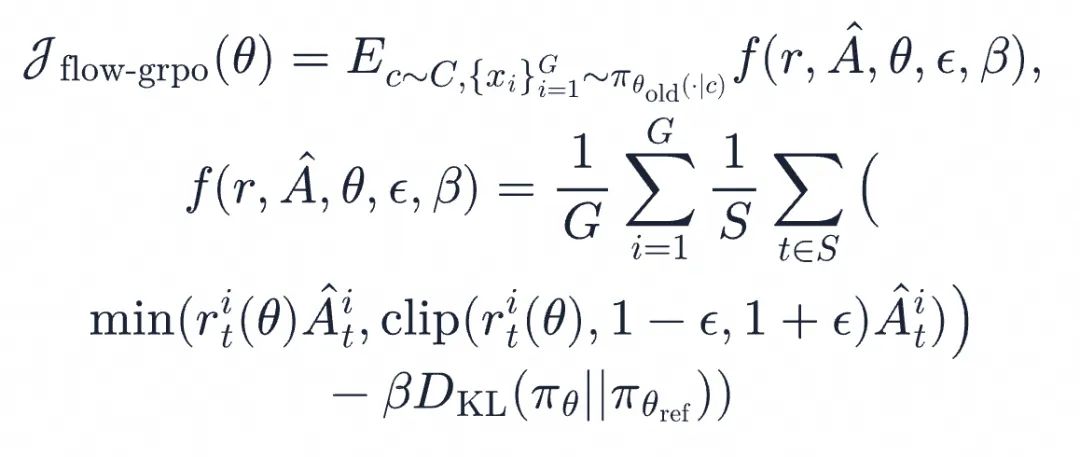
其中 importance ratio:
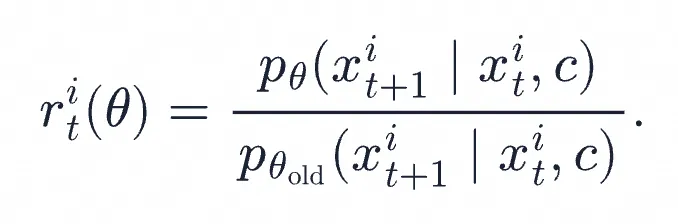
似然 likelihood:
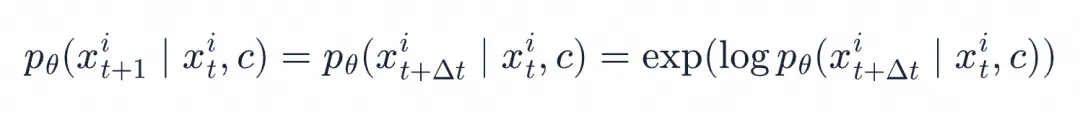
高斯密度:
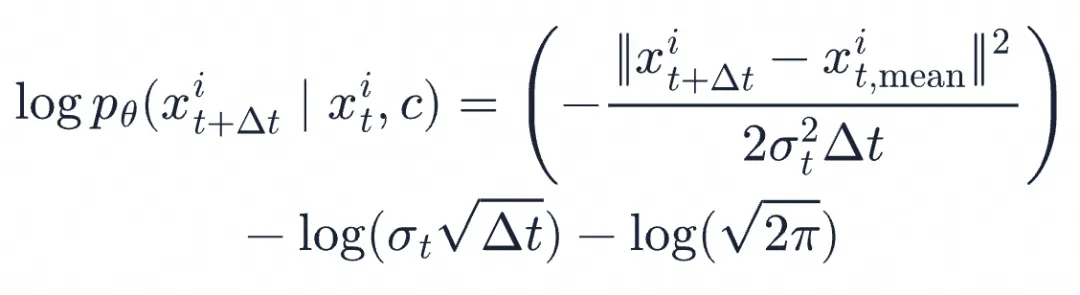
▎关键机制二:多目标 Reward,同时看音色、内容和音质
TTS 不是单目标任务。只优化内容正确性,模型可能读得更准但不像目标说话人;只优化说话人相似度,文字错误可能增加;只优化感知音质,也可能牺牲其他指标。
FlowTTS-GRPO设计了三类 Reward:
说话人相似度 Reward 使用 ERes2Net 和余弦相似度衡量音色一致性
ASR Reward 中文使用 Paraformer 和 1-CER,英文使用 Whisper-v3 和 1-WER
感知质量 Reward 使用 P.835 DNSMOS 的 OVRL 分数优化自然度和噪声质量
但多目标 Reward 不能简单相加。论文观察到,不同 Reward 在 batch 内的标准差并不一样。如果直接相加,方差更大的 Reward 会天然主导 Advantage,最终优化方向并不一定符合设定权重。
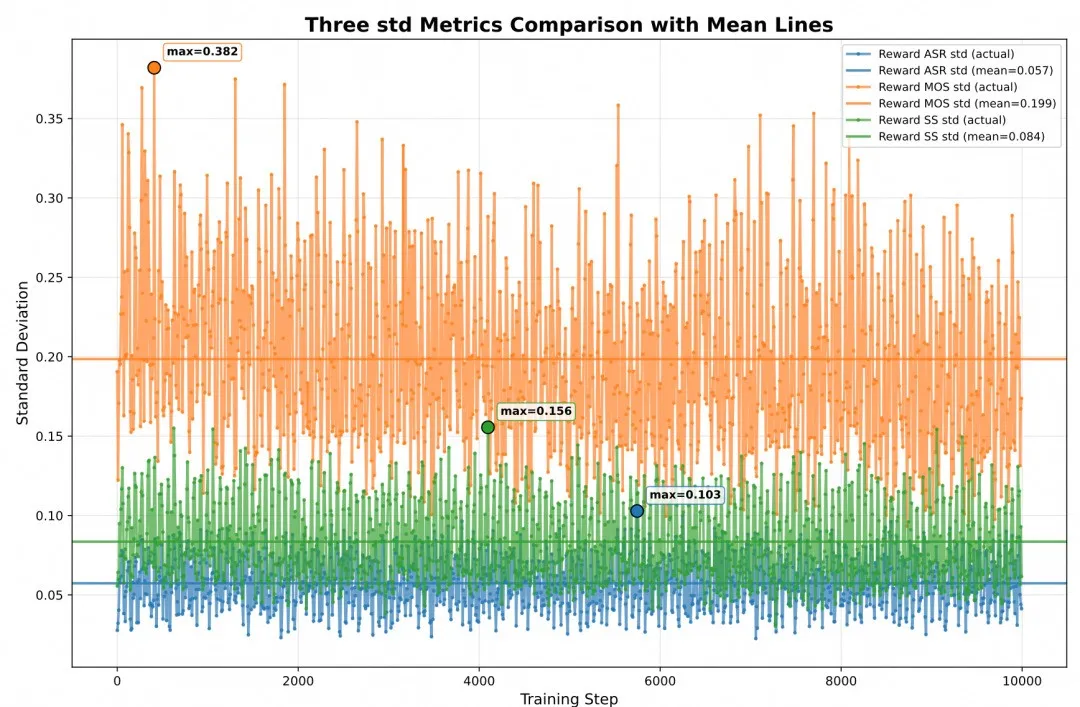
(图2:训练过程中三类 Reward 在 batch 内的标准差对比)
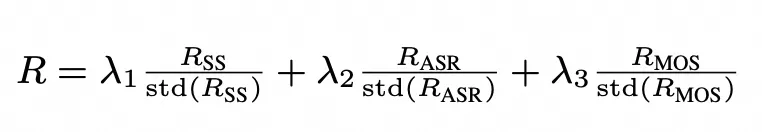
相比“不做标准差归一化”的方式和另外一种针对每个 prompt 按照概率随机分配单一 Reward 的 Probabilistic combination 方式,这一标准差归一化策略收敛更快、更稳定。如下图所示,Weighted combination 比 Probabilistic combination 和 Weighted w/o std Norm. 都更稳定。
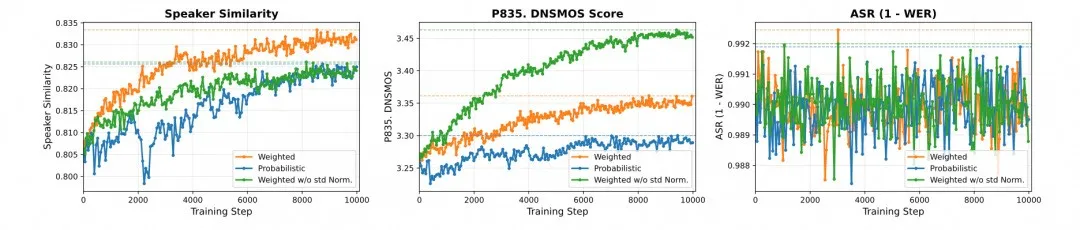
(图3:不同多目标 Reward 组合策略下,CV3 在 dev-easy 集上 RL 训练过程中的 proxy reward 曲线)
▎关键机制三:hard case synthesis,专门训练容易翻车的文本
语音克隆系统在普通文本上表现不错,并不意味着它在所有文本上都稳定。重复词、长句重复、绕口令都容易触发重复读、漏读、节奏漂移或音色不稳定。
论文参考 Seed-TTS-Eval hard-zh 中的困难模式,在 WenetSpeech4TTS 数据上进行启发式文本增强,构造 hard case training set。增强方式主要包括三类:Local Word Repetition(LWR),字符重复;Sparse Multi-word Repetition(SMR),单词重复;Global Sentence Repetition(GSR),整句重复。例子如下:
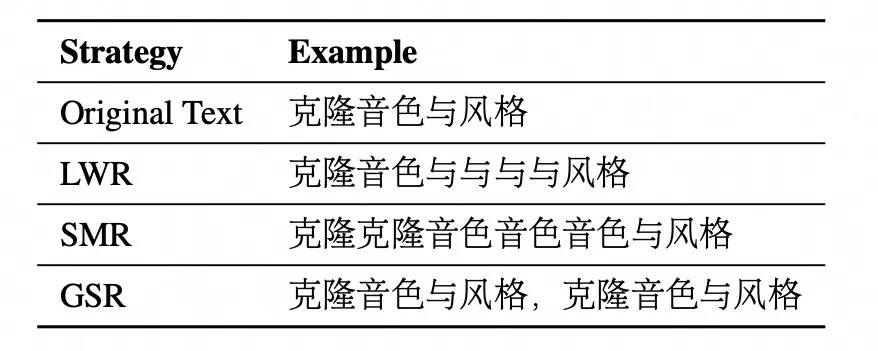
(表1:hard case 文本增强策略示例)
这些 hard case 不只是普通数据增强。对于 RL 来说,模型越容易出错的输入,越能提供有区分度的 Reward 信号。
消融实验也说明了这一点。F5-TTS 直接从文本合成语音,因此 hard case 能更明显地加速 ASR reward 增长。CosyVoice 3.0 的语义信息主要由 LM tokens 决定,hard case 对可懂度提升有限。
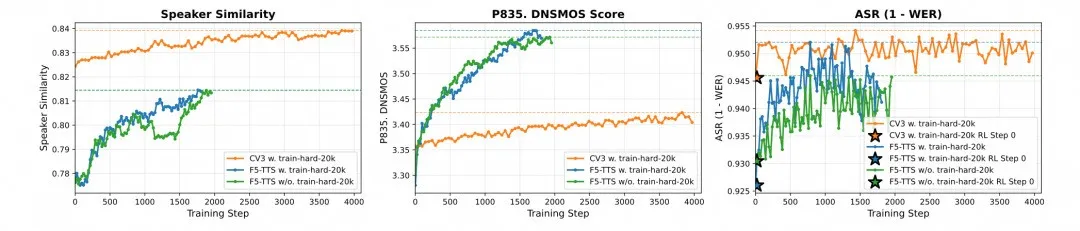
(图4:hard case training 对 CV3 和 F5-TTS 的训练影响)
▎实验结果
两个开源 TTS 系统上的提升
FlowTTS-GRPO在 CosyVoice 3.0 和 F5-TTS 上验证。两者都只微调 FM 组件,并采用 LoRA。训练数据包括 WenetSpeech4TTS Premium 和 LibriTTS-960,中英文各 20k 样本组成 train-easy-40k;此外还构造 20k 中文困难样本 train-hard-20k。
先说清楚几个指标的含义:CER/WER 衡量内容正确性(越低越好);SS2 是训练所用的 ERes2Net 说话人相似度,SS1 是不参与训练的 WavLM 说话人相似度;P835、P808 分别是 P.835、P.808 DNSMOS 感知质量分。
在 Seed-TTS-Eval 上,F5-TTS 的提升比较全面。在论文复现实验设置下,F5-TTS baseline 的中文 test-zh CER 从 1.81 降到 1.55,SS2 从 0.796 提升到 0.827,P835 从 3.313 提升到 3.514;英文 test-en 的 WER 从 1.88 降到 1.73,SS2 从 0.753 提升到 0.790;困难文本 test-hard 的 CER 从 9.00 降到 7.86。
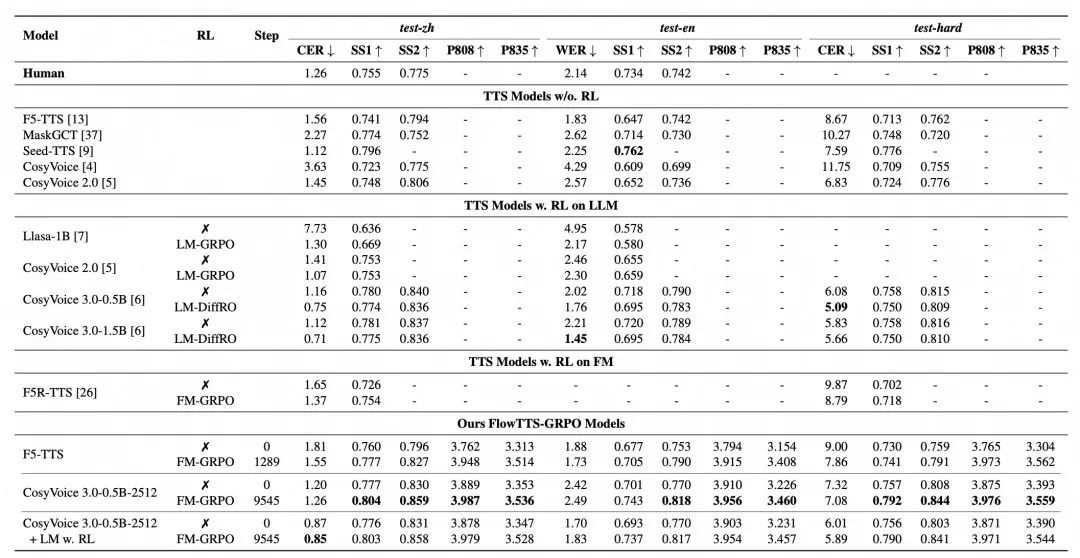
(表2:Seed-TTS-Eval 上的零样本 TTS 性能对比)
这符合 F5-TTS 的架构特点。作为 FM-only 系统,F5-TTS 的 FM 模块既影响声学细节,也直接参与从文本到语音的生成建模。
CosyVoice 3.0 上的结果呈现出另一种特点。中文 test-zh 上,SS1 从 0.777 提升到 0.804,SS2 从 0.830 提升到 0.859,P835 从 3.353 提升到 3.536;英文 test-en 上,SS2 从 0.770 提升到 0.818,P835 从 3.226 提升到 3.460;困难文本 test-hard 上,SS2 从 0.808 提升到 0.844。尤其值得一提的是,test-zh 上的 SS1 首次超过闭源系统 Seed-TTS,达到当前最优(SOTA)水平。
不过,CosyVoice 3.0 的 WER/CER 与 baseline 基本持平,并没有因为优化音色和音质而退化。这并不意外:在 LLM-FM hybrid 架构中,内容可懂度更多由 LLM Tokens 决定,FM 更主要负责声学细节。
论文还验证了一个重要现象:虽然训练使用的 speaker similarity reward 来自 ERes2Net,也就是 SS2,但 WavLM-based 的 SS1 同样提升。这说明模型并不是简单 hack 某一个 proxy reward。
此外,论文还做了一组消融实验,沉淀出几个对训练有用的设置:
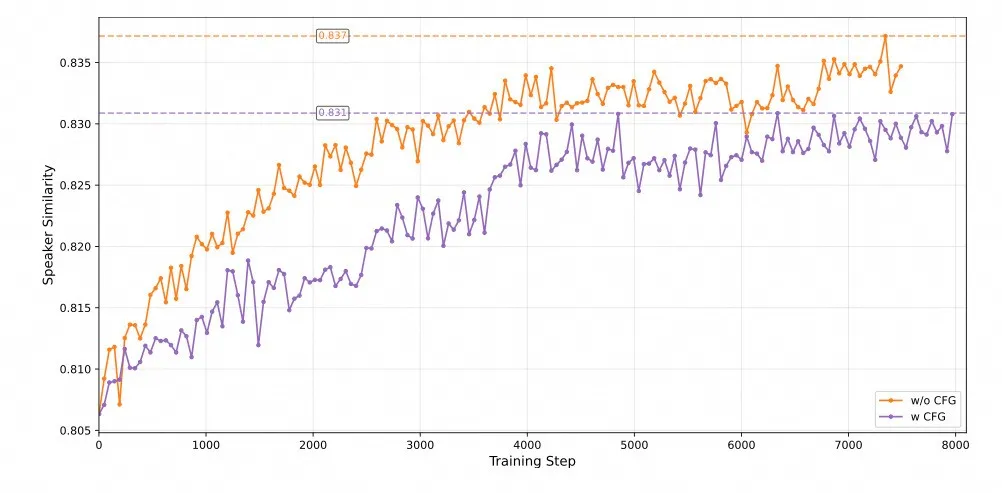
(图5:RL 训练阶段去掉 CFG 对 dev-easy 集结果的影响)
训练阶段去掉 CFG 反而收敛更快,因为它给了模型更大的探索空间(推理时仍可正常使用 CFG);
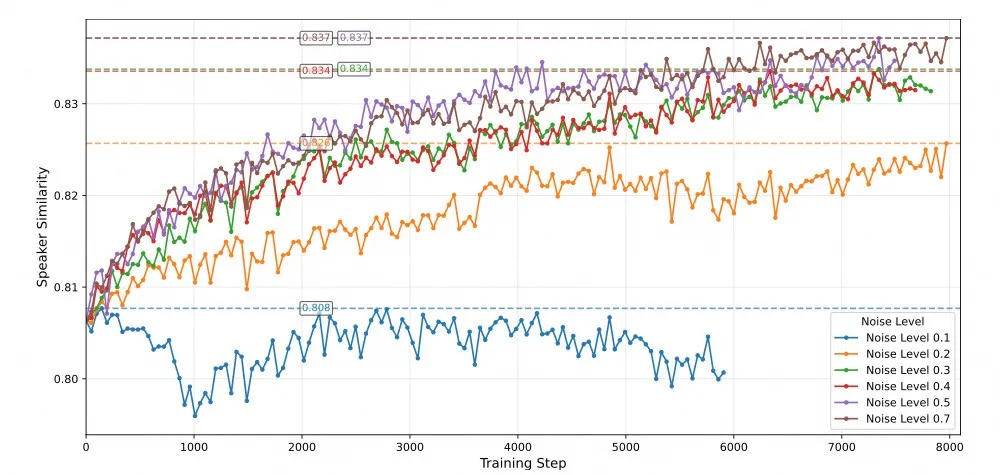
(图6:RL 训练阶段不同 noise level 对 dev-easy 集结果的影响)
noise level 则是探索与稳定之间的关键旋钮——取 0.1 时 reward 会震荡、难以持续增长,增大到 0.5 才进入更好的饱和点;
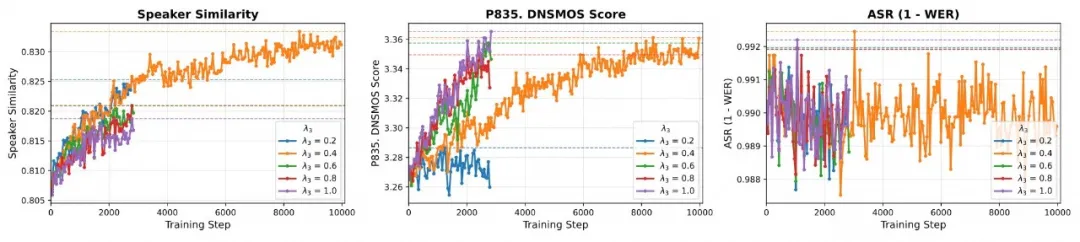
(图7:不同 DNSMOS 权重下,CV3 在 dev-easy 集上 RL 训练过程中的 proxy reward 曲线)
多目标组合里 DNSMOS 权重也不宜一味调大,从 0.2 加到 1.0 虽然音质涨得更快,却会拖慢音色相似度,所以最终把 speaker similarity 和 ASR reward 权重都设为 1.0、DNSMOS 设为 0.4。
▎多语种泛化与主观偏好
FlowTTS-GRPO 还在 CV3-Eval 多语种集合上评估。训练数据主要来自中文和英文,但 FM-RL 后的模型在其他语言上也提升了说话人相似度和音频质量。
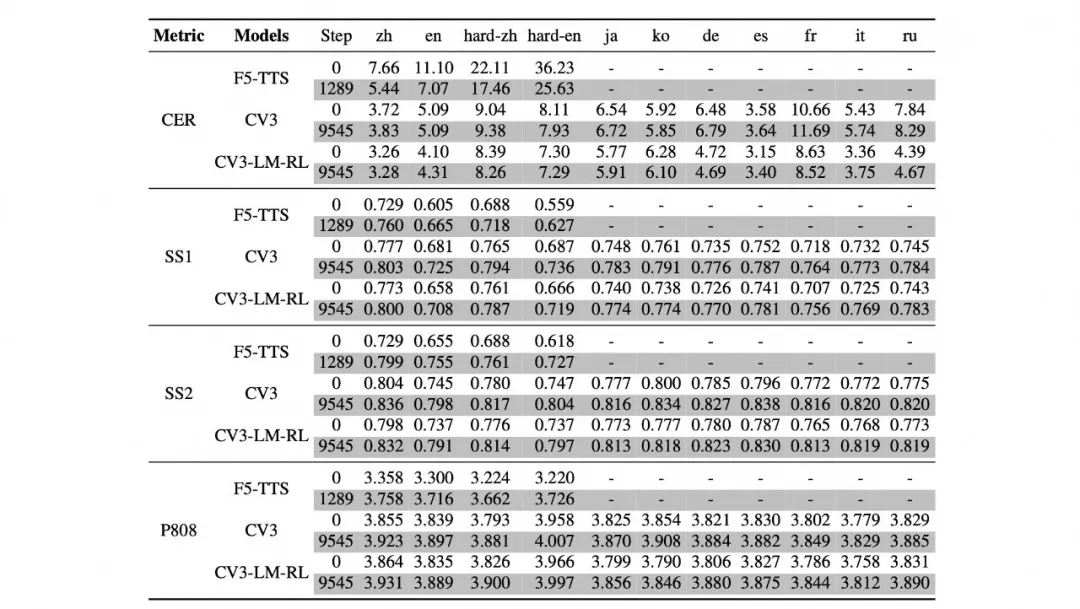
(表3:CV3-Eval 多语种语音克隆子集上的评测结果)
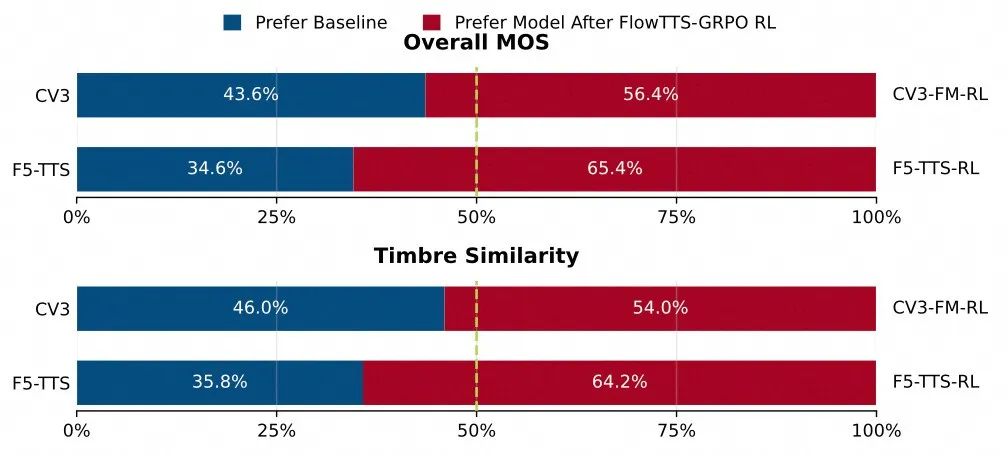
(图8:英文主观 A/B偏好测试结果)
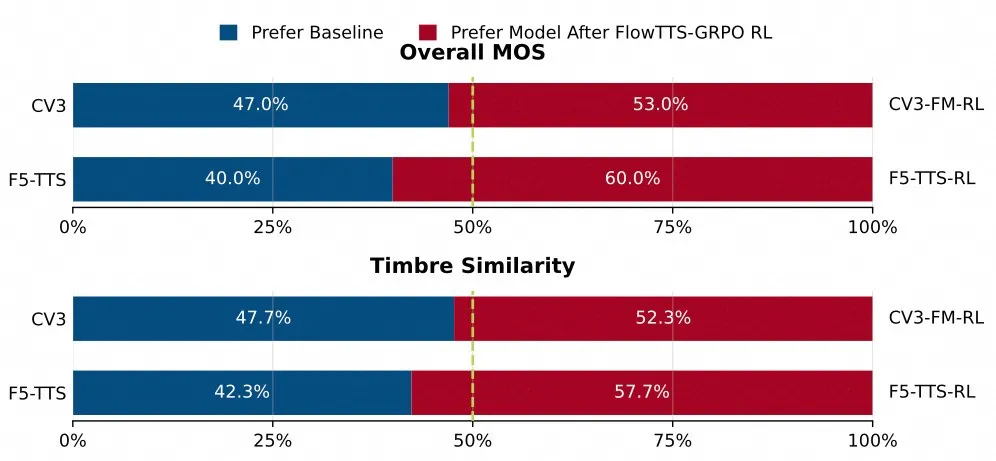
(图9:中文主观 A/B偏好测试结果)
▎总结
FlowTTS-GRPO的意义不只是让几个 benchmark 的结果更好,更重要的是,它给 FM-TTS 提供了一套可操作的在线 RL 后训练范式:用 ODE-to-SDE 让确定性采样可探索,用 Gaussian transition 定义轨迹概率,用组内相对 Advantage 避免额外 value model,再用多目标 Reward 对齐最终听感。
让模型说对,是语音合成的底线;让模型说得像、说得稳、说得好听,是后训练真正要对齐的目标。对于 LLM-FM 混合式 TTS,未来更完整的系统也很可能走向 LM-RL 与 FM-RL 的协同优化。
相关文献参考:
[1]Y. Chen, Z. Niu, Z. Ma, K. Deng, C. Wang, J. JianZhao, K. Yu, and X. Chen, “F5-tts: A fairytaler that fakes fluent and faithful speech with flow matching,” in Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 2025, pp. 6255–6271.
[2]Z. Du, C. Gao, Y. Wang, F. Yu, T. Zhao, H. Wang, X. Lv, H. Wang, C. Ni, X. Shi et al., “Cosyvoice 3: Towards in-the-wild speech generation via scaling-up and post-training,” arXiv preprint arXiv:2505.17589, 2025
[3] J. Liu, G. Liu, J. Liang, Y. Li, J. Liu, X. Wang, P. Wan, D. Zhang, and W. Ouyang, “Flow-grpo: Training flow matching models via online rl,” arXiv preprint arXiv:2505.05470, 2025
[4] H. Wang, B. Tian, Y. Jiang, Z. Pan, S. Zhao, B. Ma, D. Chen, and X. Li, “Flowse-grpo: Training flow matching speech enhancement via online reinforcement learning,” ICASSP 2026 - 2026 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), Barcelona, Spain, 2026, pp. 16182-16186.
