
 语音小管家
随着大语言模型在文本、视觉等模态上的快速发展,“推理能力”已经成为衡量多模态模型智能水平的重要指标。通过 Chain-of-Thought(CoT)等技术,模型能够将复杂问题拆解为中间推理步骤,从而提升复杂任务上的表现。然而,相较于文本推理和视觉推理,音频推理仍处在相对早期阶段。现有大音频语言模型(Large Audio Language Models, LALMs)虽然已经在语音感知、音频理解和基础交互方面取得了显著进展,但在复杂声学场景下仍容易出现推理链模板化、音频依据不足、逻辑不一致以及细粒度声学线索误判等问题。
西工大音频语音与语言处理研究组(ASLP@NPU)近期与中国电信人工智能科技(北京)有限公司合作完成论文 “Audio-Cogito: Towards Deep Audio Reasoning in Large Audio Language Models”。该工作面向大音频语言模型中的深度音频推理问题,提出了完全开源的解决方案 Audio-Cogito,并设计了自动化数据构造流水线 Cogito-Pipe,用于构建高质量音频推理监督微调数据。基于 545k 条多领域音频推理样本 和 自蒸馏训练策略,Audio-Cogito 有效提升了大音频语言模型在复杂声学场景下的推理能力,在Interspeech 2026 Audio Reasoning Challenge 中取得季军的好成绩,相关论文已被语音研究顶级会议 Interspeech 2026 接收。现对该论文进行简要的解读和分享。
论文题目:Audio-Cogito: Towards Deep Audio Reasoning in Large Audio Language Models
合作单位:中国电信人工智能科技(北京)有限公司
作者列表:李龙豪、陈虹洁、李泽涵、胡启涵、康健、李杰、谢磊、李永翔
论文预印版:https://arxiv.org/abs/2604.12527
Github地址:https://github.com/llh666521/Audio-Cogito
背景动机
近年来,大语言模型(LLMs)在推理能力方面取得了快速进展。特别是 Chain-of-Thought(CoT)通过显式生成中间推理步骤,使模型能够更好地处理复杂问题。这一范式已经从纯文本任务扩展到视觉语言模型等多模态系统 [1],并在复杂视觉推理任务中展现出明显优势。
在音频领域,大音频语言模型和全模态语言模型也正在从基础感知能力逐步迈向复杂认知推理能力。例如,SALMONN、Qwen2-Audio、Audio Flamingo、Qwen-Omni、GPT-4o Audio 等模型已经在语音、音频和音乐理解任务中取得了较好效果;与此同时,Audio-CoT、Audio Flamingo 3、Step-Audio-R1、Qwen3-Omni-Thinking 等工作开始尝试将显式 CoT 推理机制引入音频模态。
然而,现有音频推理模型仍面临几个关键挑战:
第一,当前模型的音频推理能力仍不稳定。很多模型虽然能够输出结构化推理过程,但这些推理链往往较为模板化,缺少对真实音频线索的深度 grounding。在复杂声学环境中,模型容易忽略细微的声音事件、说话人情绪、音乐风格变化或多模态混合线索,从而产生逻辑不一致或错误判断。
第二,高质量音频推理数据仍然稀缺。现有公开音频数据集,如 AudioSet、AudioCaps、Clotho 等,大多提供简短标签或音频描述,适合训练感知与描述能力,但不足以支持模型学习复杂推理过程。少量音频推理数据集虽然已经出现,但往往侧重浅层推理,难以覆盖真实场景中的多步分析需求。
第三,复杂推理链数据的构建通常依赖闭源模型,如 Gemini 2.5 Pro 等。这不仅带来较高的数据标注成本和复现门槛,也可能造成不同模型之间推理格式不兼容,限制了音频推理数据与模型训练的进一步发展。
针对以上问题,我们提出了Audio-Cogito:一个面向大音频语言模型深度推理能力的完全开源解决方案。该方法不依赖闭源 API 构建推理数据,而是设计了系统化数据构造流程 Cogito-Pipe,并结合自蒸馏策略,使模型在音频输入、问题理解、推理链生成和最终答案输出之间建立更加一致、可靠的推理模式。
提出方法
如图 1 所示,本文提出的 Cogito-Pipe 是一个用于构建音频推理监督微调数据的自动化流水线,主要包括四个阶段:
Data Collection:多领域音频数据收集
QA Construction:音频问答对构建
CoT Generation:推理链生成
Quality Verification:质量验证与过滤
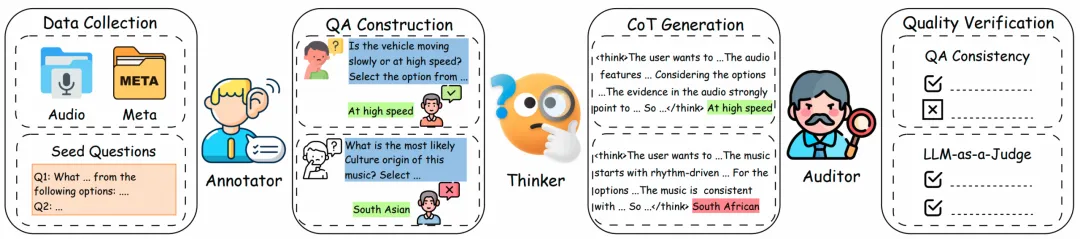
图1 Cogito-Pipe 整体流程
多领域音频数据收集
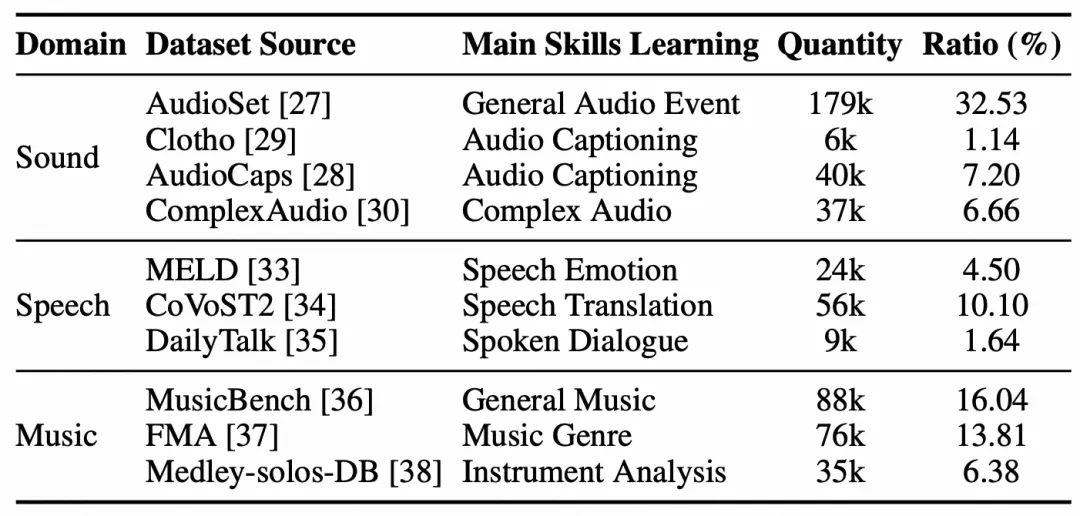
为了构建多样化、高质量、多任务的音频推理数据,Cogito-Pipe 从声音事件、语音和音乐三大音频领域收集数据,同时覆盖多个混合或交错的音频场景。数据来源包括 AudioSet、AudioCaps、Clotho、ComplexAudio、MELD、CoVoST2、DailyTalk、MusicBench、FMA 和 Medley-solos-DB 等。
这些数据覆盖了通用声音事件、音频描述、复杂音频理解、语音情感识别、语音翻译、口语对话、音乐风格识别和乐器分析等多种能力,为模型学习跨领域音频推理提供了基础。
同时,我们还构建了约 500 条高质量种子问题作为 few-shot 示例。这些问题由 LLM 生成候选问题,再经过领域专家审核、修改和补充,覆盖不同音频领域、推理类型和难度等级,用于指导后续 QA 构建过程生成更具挑战性和多样性的音频问题。
表1 Cogito-Pipe 使用的数据集统计
音频问答对构建
在 QA Construction 阶段,我们使用Qwen3-Omni-Instruct作为 annotator 生成音频问答对。为了提升问答对的质量和多样性,每次构造时会从预先构建的种子问题池中采样 20 个问题作为 few-shot 示例,引导模型从不同角度挖掘音频中的深层信息。
此外,我们显式要求模型生成具有迷惑性的错误选项作为 hard negatives,从而提升问题难度,使模型不能仅依赖浅层音频标签或常识偏置作答。对于每段音频,系统会生成 1–3 个 QA 对,从而从多个角度覆盖声音事件、语音内容、情绪、音乐风格、场景关系以及混合音频线索等信息。
推理链生成与自蒸馏
在 CoT Generation 阶段,我们使用 Qwen3-Omni-Thinking 作为 thinker 生成音频推理链,并采用自蒸馏策略构建训练数据。与依赖外部闭源模型生成 CoT 的方式不同,Audio-Cogito 使用与后续微调阶段相同架构的模型来生成推理数据,从而保证推理模式和目标模型之间的一致性,减少由于推理逻辑不匹配带来的性能损失。
具体而言,我们采用自由形式的 CoT 生成策略,而不是强制模型输出固定模板。实验观察表明,过于僵硬的推理模板可能与模型自身的生成模式不匹配,反而会损害模型原有的推理能力。因此,Audio-Cogito 允许模型根据音频内容和问题类型生成更自然、更灵活的推理轨迹。
值得注意的是,虽然 QA 构建阶段已经得到正确答案,但在生成 CoT 时我们并不会将 ground-truth answer 提供给模型。这一设计迫使模型必须从音频线索本身出发进行推理,而不是根据答案反向编造推理过程,从而提升推理链对音频输入的忠实性。
质量验证
为了保证生成音频推理数据的质量,我们进一步设计了 auditor 模块,对数据进行两阶段质量验证。
第一阶段是 QA Consistency Check,用于检查 CoT 推理链中导出的答案是否与 QA 对中的答案一致。只有推理过程和答案保持一致的样本才会进入后续步骤。
第二阶段采用 LLM-as-a-Judge 范式,使用 Qwen3-Omni-Instruct 对推理过程进行审查,过滤掉包含幻觉、逻辑不一致或音频依据不足的样本。通过这一双重验证机制,Cogito-Pipe 能够构建出更可靠、更适合监督微调的高质量音频推理数据。
最终,Cogito-Pipe 构建了 545k 条高质量音频推理样本,覆盖声音、语音、音乐以及多领域混合场景,为大音频语言模型学习深度推理能力提供了大规模数据基础。
实验结果
实验设置
本文主要在 MMAR 基准 [9] 上评估 Audio-Cogito 的性能。与传统音频理解基准主要关注最终答案正确率不同,MMAR 是面向语音、音频、音乐及其混合场景的深度音频推理基准,能够同时评估模型的最终答案正确性和中间推理过程质量。
我们采用 Interspeech 2026 Audio Reasoning Challenge [10] 的官方评测协议,主要包含以下指标:
Avg:平均答案正确率,衡量模型最终回答是否正确;
Rubrics Score:基于样本级 rubric 对推理链进行评分,衡量模型是否满足关键推理步骤;
CRS(Correct Reasoning Score):我们进一步引入的指标,仅在回答正确的样本上评估推理质量,用于衡量正确答案背后的推理过程是否可靠。
评测覆盖七个子任务,包括三个单领域任务和四个混合领域任务:Sound、Music、Speech、Sound-Music、Sound-Speech、Music-Speech、Sound-Music-Speech
对比模型包括三大类:
Large Audio Language Models(LALMs):如 SALMONN [2]、Audio Flamingo 2 [4]、Qwen2-Audio [3]、GPT-4o Audio、Omni-R1 等;
Omni Language Models(OLMs):如 Qwen2.5-Omni、Qwen3-Omni-Instruct、Gemini 2.0 Flash、Gemini 2.5 Pro 等;
Large Audio Reasoning Models(LARMs):如 Mellow、Audio-CoT [5]、Audio-Reasoner、Audio Flamingo 3 [6]、Step-Audio-R1 [7]、Qwen3-Omni-Thinking [8] 等。
MMAR 主结果
从表 2 可以看出,Audio-Cogito 在 MMAR 基准上取得了开源模型中的最佳平均性能。相比基座模型 Qwen3-Omni-Thinking,Audio-Cogito 的平均准确率从 68.00% 提升到 71.70%,相对提升约 5.44%。这一结果表明,基于 Cogito-Pipe 构建的高质量推理数据和自蒸馏训练策略能够有效提升大音频语言模型的深度推理能力。
表2 MMAR 主实验结果
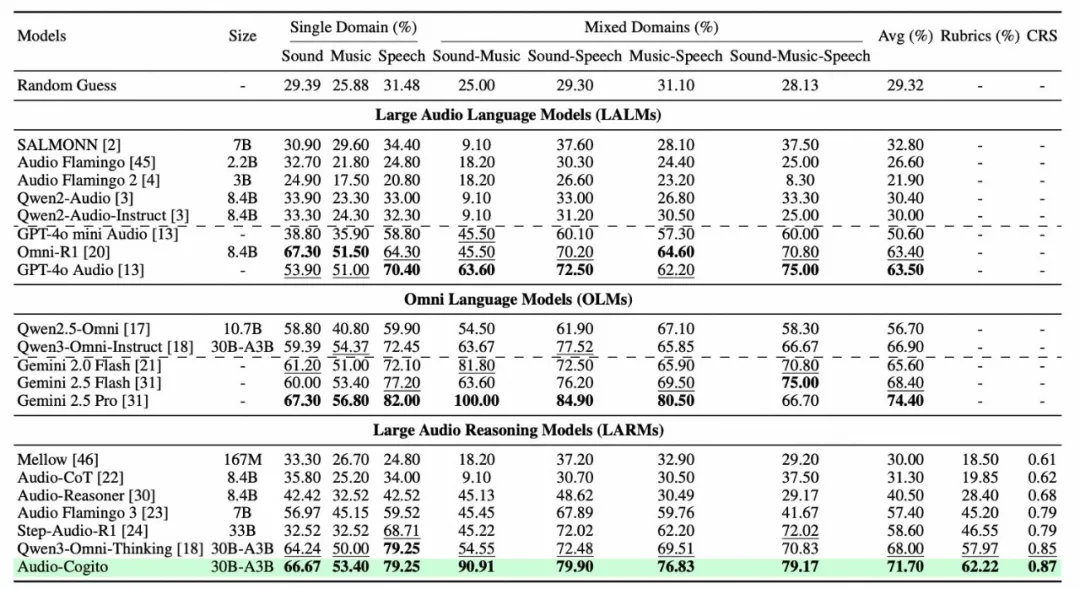
更值得注意的是,Audio-Cogito 在混合领域任务上的提升尤为明显。例如,在 Sound-Music 任务上,Audio-Cogito 达到 90.91%,显著优于 Qwen3-Omni-Thinking 的 54.55%;在 Sound-Speech、Music-Speech 和 Sound-Music-Speech 等复杂混合场景中,Audio-Cogito 也均取得了更好的表现。这说明 Audio-Cogito 在处理复杂声学环境、多源音频线索以及跨领域推理任务时具有更强的鲁棒性。
此外,Audio-Cogito 还进一步缩小了开源模型与闭源模型之间的差距。实验结果显示,Audio-Cogito 的平均准确率超过 Gemini 2.0 Flash、Gemini 2.5 Flash、Omni-R1 和 GPT-4o Audio 等多个闭源或强基线模型;相比当前性能最强的 Gemini 2.5 Pro,Audio-Cogito 在 Sound-Music-Speech 任务上取得更优结果,并在单领域 Sound 任务上达到接近表现。这说明在音频推理任务中,开源模型已经具备接近甚至局部超越闭源模型的潜力。
推理质量分析
除了最终答案正确率,Audio-Cogito 在推理质量指标上也展现出明显优势。在 MMAR 的 Rubrics Score 和 CRS 指标上,Audio-Cogito 分别取得 62.22 和 0.87,均优于 Qwen3-Omni-Thinking、Step-Audio-R1、Audio Flamingo 3 等强基线模型。这说明 Audio-Cogito 不仅能够给出更准确的最终答案,同时其生成的 CoT 推理链也更加可靠,能够更好地覆盖关键推理步骤,并与音频证据保持一致。这一结果进一步验证了自蒸馏策略和质量验证机制在构建深度音频推理能力方面的有效性。
消融实验
为了验证 Cogito-Pipe 各个组件的作用,我们进一步进行了消融实验,分别移除 seed questions、quality verification 和 meta information。
表3 Audio-Cogito消融实验结果
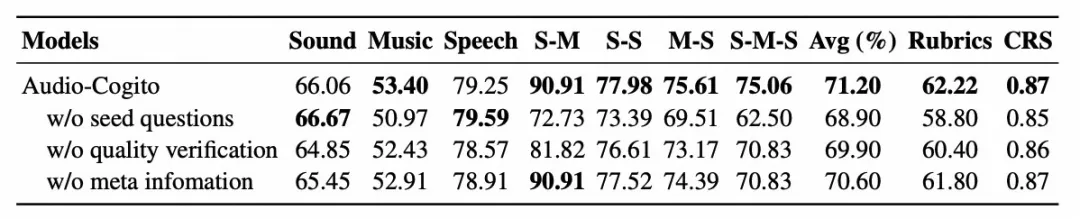
从表 3 的消融实验结果可以看出,移除 Cogito-Pipe 中的任一组件都会导致模型性能下降,说明各阶段设计均对最终效果具有重要贡献。其中,去除 seed questions 带来的性能退化最为明显,尤其是在混合领域任务中下降较大,表明高质量种子问题能够有效引导模型生成更具挑战性和多样性的问答对,从而激发更深层次的音频推理能力;去除 quality verification 后,模型性能同样下降,说明质量验证机制能够过滤幻觉和逻辑不一致样本,对保持训练数据可靠性至关重要;而去除 meta information 也会造成一定性能退化,表明音频元信息能够为 QA 构建和推理链生成提供必要的 grounding 线索,有助于提升监督信号的准确性。整体来看,seed questions、meta information 和 quality verification 三者相互配合,使 Cogito-Pipe 能够构建高质量、多样化且逻辑一致的音频推理数据,从而帮助 Audio-Cogito 有效超越基座模型。
总结
本文提出了 Audio-Cogito,一个面向大音频语言模型深度推理能力的完全开源解决方案。针对现有音频推理模型推理能力不稳定、数据资源不足、复杂 CoT 数据依赖闭源模型等问题,我们设计了自动化数据构造流水线 Cogito-Pipe,通过多领域数据收集、问答构建、CoT 自蒸馏生成和双阶段质量验证,构建了 545k 条高质量音频推理样本。
Audio-Cogito 在 Interspeech 2026 Audio Reasoning Challenge 中取得季军的优异成绩。特别是在复杂混合音频场景中,在复杂场景下,Audio-Cogito 展现出更强的推理能力和更可靠的 CoT 生成质量。该工作为构建可复现、可扩展、开源的大音频推理模型提供了一条有效路径,也为未来音频智能从“听见”和“理解”走向“思考”提供了新的探索方向。
参考文献
[1] R. Zhang et al., “Improve vision language model chain-of-thought reasoning,” Proc. ACL, 2025.
[2] C. Tang et al., “SALMONN: Towards generic hearing abilities for large language models,” arXiv preprint arXiv:2310.13289, 2023.
[3] Y. Chu et al., “Qwen2-Audio Technical Report,” arXiv preprint arXiv:2407.10759, 2024.
[4] S. Ghosh et al., “Audio Flamingo 2: An audio-language model with long-audio understanding and expert reasoning abilities,” Proc. ICML, 2025.
[5] Z. Ma et al., “Audio-CoT: Exploring chain-of-thought reasoning in large audio language model,” arXiv preprint arXiv:2501.07246, 2025.
[6] A. Goel et al., “Audio Flamingo 3: Advancing audio intelligence with fully open large audio language models,” arXiv preprint arXiv:2507.08128, 2025.
[7] F. Tian et al., “Step-Audio-R1 Technical Report,” arXiv preprint arXiv:2511.15848, 2025.
[8] J. Xu et al., “Qwen3-Omni Technical Report,” arXiv preprint arXiv:2509.17765, 2025.
[9] Z. Ma et al., “MMAR: A challenging benchmark for deep reasoning in speech, audio, music, and their mix,” arXiv preprint arXiv:2505.13032, 2025.
[10] Z. Ma et al., “The Interspeech 2026 Audio Reasoning Challenge: Evaluating reasoning process quality for audio reasoning models and agents,” 2026.
