
 语音小管家
近年来,端到端口语对话(S2S)与语音合成(TTS)技术正加速从“可懂、可用”向“自然、拟人”发展。尤其在智能座舱、语音助手等实际应用场景中,用户对语音交互的期待已不再局限于内容准确,还希望模型能够展现接近真人的表现力,包括细腻的情绪起伏、丰富的韵律变化以及自然的对话感。
然而,当前语音生成领域仍面临明显的“度量鸿沟”:传统客观指标,如DNSMOS和UTMOS,主要关注音质纯净度与整体自然度,难以完整捕捉人类感知中的语音表现力,甚至可能对富有情绪和韵律变化的动态语音给出较低评价;人工MOS评测虽然更贴近真实感知,却成本高昂、周期较长,难以大规模复现,也难以持续为模型训练和迭代提供稳定的自动化反馈信号。
针对这一痛点,香港中文大学(深圳)与理想汽车的联合研究团队从语音学与心理学交叉视角切入,提出DeEAR(Decoding the Ear)框架,以少量人类偏好数据为锚点,实现对语音表现力精细、可解释的客观量化。论文“Decoding the Ear (DeEAR): A Framework for Objectifying Expressiveness from Human Preference Through Efficient Alignment”正式被Interspeech 2026Oral接收,为语音表现力的自动评估、数据筛选和模型优化提供了一套数据高效且可解释的解决方案。
论文题目:Decoding the Ear (DeEAR): A Framework for Objectifying Expressiveness from Human Preference Through Efficient Alignment
作者列表:林智羽、杨景雯、赵佳乐、刘猛、李孙竹、岳政君、王本友
合作单位:香港中文大学(深圳)、理想汽车、深圳河套学院
论文预印版:https://arxiv.org/abs/2510.20513
项目主页:https://freedomintelligence.github.io/ExpressiveSpeech/
代码仓库:https://github.com/FreedomIntelligence/ExpressiveSpeech
尽管端到端口语对话(S2S)与语音合成(TTS)技术在语音可懂度和音质方面持续进步,合成语音中的“机械感”仍然是制约用户体验的重要因素。现有客观指标,如DNSMOS和UTMOS,主要用于衡量语音质量与自然度,难以有效捕捉人类感知中复杂的表现力特征。
一段语音即使十分清晰,也不一定具有生动的情绪表达、自然的韵律变化和真实的对话感。另一方面,表现力评估通常依赖人工MOS打分,虽然能够直接反映人类感知,但评测成本较高、耗时较长,难以扩展至大规模模型比较、训练数据筛选和持续的模型迭代。
为解决这一问题,本文提出DeEAR(Decoding the Ear) 框架,通过高效的人类偏好对齐,将人类对语音表现力的主观感受转化为可计算、可解释的客观分数。
DeEAR的核心思想是将抽象的“语音表现力”分解为三个具有明确感知含义的子维度,并针对不同维度的特点分别设计建模方法:
1. Emotion(情绪强度):衡量语音中情绪表达的活跃程度,即情绪唤醒度。基于预训练的wav2vec2-large-robust模型,在双语情感数据上进行微调,实现对情绪强度的量化打分。
2. Prosody(韵律丰富度):捕捉语调、节奏、重音等超音段特征。研究发现,仅使用F0方差等规则特征,难以判断一段语音韵律变化的丰富程度。因此,本文采用Gemini 2.5 Pro作为自动化专家评估器,并设计了基于推理过程的Prompt,从而获得与人类感知较高的一致性。
3. Spontaneity(自发性):评估语音是否具有自然、非照本宣科的真实对话风格。研究利用DNSMOS等质量信号设计了启发式伪标签策略,并通过模型微调,实现对语音自发性的自动量化。
整体表现力融合与统一模型蒸馏:人类对整体表现力的判断并不是三个维度的简单线性相加。为建模这种非线性关系,研究基于约500条人工标注语音训练XGBoost回归器,学习Emotion、Prosody和Spontaneity三个子维度与整体表现力之间的映射,最终输出0—100分的整体表现力分数。为提升大规模评估和部署效率,研究进一步使用三个专业评分器为20,000条未标注语音生成子维度伪标签,并将其评分能力蒸馏到基于wav2vec2-large-xlsr-53的统一学生模型中。
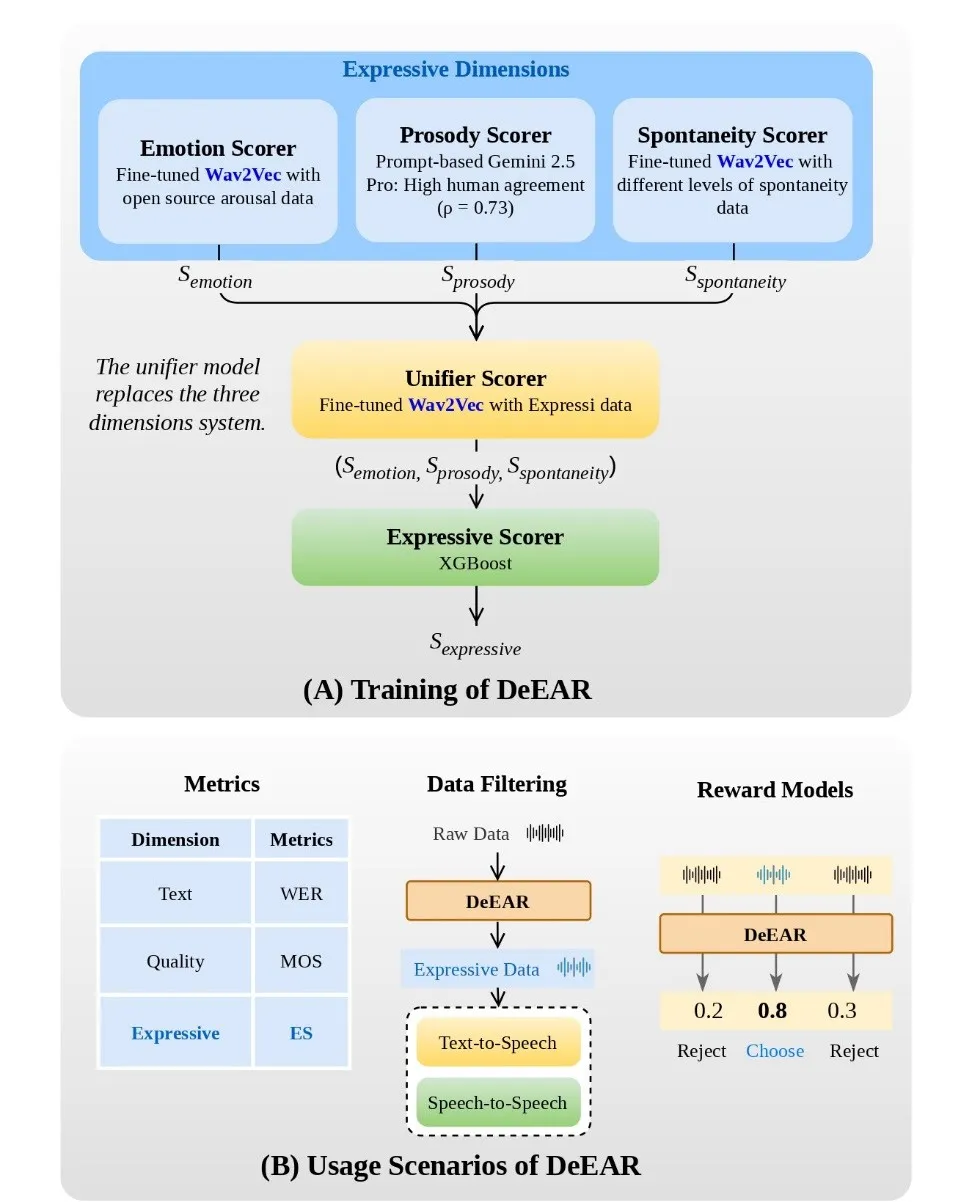
图1DeEAR整体框架与应用场景
(A)DeEAR的训练流程,包括语音表现力的三维分解、子维度评分器构建、统一学生模型蒸馏,以及基于XGBoost的整体表现力融合;(B)DeEAR在模型评测、数据筛选和奖励建模中的应用。
1.人类对齐性能
在包含400条语音的多样化测试集上,DeEAR表现出与人类专家高度一致的判断能力。实验数据显示,DeEAR预测的整体表现力分数与人类平均打分之间的皮尔逊相关系数(PCC)达到0.91,斯皮尔曼秩相关系数(SRCC)达到0.85。
2.系统级基准评测
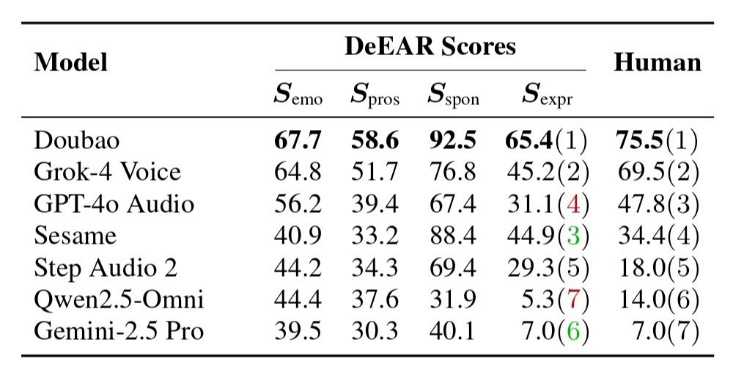
利用DeEAR对当前7个具有代表性的S2S口语对话模型(包括DouBao、GPT-4o Audio、Qwen2.5-Omni等)进行评估。结果显示,DeEAR评分得出的系统排名与人类主观排名的SRCC高达0.93。值得注意的是,DeEAR成功量化了顶尖模型与末位模型之间巨大的表现力鸿沟,两者得分差距达60.1分,表明该指标具有较强的模型区分能力。
表1展示了各模型在情绪、韵律、自发性和整体表现力维度上的DeEAR得分,并与人工评测结果进行对比。括号内为对应的系统排名,绿色和红色分别表示DeEAR给出的排名高于或低于人工评测排名。
表1DeEAR与人工评测的系统级对比
3.数据筛选与模型微调
DeEAR被进一步应用于构建高质量语音数据集ExpressiveSpeech。研究对Expresso、NCSSD、M3ED、MultiDialog和IEMOCAP等开源数据集进行统一评分与筛选,最终获得约1.4万条中英文语音样本,中英文比例基本均衡,总时长约51小时。筛选后的ExpressiveSpeech平均DeEAR表现力得分达到80.2,明显高于原始数据源。
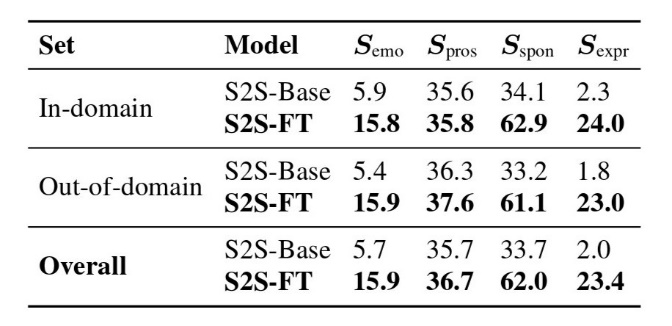
使用ExpressiveSpeech数据集对基线S2S模型进行微调后,模型的整体表现力得分从2.0显著提升至23.4。具体如表2所示:
表2S2S模型微调前后的表现力评分
DeEAR为客观量化语音表现力提供了一种数据高效、可解释的解决方案,仅使用不到500条人工标注语音,即可实现与人类主观判断较高的一致性。该框架弥补了传统音质指标难以完整捕捉语音表现力的不足,也验证了自动评估指标在模型比较、数据筛选和模型优化中的实际价值。
未来,DeEAR将进一步应用于强化学习和端到端表现力优化,为训练更加自然、生动且富有情感的下一代对话语音模型提供稳定、高效的自动化反馈信号。
