
 语音小管家
一首歌从"灵感"到"成品",往往要经历词曲创作、编曲配器、人声录制、混音母带等多个环节。如果有一天,一个 AI 系统能够从一段文字描述出发,直接输出包含人声演唱、完整伴奏和段落结构的歌曲——甚至还能翻唱已有作品——这会对音乐创作意味着什么?
近日,阿里发布了一篇关于全曲音乐生成的技术报告,提出了一套统一的、支持多任务的音乐生成框架。
这套系统能够从歌词、文本描述和音乐属性出发,生成高质量、完整时长的音乐作品。它不只关注“生成一段好听的音频”,而是尝试完成一首真正意义上的完整歌曲:包含人声、伴奏、段落结构、旋律推进和整体混音质感。
目前,该框架覆盖三大核心任务:
带人声歌曲生成:输入歌词和风格描述,生成完整歌曲;
纯音乐生成:生成适用于视频、广告、游戏等场景的器乐作品;
Cover 翻唱生成:在保留原曲主旋律的基础上,进行风格化重新演绎。
在独立第三方评测平台Artificial Analysis的 Music with Vocals 排行榜上,研究团队以匿名代号 “Lucky Dolphin” 提交系统,取得Elo 1129、官方排名区间 2-3的成绩。其与第二名 Mureka V8 的差距仅为 12 Elo,且两者 95% 置信区间高度重叠,处于同一领先性能梯队。
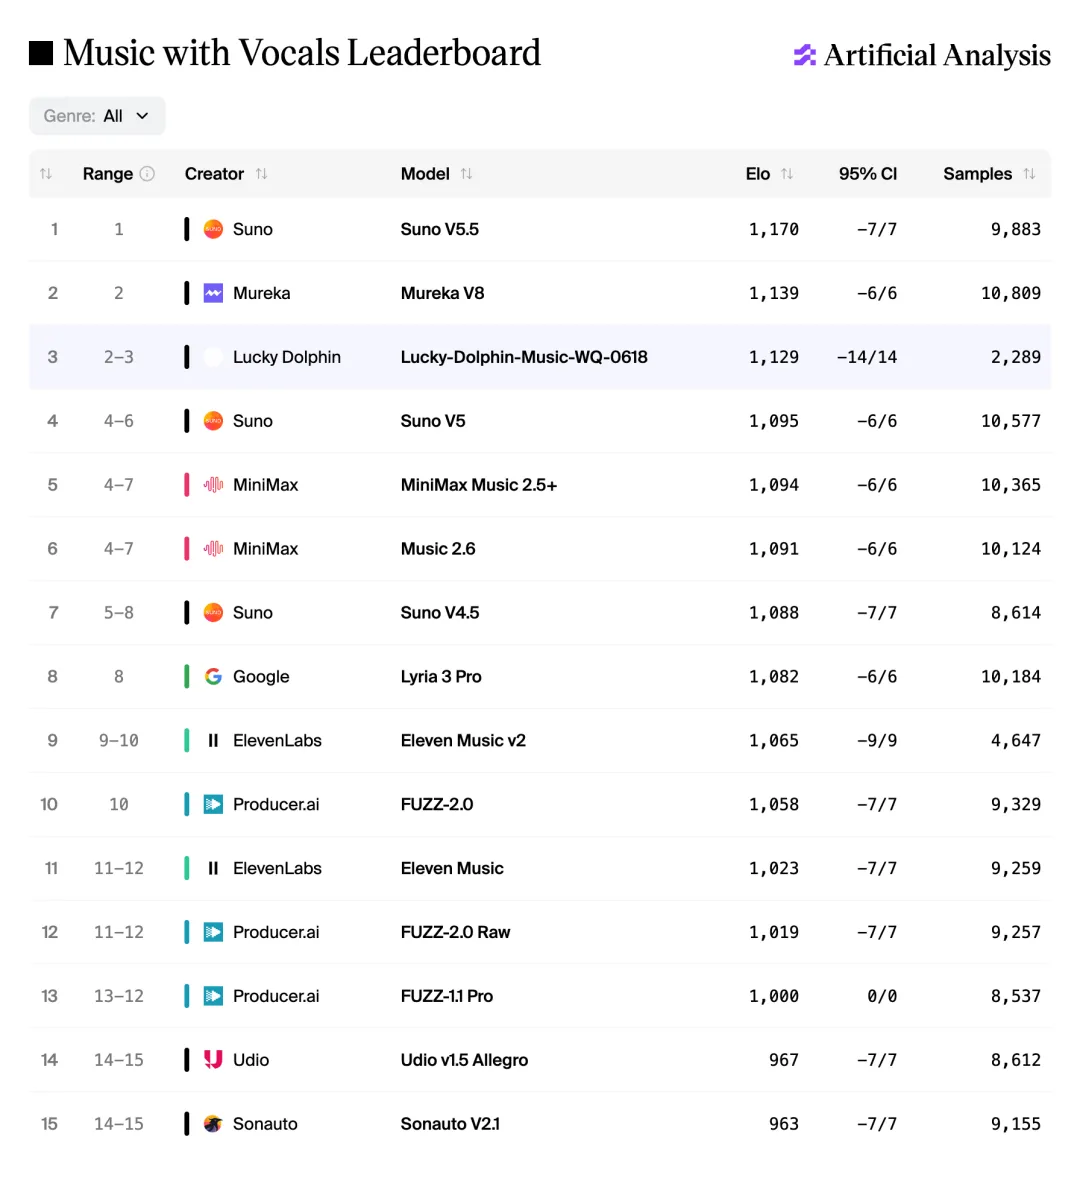
(图1:Artificial Analysis Music with Vocals 排行榜截图)
(图1:Artificial Analysis Music with Vocals 排行榜截图)
音乐生成近年来已成为生成式建模领域的核心挑战之一。与通用音频生成不同,全曲生成(full-song generation)对系统提出了较高要求:一首完整的歌曲通常包含歌词完整度、人声旋律、伴奏编曲、节奏组、和声进行以及长程段落结构(intro-verse-chorus-bridge-outro)等多个相互交织的音乐要素。一个实用的系统不仅需要支持开放域的歌曲生成,还应具备纯音乐生成和旋律可控的 Cover 翻唱能力。
研究团队在报告中指出了当前技术路线面临的三个核心困难:
音乐内容高度复杂:一首歌里往往同时存在人声、鼓、贝斯、和声乐器、旋律乐器等多种声音元素。简单的单码本表示很难充分表达这些复杂内容,因此需要更强的音乐表示能力。
长时一致性要求很高:如果采用分块生成再拼接的方式,局部可能听起来不错,但整首歌容易出现段落断裂、音色不统一、空间感不一致等问题。
Cover 翻唱需要保留旋律:Cover 并不是简单换音色。模型需要在改变风格、音色或编曲的同时,保留原曲的旋律识别度。这对旋律建模能力提出了更高要求。
那么,这套系统具体能做什么?接下来从三个核心任务逐一来看。
1. 歌词到歌曲:从文本直接生成完整演唱作品
用户可以提供歌词、风格描述、情绪、人声特征等信息,系统生成包含人声演唱和伴奏编曲的完整歌曲。
2. 纯音乐生成:为视频、广告、游戏提供配乐素材
系统也支持纯音乐生成。对于很多内容生产场景来说,纯音乐的需求其实更大。例如Vlog 背景乐,品牌广告配乐,游戏场景音乐,影视预览音乐,直播间背景音乐,产品宣传片配乐等。
3. Cover 翻唱生成:保留旋律识别度,重新演绎风格
团队引入了双层级旋律建模机制:一方面提取音符级旋律轮廓,让模型知道“这首歌的旋律骨架是什么”;另一方面提取帧级音高变化,让模型能够保留滑音、颤音等自然演唱细节。这样生成的 Cover 作品既能保持原曲的旋律识别度,又能呈现更自然的人声表现力。
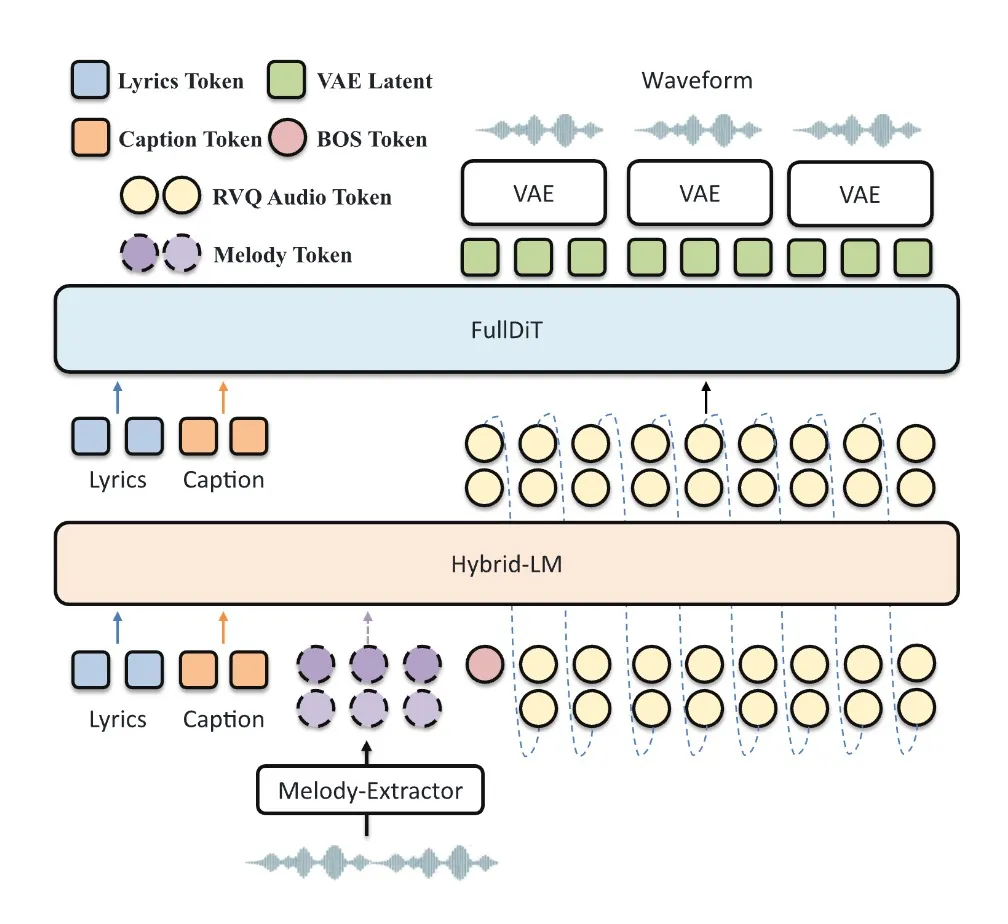
(图2:系统整体架构图)
(图2:系统整体架构图)
给定自然语言音乐描述、可选歌词以及可选参考音频,系统首先构建结构化的文本条件;随后由 Hybrid-LM 自回归预测离散音频 token;对于 Cover 任务,旋律模块从参考音频中提取并离散化音符级与帧级音高线索,作为附加条件注入 Hybrid-LM;最终,FullDiT以完整的 8 码本 codec 序列、歌词和文本描述为条件,在连续 VAE 潜空间中生成全曲声学表示,并解码为高保真波形。
为了让生成结果更符合真实用户偏好,团队还在后训练阶段引入了多种偏好对齐策略。
1. Semantic-Aware RVQ Tokenizer:多任务训练的分词器
研究团队设计了一个三阶段,多任务训练的分词器,不仅能“压缩音频”,还会尽量保留音乐中的关键信息。不仅包括歌词内容,还包括音高结构,声学细节,音色特征,音乐语义等音乐细节。
2. Hybrid-LM:全局模型管结构,局部模型管细节
Hybrid-LM采用分层自回归设计,可以理解为两个层级:
全局层:负责整首歌的“大局”:专注于长程音乐依赖关系,包括旋律发展、节奏连续性、歌词推进、段落转换、重复结构以及整体歌曲布局。
局部层:负责每一帧声音细节:局部模型则在全局规划的基础上,补齐更细粒度的声学 token,让声音更丰富、更真实。
3. Two-Level Melody Module:Cover 如何学习原曲旋律
在 Cover 生成中,旋律控制非常关键。团队设计了两类旋律线索。两者结合后,Cover 生成既能保留原曲旋律,又能避免机械式音高复制。
MIDI 级旋律轮廓:MIDI token 更偏音符级,它捕捉的是旋律的整体走向,例如音高变化,音符长度,旋律线条,歌曲识别度。
帧级 F0 音高细节:F0 token 更细粒度,可以捕捉演唱中的自然变化,例如滑音,颤音,语气变化,人声表现力。
4. FullDiT:全曲渲染,音质优势的核心来源
如果说 Hybrid-LM 更像是在“写歌”和“编曲”,那么FullDiT更像是在做最终的“混音和渲染”。FullDiT 的一个关键设计是:它不是分块生成,而是在整首歌的尺度上进行统一建模。此外,FullDiT 还会结合歌词、文本描述和离散音乐 token 一起进行生成,使最终音频不仅符合音乐结构,也能响应文本语义。最终,系统可以输出 48kHz 立体声音频,在音质规格上更接近专业音乐制作场景。甚至可以从成品中获得更好的音质。下面尝试了基于Suno V5.5的歌曲进行重建,得到了比Suno更好的音质:
5. 多阶段后训练策略:让生成音乐更好听
为了让生成结果更符合真实用户偏好,团队还在后训练阶段引入了 DPO、GRPO、OPD等多种偏好对齐策略。让模型不仅要学会“生成音乐”,还要学会判断:
哪种旋律更好听;
哪种编曲更合理;
哪种人声更自然;
哪种混音更舒服;
哪种整体效果更符合人类审美。
此外,团队还针对 FullDiT 的音质渲染进行了进一步优化,重点提升人声与伴奏的平衡、立体声空间感以及整体听感质量。
1. Artificial Analysis 榜单:跻身 Top 2-3
在第三方评测平台Artificial Analysis的 Music with Vocals 排行榜上,研究团队以匿名代号 "Lucky Dolphin" 提交系统。该榜单基于盲测偏好评估,共收集 2,105 个评估样本。
2. 多基准评测:18 维中 15 项领先
研究团队在自建的多语言自动评测基准上进行了系统对比,测试集包含 500 条用例,覆盖中英日韩西 5 种语言、8 大音乐风格,对比对象包括 Suno V5.5、Suno V5、Mureka V8、Lyria 3 Pro 和 MiniMax Music 2.6。总计在 18 个报告维度中,本文系统取得了15 个维度的最高分。
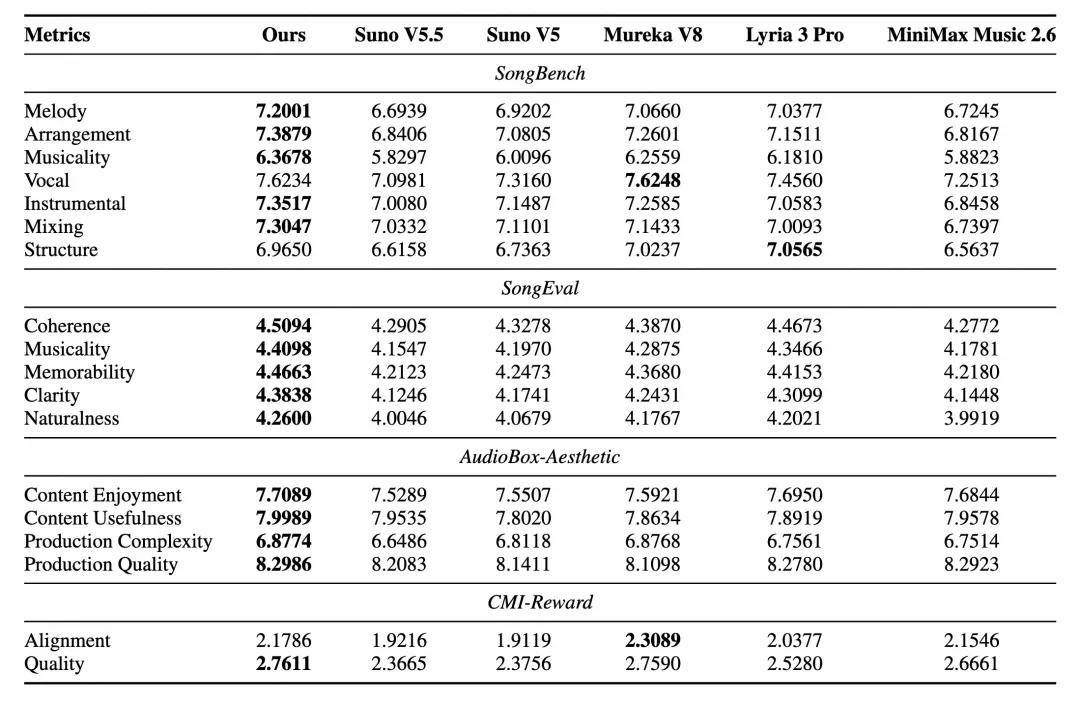
(图3:多基准自动评测结果)
(图3:多基准自动评测结果)
这项研究提出了一个统一、可控的全曲音乐生成框架,在单一系统内支持歌词生成歌曲、纯音乐生成和 Cover 翻唱三项任务。通过语义感知 RVQ 分词器、分层自回归语言模型、双层级旋律模块和 FullDiT 全曲渲染器的协同设计,该框架在离散音乐规划、旋律控制与全长高保真合成之间建立了有效桥梁。
它带来的价值不只是技术指标上的提升,更重要的是为音乐创作提供了一种更完整的生产方式:
对普通创作者来说,它可以降低完整歌曲创作的门槛;输入歌词和风格描述即可得到完整歌曲,无需编曲经验;
对专业音乐人来说,它可以作为快速生成 demo、尝试编曲风格和进行二创的工具;FullDiT 输出的 48kHz 立体声音频接近专业制作规格,可直接用于 demo 制作和编曲风格探索;
对内容产业来说,它在短视频、广告、游戏、影视、虚拟人演唱等场景中都具备应用潜力。Cover 翻唱与纯音乐生成能力使其在短视频、广告、游戏、影视、虚拟人演唱等场景中具备直接应用潜力。
