CV开启大模型时代!谷歌发布史上最大ViT:220亿参数,视觉感知力直逼人类

ViT模型何时才能破万亿? Transformer无疑是促进自然语言处理领域繁荣的最大功臣,也是GPT-4等大规模语言模型的基础架构。 不过相比语言模型动辄成千上万亿的参数量,计算机视觉领域吃到Transformer的红利就没那么多了,目前…
116 0 0

ViT模型何时才能破万亿? Transformer无疑是促进自然语言处理领域繁荣的最大功臣,也是GPT-4等大规模语言模型的基础架构。 不过相比语言模型动辄成千上万亿的参数量,计算机视觉领域吃到Transformer的红利就没那么多了,目前…
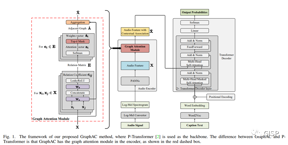
本文由哈工程智能信号处理组与悉尼科技大学、萨里大学合作,发表于IEEE信号处理学会期刊IEEE Signal Processing Letters,论文一作为2020级硕士研究生肖飞扬。 论文链接:https://arxiv.org/abs…

PRESTO–一个多语言数据集,用于解析现实的面向任务的对话。 虚拟助理正日益融入我们的日常生活。它们可以帮助我们完成很多事情:从设置闹钟到在地图导航,甚至可以帮助残疾人更容易地管理他们的家。随着我们使用这些助手,我们也越来越习惯于使用自然…
今日论文合集:cs.SD语音5篇,eess.AS音频处理7篇。 cs.SD语音 【1】 PD-ADSV: An Automated Diagnosing System Using Voice Signals and Hard Voting…

寻找那些ChatGPT/GPT4开源“平替”们。 本文来源丨https://github.com/chenking2020/FindTheChatGPTer ChatGPT爆火出圈,国内很多高校、研究机构和企业都发出类似ChatGPT的发布…

今日论文合集:cs.SD语音5篇,eess.AS音频处理5篇。 cs.SD语音 【1】 Soft Dynamic Time Warping for Multi-Pitch Estimation and Beyond标题:用于多基音估计及超越…
今日论文合集:cs.SD语音9篇,eess.AS音频处理9篇。 cs.SD语音 【1】 Enhancing Speech-to-Speech Translation with Multiple TTS Targets标题:利用多个TTS目标…
130亿参数模型权重公布不久,UC伯克利LMSys org再次发布了70亿参数「小羊驼」。同在今天,Hugging Face也发布了70亿参数模型StackLLaMA。 自从Meta发布「开源版ChatGPT」LLaMA之后,学界可谓是一片…

在影视、有声书内容中,背景音是一种表现丰富的艺术形式。语音转换(Voice Conversion)如能将源说话人语音转换成目标说话人语音的同时,保留源语音中的背景音,将会提供更沉浸的语音转换体验。之前的语音转换研究主要关注于干净语音,对于带…

今日论文合集:cs.SD语音9篇,eess.AS音频处理10篇。 cs.SD语音 【1】 Anomalous Sound Detection using Audio Representation with Machine ID based…