
声浪

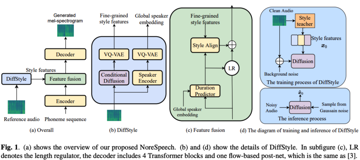
论文分享 | NoreSpeech:基于知识蒸馏的条件扩散模型实现噪声鲁棒的表现力语音合成
本次分享北京大学ADSP Lab、腾讯AI Lab和约翰霍普金斯大学联合投稿于ICASSP2023的表现力语音合成相关工作《NoreSpeech: Knowledge Distillation Based Conditional Diffu…
129 0 0
魔搭语音更新|七大模型最新开源,推理速度升级,几行代码可实现微调
自ModelScope魔搭社区发布以来,众开发者在ModelScope上传与下载模型,并集成到自己的语音识别服务中。为了方便用户更好地利用ModelScope进行语音识别服务,我们推出了语音识别基础框架FunASR,希望在语音识别的学术研究…
903 0 0
语音识别系列之CTC延迟削减
连接主义时间分类(Connectionist Temporal Classification, CTC)是自动语音识别(ASR)领域的一项经典技术,它的算法简单而优美,漂亮地解决了语音与标签对齐的难题。ASR可分为在线ASR和离线ASR,前…
145 0 0
Azure 智能语音发布长文本声音模型,可自动感知上下文
在过去的一段时间里,Azure 神经网络文本转语音服务(Neural TTS)已经在声音质量方面取得了快速发展,实现了在句子级别媲美真人的水平(查看详情[1])。但是在实际应用中,语音合成除了单句合成,也经常应用于生成长文本的段落音频,比如…
204 0 0
语音/音频处理学术速递[1.31]

今日论文合集:cs.SD语音14篇,eess.AS音频处理17篇。 cs.SD语音 【1】Knowledge Transfer from Pre-trained Language Models to Cif-based Speech Rec…
628 0 0
语音/音频处理学术速递[1.30]
今日论文合集:cs.SD语音3篇,eess.AS音频处理4篇。 cs.SD语音 【1】 Moûsai: Text-to-Music Generation with Long-Context Latent Diffusion 标题:莫赛:长语…
117 0 0
语音/音频处理学术速递[1.23]
今日论文合集:cs.SD语音3篇,eess.AS音频处理3篇。 cs.SD语音 【1】 Novel-View Acoustic Synthesis 标题:声学合成的新视角 链接:https://arxiv.org/abs/2301
87 0 0
语音/音频处理学术速递[1.20]
今日论文合集:cs.SD语音5篇,eess.AS音频处理5篇。 cs.SD语音 【1】 Music Playlist Title Generation Using Artist Information 标题:使用艺术家信息生成音乐播放列表标…
104 0 0
语音/音频处理学术速递[1.19]
今日论文合集:cs.SD语音3篇,eess.AS音频处理5篇。 cs.SD语音 【1】 An investigation of the reconstruction capacity of stacked convolutional aut…
112 0 0