CCF语音对话与听觉专业组升级为专业委员会,同时荣获专委综合进步奖

在CCF第十二届常务理事会第三次会议上,CCF语音对话与听觉专业组升级为CCF语音对话与听觉专委会,并荣获专委综合进步奖。 在2021年1月31日召开的CCF第十二届常务理事会第三次会议上,通过了关于语音对话与听觉专业组升级为语音对话与听觉…
37 0 0

在CCF第十二届常务理事会第三次会议上,CCF语音对话与听觉专业组升级为CCF语音对话与听觉专委会,并荣获专委综合进步奖。 在2021年1月31日召开的CCF第十二届常务理事会第三次会议上,通过了关于语音对话与听觉专业组升级为语音对话与听觉…
在二十年前刚刚加入谷歌时,我们关注的问题只有一个——如何面向这么多不同种类的联网计算机提供一整套质量出色且涵盖范围全面的网络信息搜索服务。到如今,尽管我们面临着各种各样的技术挑战,但谷歌已经基本达成了组织全球信息,并使其具备普遍可访问性的总…
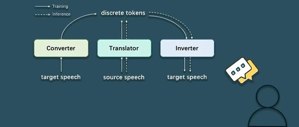
语音到语音翻译已经被越来越多地应用在人们的日常生活和工作中。但是目前的语音翻译系统高度依赖于语音对应的文本,不能应用于如方言、少数民族语言等没有文字的语言。为此,微软亚洲研究院提出了语音翻译系统 UWSpeech,该系统可针对没有文字的语言…
Mel-filterbank经常被用于训练声音分类算法,然而它存在的偏差也令其有明显的局限性。近日,Google提出了一种优于Mel-filterbank的前端LEAF,这种前端可以创建出具有最小偏差的音频分类模型。 在机器学习中,梅尔滤波…
说起语音识别,大家的第一反应就是那些看起来眼熟却总也搞不清楚的概念和公式,比如MFCC、HMM、GMM、Viterbi图、解码对齐等等,再往下深入,哪个是哪个,具体用途是什么,就都说不清楚了,总觉得那得是业内大牛才能搞懂的。去网上搜索,各种…
歌唱合成SVS(singing voice synthesis)是根据歌词和乐谱信息合成歌唱,相比于TTS使机器“开口说话”,歌唱合成则是让机器唱歌,因此更具有欣赏性。 互联网的时代,人机交互更加频繁和智能,歌唱合成则添加了人机交互的趣味性…
基于深度学习的端到端语音合成技术进展显著,但经典自回归模型存在生成速度慢、稳定性和可控性差的问题。 去年,微软亚洲研究院和微软 Azure 语音团队联合浙江大学提出了快速、鲁棒、可控的语音合成系统 FastSpeech,近日研究团队又将该技…
高仿真的音频合成需要处理高采样率的音频数据,尤其是歌唱合成。相对于使用16kHz和24kHz的音频,使用48kHz的音频将会覆盖更宽的频带和更长的音频序列,这将给音频合成造成极大的挑战。本文针对使用48kHz音频带来的问题,提出了HiFiS…
WACV 2021的录用论文Visual Speech Enhancement Without A Real Visual Stream。该文研究涉及计算机视觉与语音处理的交叉。 论文信息
在刚刚结束的NIST OPENASR评测中,TEG AI语音联合清华大学,刷新世界小语种语音识别比赛6项第一。从2000年开始,NIST组织的RT(英文语音识别),LRE(语音语种识别),SRE(语音说话人识别),OPENKWS(语音关键词…