
 语音小管家
AI 做音乐这件事,过去一年我们看着 Suno、Udio 一路高歌,Demo 一个比一个惊艳,价格也一个比一个贵。
然后我们再回头看开源世界——不是模型出不来歌,就是质量差一截,或者干脆闭源让你摸不着它是怎么把词变成旋律的。
最近,港科大、纽约大学、斯坦福、MBZUAI 加上 ACE Studio 和 Tokenwave.AI 一起出的开源模型 YuE2,把这条路拆成了两段。
中间多了一份东西——一份能看、能改、甚至能喂回去重新唱的旋律和弦谱。就像你先拿到一张草图,觉得线条不对可以擦,比例不对可以调,改满意了再让它上颜色。
这件事本身比"开源模型追平 Suno v6"更值得聊。
⏩项目介绍
YuE2 是 Multimodal Art Projection(M·A·P)团队继 YuE 之后的第二版开源音乐生成模型。
第一版 YuE 在 2025 年初发布时已经是当时最强的开源歌词转歌曲模型——7B 参数、支持 5 分钟长曲、中英日韩多语言。
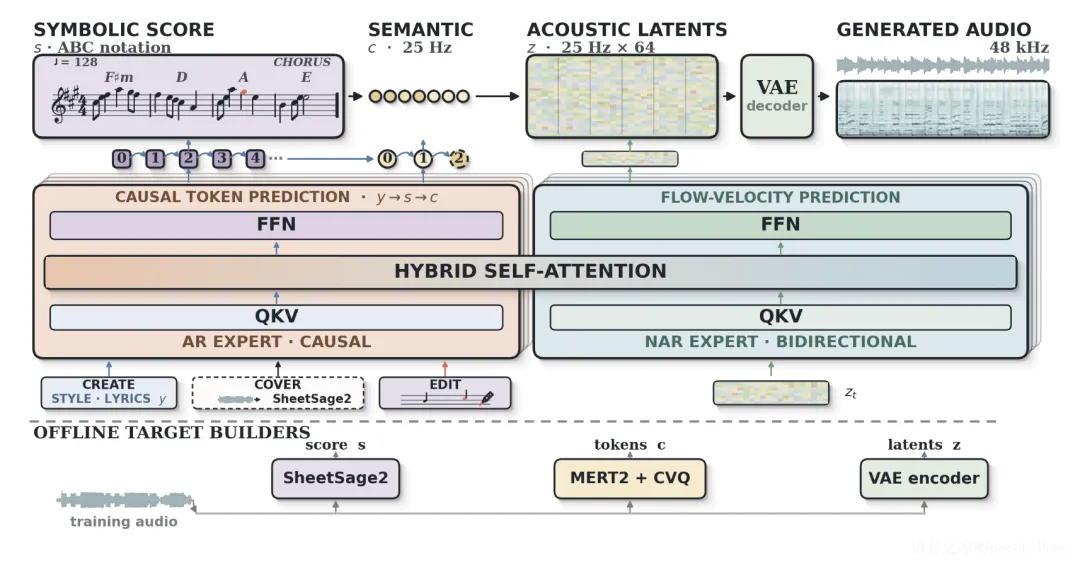
YuE2 在架构上做了更根本的改造。模型缩到了 3.59B 参数,但核心能力换成了两件事:符号规划(Symbolic Planning) 和 可编辑中间表示。
给它歌词和风格描述,它先输出一份 ABC notation 格式的旋律+和弦谱——这不是一个隐层向量,这是一份人能读、能弹、能直接拿去改的谱子。然后再从这份谱子渲染出带人声伴奏的 48 kHz 立体声成品。
这个两阶段流程让它和 Suno、Udio 的黑箱式生成从根本上区分开来:YuE2 生成音乐走的路线,更像一个真正的作曲家——先写谱,再配器,再演奏。
⏩核心亮点
1. 那份能改的谱,是整个项目最值钱的东西
YuE2 的 plan() 方法输出的不是一串不可读的 token,而是标准的 ABC notation[1]——一种自 19 世纪就存在、被世界各地乐手广泛使用的简化乐谱格式。
你可以用任何 ABC 阅读器(比如 abcjs[2])把它渲染成五线谱,或者直接丢给 MuseScore 打开。
改完存成新文件,交回 YuE2 的 synthesize() 步骤就能渲染出新版。
2. 零样本翻唱,一份录音转出新演绎
YuE2 配套了一个专门的转录模型叫 SheetSage2。
它能把一段现成的录音(比如你手机里录的一段清唱,或者一首老摇滚的旋律线)转成 ABC 格式的旋律谱。拿到这个谱之后,你可以:
- • 配一套全新的歌词,用 YuE2 唱一遍
- • 换个风格描述,比如把一段日本 city pop 的旋律套上 "English, jazz-funk, warm lead vocal, Rhodes"
- • 保持旋律不动,只换和弦(cot="melody" 模式)让伴奏跟上新风格
3. Agent 式编辑:把改歌这件事交给代码里的 AI
YuE2 是目前少数几个原生自带 Agent Skill 的开源模型。
所谓 skill,就是给 AI 编程工具写的一套指令包——告诉它这个模型有哪些能力、怎么调用、参数是什么、谱子怎么读怎么改。
YuE2 的 skill 直接放在 GitHub 仓库的 skills/yue2-music/SKILL.md 里。你把这个目录丢给 Claude Code 或 Cursor,然后直接对它说:
用 YuE2 写一首英文 piano pop,出两个版本——第一版用原和弦,第二版把副歌换成爵士和声,人声旋律和歌词顺序保持不变,给我两个版本做对比。
AI 会自己调 pipeline 生成第一版,把谱子导出来,改和弦,再渲染第二版,最后把两个 audio.flac 和对应的谱子一起给你。
整个过程你只给自然语言指令,中间的规划、转谱、改和弦、重新渲染全是 AI 代理帮你做的。
⏩快速上手
git clone https://github.com/multimodal-art-projection/YuE.git
cd YuE
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install .
从歌词和风格生成
python examples/generate.py --output outputs/first-song输出目录里会有 audio.flac 和 score.abc。
Python API
import json
from pathlib import Path
from yue2 import YuE2Pipeline

request = json.loads(Path("examples/song.json").read_text(encoding="utf-8"))
with YuE2Pipeline.from_pretrained("m-a-p/YuE2-3B", device="cuda") as pipe:
    song = pipe(**request)
    song.save_artifacts("outputs/my-song")
编辑已有谱子
from yue2 import YuE2Pipeline

with YuE2Pipeline.from_pretrained("m-a-p/YuE2-3B", device="cuda") as pipe:
    # 先拿规划结果
    plan = pipe.plan(**request)
    plan.save("outputs/plan")
    # 手动改 output/plan/score.abc,或者用 Agent 帮你改
    # 然后重新渲染
    edited = pipe.synthesize(abc=Path("edited.abc").read_text(), cot="full")
翻唱
from yue2 import YuE2Pipeline

with YuE2Pipeline.from_pretrained("m-a-p/YuE2-3B", device="cuda") as pipe:
    cover = pipe(
        style="English, jazz-funk, warm lead vocal, Rhodes, bass and drums",
        lyrics=Path("cover-lyrics.txt").read_text(encoding="utf-8"),
        abc=Path("cover-score/score.abc").read_text(encoding="utf-8"),
        cot="melody",  # 翻唱用 melody 模式,让伴奏自由适配
        seed=42,
    )
    cover.save_artifacts("outputs/cover")
⏩评测数据
WildSongBench 是团队自建的 192-prompt 评测集,2026 年 9 月 12 日发布。
YuE2 在 SongBench Avg(综合质量 + 文歌对齐)的表现:
| 系统 | SongBench Avg ↑ | AudioBox PQ ↑ | MuLan ↑ | PER ↓ |
|---|---|---|---|---|
| YuE2 (best-of-8) | 6.9632 | 8.2714 | 0.5051 | 9.79% |
| Mureka 9 | 6.9377 | 8.0226 | 0.4394 | 11.69% |
| Suno v5 | 6.8721 | 8.1698 | 0.5428 | 8.10% |
| YuE2 | 6.7316 | 8.2598 | 0.5068 | 8.44% |
| Suno v6 | 6.5562 | 8.1296 | 0.4916 | 7.58% |
| LeVo 2 | 6.3247 | 8.3966 | 0.3542 | 26.12% |
| YuE 1 | 4.9165 | 7.8683 | 0.2623 | 36.38% |
YuE2 单跑就已经超过 Suno v6,best-of-8 采样后甚至超过 Suno v5 和 Mureka 9。
不过 README 里也老老实实承认:"最高几个分数的差距很小,不代表统计显著性差异。" 实话实说,这点值得表扬——不像有些模型宣传"全面碾压",YuE2 说的是"有来有回"。
零样本翻唱上,YuE2 在 948 首作品上 CLEWS mAP 0.647(有谱)vs 0.006(无谱),证明了中间谱的价值。
⏩写在最后
Suno 把 AI 做歌的门槛降到了"打一行 prompt 等 20 秒",但它没教你怎么做对——它的成功很大程度上来自一个极其庞大、极其高质量的闭源数据集。
开源世界追了一整年,YuE2 第一次把距离拉近到"差不多",而且给出了一条和 Suno 完全不同的路线:不绕开作曲这个环节,而是把它暴露给你。
对于独立音乐人来说,24GB 显存门槛不低(RTX 4090 刚好够),但"免费、可商用、能改谱、能翻唱"这四点加在一起,已经是目前开源领域里最实用的选择之一了。
⏩项目信息
- GitHub:github.com/multimodal-art-projection/YuE
- Demo:map-yue2.github.io
- 模型:huggingface.co/m-a-p/YuE2-3B
- 评测集:huggingface.co/datasets/m-a-p/WildSongBench
- Agent Skill:仓库内 skills/yue2-music/SKILL.md
引用链接
[1] ABC notation: https://abcnotation.com/
[2] abcjs: https://abcjs.net/
