
 语音小管家
传统声纹识别只估计一个「均值」——一个确定的嵌入点,却从不估计它的「方差」——这个估计到底有多可信。而一段语音里,并不是每一帧都「平等」:噪声、混响、静音都在悄悄稀释说话人的身份线索。这个缺失的方差,正是「不确定性」。本文提出的 U³-xi 框架,让模型学会估计并善用不确定性——均值说「身份」,方差说「确定性」。 在 VoxCeleb1 测试集上,U³-xi 取得了 EER 相对提升 21.1%、minDCF 相对提升 15.57% 的成绩,且可无缝迁移到多种主流说话人编码器。
论文标题与作者(Junjie Li、Kong Aik Lee,香港理工大学)
📄 发表:IEEE Transactions on Audio, Speech and Language Processing (TASLP), 2026(已录取)
📄 论文:https://arxiv.org/abs/2601.15719
💻 代码:https://github.com/mrjunjieli/wespeaker_u_cube(基于 WeSpeaker)
1. 一个被忽视的问题:不是每一帧都在「好好说话」
声纹识别(说话人确认)的标准流程是:编码器先把语音切成一帧帧的表示,再通过池化(pooling)把这些帧级表示聚合成一个句级(utterance-level)嵌入。常用的 x-vector 框架(统计池化,如 ASTP)默认:每帧要么同等重要,要么其重要性可以靠注意力学出来。
但真实世界的语音并不「干净」:一阵噪声盖过半句话、混响拖长了尾音、甚至干脆是一段静音——这些帧携带的说话人信息本来就少,还混着大量干扰因素(nuisance factors)。如果让这些「不靠谱」的帧和干净帧平起平坐,最终的说话人嵌入自然会被拖累。
人类的直觉很朴素:听不清的地方,就少信一点。这正是 不确定性(Uncertainty) 的用武之地——让模型为每一帧估计一个「可信程度」,不确定性越高的帧,权重越低。前作 xi-vector 已经把这一思想引入声纹识别,而本文的 U³-xi(读作 u-cube-xi)则把「不确定性建模」推向了一个更完整、更可靠的新高度。
2. 从 xi-vector 说起:给说话人嵌入配一个「不确定度」
xi-vector 的核心是一个优雅的视角:把帧级表示看作带噪声的观测。每一帧 zt = h + εt,其中 h 是潜藏的「真实」说话人变量,εt 是该帧特有的随机扰动。模型为每一帧预测一个精度(方差的倒数),再通过高斯后验推断(Gaussian Posterior Inference)聚合成句级嵌入——精度低的帧天然被降权,不确定性就这样变成了「自适应注意力」。
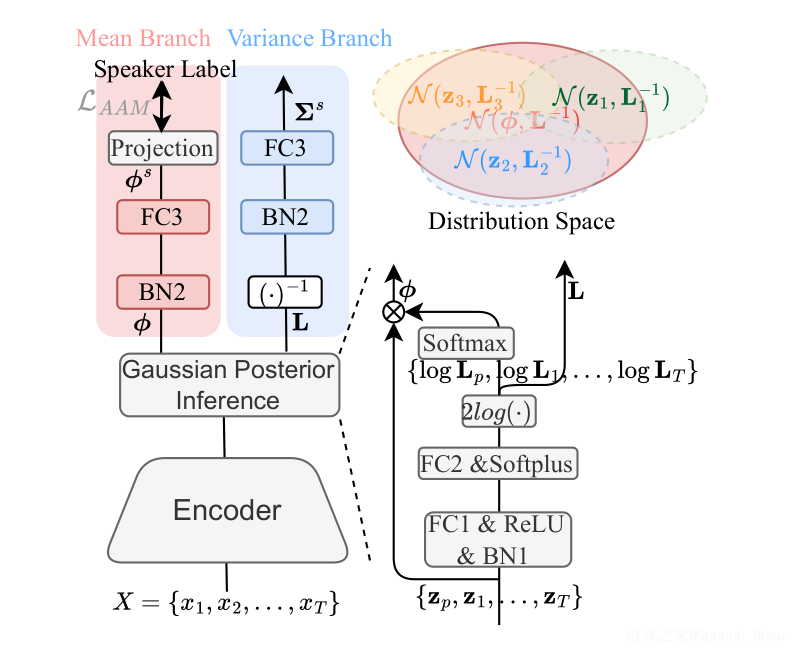
图 1:xi-vector 模型架构。均值分支与方差分支共享参数,但从统计学视角对均值与方差施加不同的运算。
这个设计很巧妙,但留下了三个明显的缺口:
- 不确定性缺乏显式监督
——仅靠交叉熵损失「隐式」学习方差,学出的不确定性往往不稳定、次优;
- 缺少全局层面的引导
——不确定性只参与聚合,没有参与分类决策边界的塑造;
- 估计模块太浅
——两层线性层难以捕捉帧与帧之间的时间依赖。
U³-xi 的三板斧,正好一一补上这三个缺口:说话人级不确定性监督(SVL)、全局级不确定性监督(UAAM)、更强的不确定性估计模块(Transformer + 多视图自注意力)。
3. U³-xi:三板斧打造可靠的不确定性
3.1 说话人级监督:让「离群程度」成为不确定性的标尺
第一板斧是 Stochastic Variance Loss(SVL)。想法非常直觉:一个句子的嵌入离它所属说话人的「质心」越远,说明这句话的不确定性就应该越大。于是,句嵌入与说话人质心之间的距离被当作伪标签(pseudo ground truth),显式监督预测的方差:
ℒSVL = (1/B) Σb ‖ α·(Σbs)1/2 − |φbs − φcyb| ‖²
其中 α 是可学习的缩放因子。质心的计算提供两种策略:Fix(用预训练模型算好固定质心)与 Pro(每个 epoch 用最新 checkpoint 动态更新,质心随训练共同演化)。SVL 从说话人内部给出确定性标尺——同一说话人,离群的话语方差大,聚集的话语方差小。
3.2 全局级监督:把不确定性注入分类决策边界
第二板斧更具开创性:Uncertainty-aware AAM-Softmax(UAAM),把预测的不确定性直接注入 softmax 的缩放因子(scale)里,定义出「不确定性感知尺度」 su——不确定性越大,su 越小,softmax 分布越平缓,决策边界越「软」。
妙处在于梯度驱动的自适应机制:困难样本损失大,优化器为了降损自然会减小 su(即放大方差),让错误 logits 的影响被平滑掉;简单样本则反过来增大 su(缩小方差),让决策边界更锐利。整个过程不需要任何人工标注的难度标签,不确定性在梯度下降中「自学成才」。
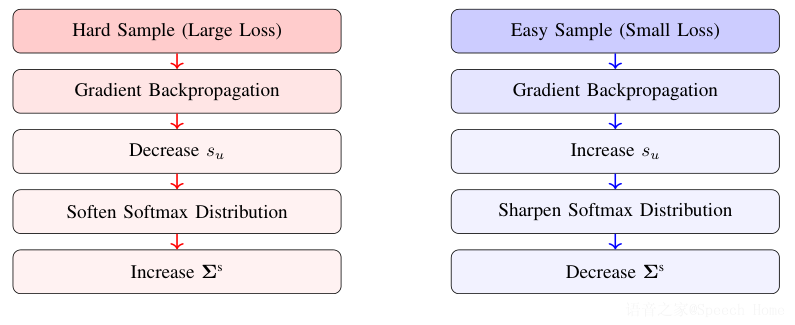
图 2:梯度驱动的尺度自适应。难样本(大损失)→ 减小 su → 软化分布 → 方差增大;易样本(小损失)则相反。
3.3 更强的估计模块:Transformer + 多视图自注意力
第三板斧重构了不确定性估计模块:抛弃原来的两层浅层线性层,引入 Transformer encoder 捕捉帧间的非线性与长程依赖,并进一步把标准多头注意力扩展为 Multi-View Self-Attention(MVA)——给每个注意力头分配一个独特的时间窗 wh = 2(h+1) + 1。
这样一来,有的头「近视眼」,专注局部细节;有的头「望远镜」,纵览长程上下文。多粒度的时序视野,恰好对应不确定性估计既要看局部畸变、又要看全局语境的需求——消融实验显示,8 头 MVA 带来了 5.48% 的相对提升。
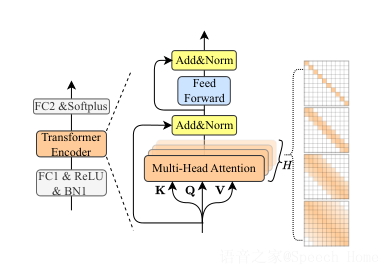
图 3:不确定性估计模块。Transformer 建模时序关系,每个注意力头分配独特的时间窗,形成多视图视角。
4. 实验:数字说话
4.1 主结果:VoxCeleb1 三个测试集全面提升
所有实验在 VoxCeleb2 上训练、VoxCeleb1 三个官方测试集(Vox1-O / E / H)上评测,默认编码器为 ECAPA-TDNN:
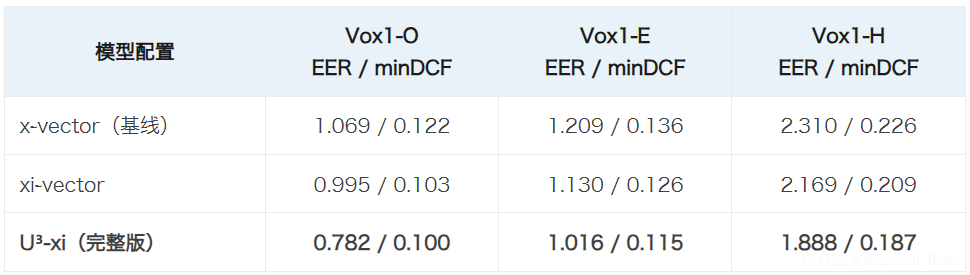
相比基线,U³-xi 实现了 EER −21.1% 与 minDCF −15.57% 的平均相对提升;相比前作 xi-vector,同样再进一步。
4.2 模型无关性:插上就能用的「不确定性增益」
更重要的是,U³-xi 是一个通用框架——把它分别插到 ECAPA-TDNN、ResNet34、ReDimNet-B2 三种主流说话人编码器上,VoxCeleb 上的提升整齐划一:
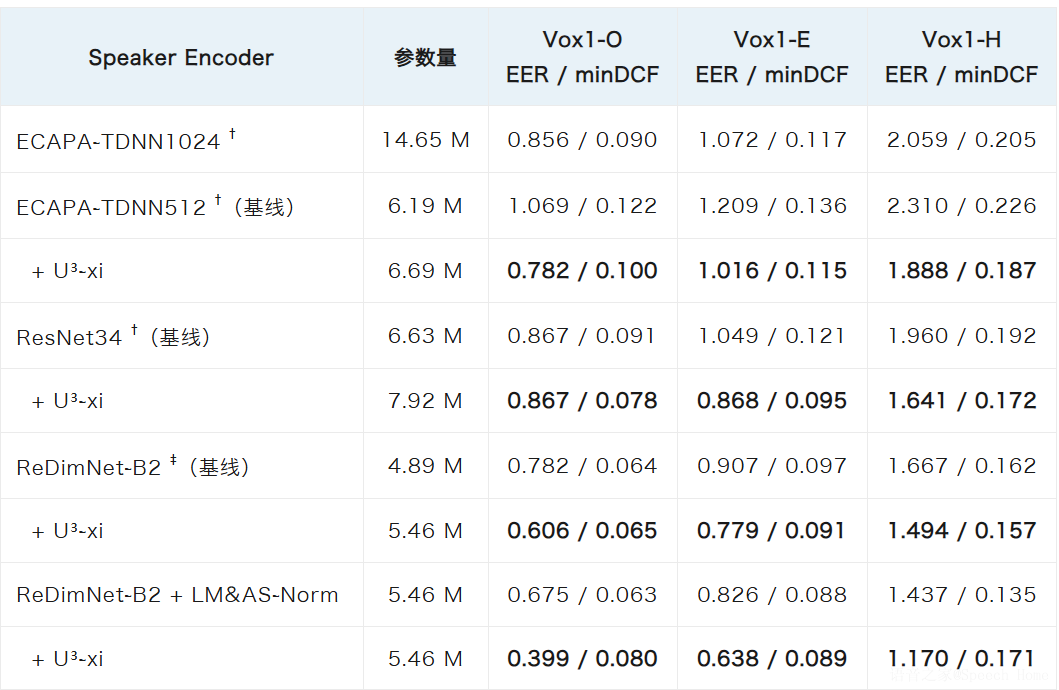
注:† 直接使用 WeSpeaker 官方预训练模型推理;‡ 自行重训;LM = 大边距微调,AS-Norm = 自适应分数归一化。
这张表里藏着几个颇有力道的细节:
- 「小模型 + 不确定性」打赢「大模型」
- 三个编码器全部稳定提升
- 与后处理技巧正交叠加
5. 看得见的「不确定性」:模型真的懂吗?
数字之外,更迷人的是这些不确定性估计真的「有道理」。
5.1 噪声越大,精度越低——帧级精度与物理世界对齐
图 4:逐段加大噪声(SNR 逐级降低)时,模型预测的帧级精度同步下降——不确定性估计与信号质量高度对齐。
把一段 60 秒的语音按 10 秒一段注入越来越强的噪声,模型预测的帧级精度曲线随之阶梯式下滑。模型没有人告诉它噪声在哪,但它「听」出来了。同样的现象也出现在频谱掩码(spectrogram masking)实验中:被抹掉的频带越多,对应帧的精度越低。
5.2 越难的样本,方差越大
图 5:训练集上句级方差与样本难度(目标类与最难竞争类的余弦间隔)的关系,Pearson 相关系数 −0.511。
用「目标类与最强竞争类的余弦间隔」度量样本难度,间隔越小越难。U³-xi 学到的方差与难度呈显著负相关(Pearson r 从 xi-vector 的 −0.166 强化到 −0.511)——难分的样本,不确定性确实更高,这正是我们期望的可解释性。
5.3 训练中的「课程学习」行为
图 6:训练过程中样本级尺度 su 的分布演化——随着训练进行,尺度整体抬升、分布收敛,模型对多数样本越来越「自信」。
观察 su 随训练 epoch 的分布变化,还能看到类似课程学习(curriculum learning)的动态:早期分布较宽、整体偏低,模型对多数样本保持「谨慎」;随着训练推进,简单样本的尺度不断抬升,决策边界逐渐收紧,只有少数困难样本维持高不确定性。先谦虚、后自信——这很符合人类的学习节奏。
6. 结语
U³-xi 的贡献可以浓缩为一句话:把不确定性从「隐式的副产品」变成「显式的、被监督的、贯穿训练与决策的一等公民」。说话人级的 SVL 给出个体标尺,全局级的 UAAM 塑造决策边界,Transformer + MVA 提供更强的估计能力——三者合力,让声纹识别模型第一次真正做到了「知道自己不知道」。
代码已基于 WeSpeaker 开源,一行配置即可把 U³-xi 插到你自己的编码器上,欢迎试用、提 issue、来交流!
知人者智,自知者明。让模型学会「自知」,也许正是通向更可靠声纹识别的必经之路。
📄 发表:IEEE Transactions on Audio, Speech and Language Processing (TASLP), 2026(已录取)
📄 论文:https://arxiv.org/abs/2601.15719
💻 开源代码:https://github.com/mrjunjieli/wespeaker_u_cube
🏫 单位:香港理工大学 电机及电子工程学系 & 数据科学与人工智能研究中心(RC-DSAI)
* 文中所有图表均来自论文原文;EER 越低越好,minDCF 越低越好(Ptarget = 0.01)。
