流式语音识别的大厦已经落成,天空中只漂浮着两朵乌云:尖峰漂移和长尾数据。本文则主要关注前者。
1. 前言:想象力的游戏
作为本文的开篇,我想先致敬一下我心中的真神:麦克斯韦(Maxwell)。他最重要的贡献,就是发现了物质的一种新的存在形式。在麦克斯韦之前,人们普遍认为物质存在的形态只有粒子形式。而麦克斯韦却发现物质还有一种新的存在形式:那就是 “场” (电磁波)。所有相互作用,都来源于这一新形式的物质。电磁波的预言像是给人类打开了认识世界和改造世界的新大门,当人们跳脱了粒子的“思维定式”,想象力和创造力得以摆脱难解的桎梏和厚重的枷锁,自然科学被推到了一个新的顶峰。在语音技术领域,尖峰漂移问题一直都是笼罩在流式语音识别晴朗天空上的一朵吹不散的乌云。此前的研究者们无一例外地都将目光和认知投射到了损失函数的改进上,这其中的典型代表为 Google 的 FastEmit [1] 和 K2 的 Delay-Penalized Transducer [2]。而在本文中,我们发现了解决尖峰漂移还有一种新的视角:那就是“数据”。深度学习的奥秘,绝大部分隐藏在数据中,我们深信:模型的潜能上限不在于模型结构/训练技巧,而在于数据。摆脱了损失函数改进的思维定式,从数据的改进出发,TrimTail 应运而生。
2. 方法:粗暴式的优雅
TrimTail 的想法很简单,甚至可以用粗暴来形容:如果模型倾向于 delay 出字时间以获取更多的 context,那么与其在损失函数上施加惩罚,不如直接从源头入手,把可以 delay 的 “空间” 直接裁掉,让模型 de 无可 de !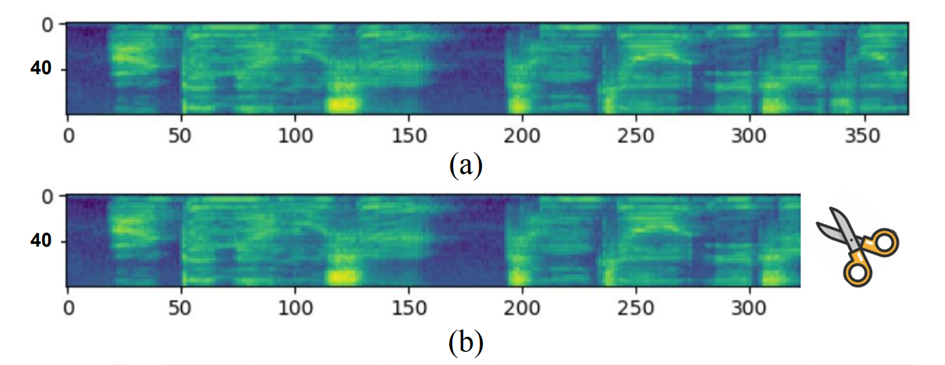
一个随之而来的问题是:应该如何裁剪这个“空间”?TrimTail 给出的答案是只裁剪尾部。通过这种尾部裁剪可以达成如下两个目的:回到我们开篇中的神之方程组,麦克斯韦方程组的优雅,不仅仅在于形式上的简洁,更在于从它出发做进一步的推导可以得到一连串的复杂结论,几乎囊括了完整的电磁理论,甚至在引入非交换李代数后可以推得 Yang-Mills 场方程。TrimTail 虽然无法做到包罗万象,但其背后蕴含的由浅入深的魅力是一致的,也即:从一个看似很简单的操作(裁剪尾部)出发,经过一连串的“推导”(多米诺骨牌式的影响扩散),最终解决了一个非常复杂的问题(全局的尖峰漂移)。从这个角度看,TrimTail 既是粗暴的,也是优雅的。
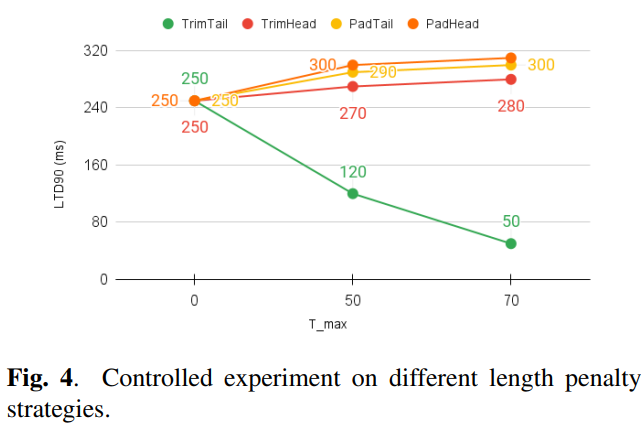
在列出枯燥无味的实验数字(WER 无损的前提下 TrimTail 尖峰前移了 XXXms )之前,我想有两个问题会是大家更感兴趣的:- 为什么只裁尾部,别的裁剪方法同样可以压缩空间,有没有效果?
为了回答上述两个问题,我们构造如下的对比实验,图 Fig.1 中从上到下依次为原始输入、裁剪了尾部的输入(TrimTail)、裁剪了头部的输入(TrimHead)、拼接了尾部的输入(PadTail)和拼接了头部的输入(PadHead)。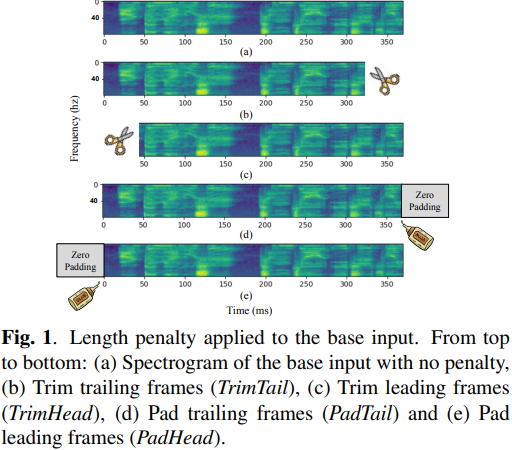
4. 在实际生产环节如何使用?
由于 TrimTail 是数据角度出发思考得到的方法,从出生开始就天然地摆脱了模型结构和损失函数等方面的掣肘,再加上其简洁的实现(有效代码仅五行)和清晰自洽的理论,使得 TrimTail 真正做到了:TrimTail is computationally cheap and can be applied online and optimized withAnytraining loss orAnymodel architecture onAnydataset withoutAnyextra effort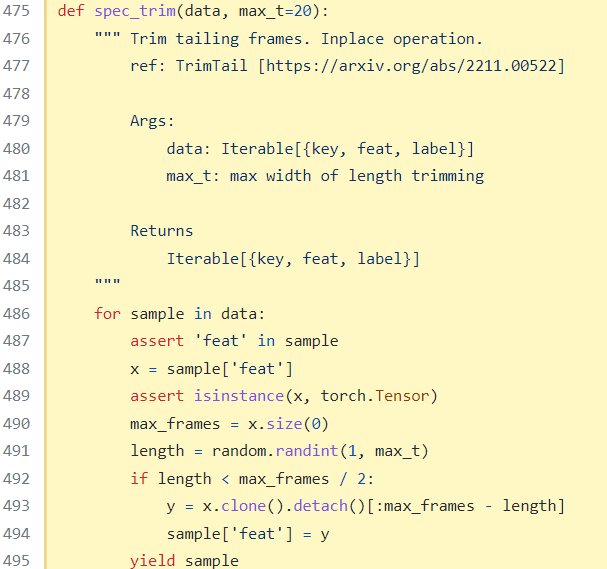
吹完了牛逼,我们来说一点更实际的,在读者自己的内部数据上,TrimTail 的 max_t 阈值应该如何选择?我们的实验结论是:训练数据平均长度的15%是一个分水岭,max_t 低于它,TrimTail 在前移尖峰(100~200ms)的同时几乎不会带来wer损失,而 max_t 高于它,TrimTail会有0.5+的wer损失,但相应地,尖峰也会更多地前移(300ms)。这个经验性结论在 aishell 和 librispeech 上都得到了验证。同样地,在我们内部的上万小时级别数据上,15%的结论依然成立。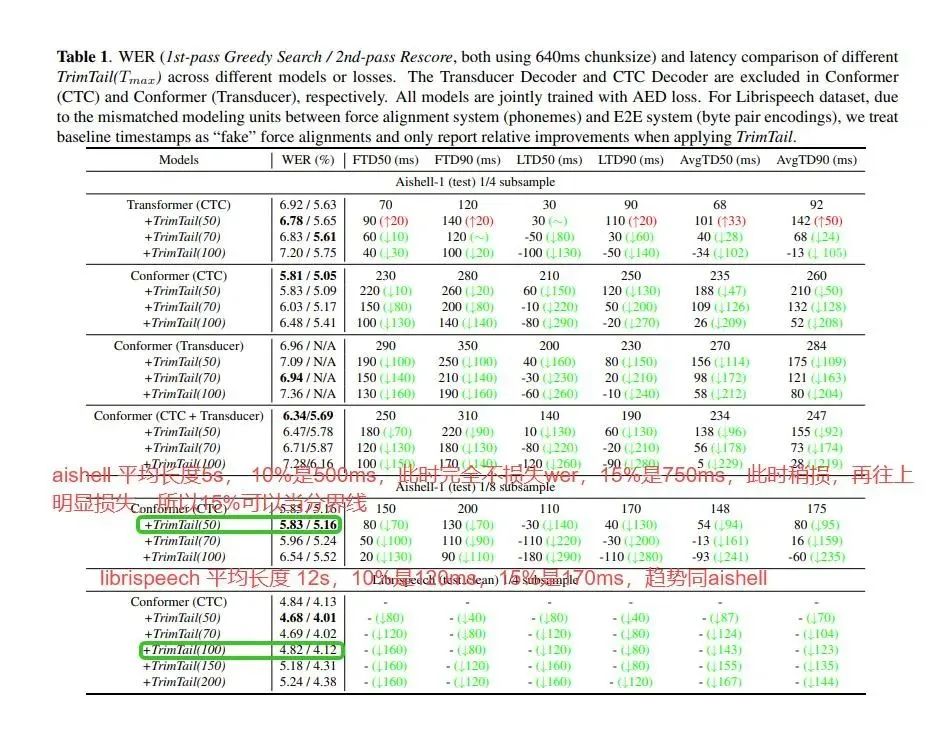
值得注意的是,如果你使用了一个比较合理的 TrimTail 阈值后发现 WER 依然增加明显(体现在 Insertion 插入错误相比不使用 TrimTail 几乎成倍增加),请不要慌张,这不是 TrimTail 的错,而是标注文件本身就错了。举个例子: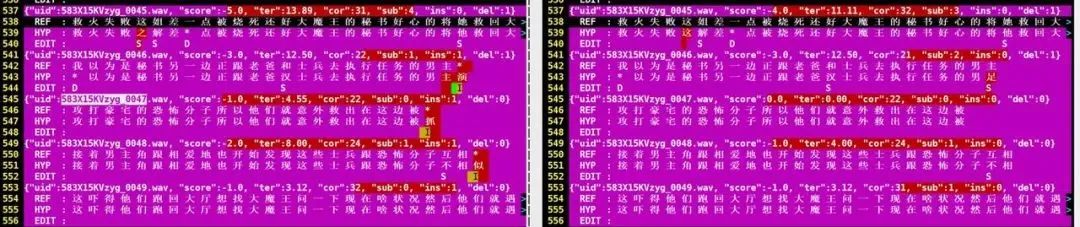
上图中解码结果来自 speechio 某个测试集,由于制作数据时 vad 不太精准,导致剪辑出来的单句音频尾部静音长度很短,模型本身尖峰向后漂移进一步导致最后的字没有出字空间(尖峰飘到了句子静音外面),此时使用TrimTail的模型:
- 训练过程连没有尾部发音的情况都能handle,这种仅仅是缺少尾部静音段的case自然是小菜一碟
从人类的观看体验来看, TrimTail 模型显然是更合理的,但是反映到 WER 却会多出一个 Insertion 。此时, WER 并不是一个很好的度量标准。行文至此,如果读者认为 TrimTail 就只是能做到前移尖峰就大错特错了,在实际应用中,相比前移尖峰,TrimTail 对产品体验的另一个更重要的贡献是 “显著降低了句尾的 EndPoint Latency”。在语音产品中,语音识别往往只是单点入口,一个完整的语音产品/交互链路必然包含后续的NLU意图理解。此时整个系统必须要知道“用户何时说完了当前这句指令”,然后才能将识别结果送至 NLU 。这里的延迟就叫 EndPoint Latency 。通常的做法是尾部出现连续 500ms 静音就认为指令已经说完。在指令不长的情况下,EndPoint Latency 甚至可能超过模型推理时间,显然会极大影响用户体验。如果能缩短这 500ms 的 EndPoint Latency ,对整个交互链路的体验提升将是巨大的。为了验证 TrimTail 对 EndPoint Latency 的理论提升,我们在解码时强制裁掉输入数据的尾部 XXXms,通过下表的 WER 结果可以看出,没有使用 TrimTail 的模型,裁剪 300ms 尾部就会出现明显的 WER 损失,相反, TrimTail 模型在 300ms 裁剪下 WER 是无损的,这就是表明在使用了 TrimTail 后,语音链路中的 500ms EndPoint Latency 可以放心大胆地缩小 300ms 而不用担心会对 WER 造成影响。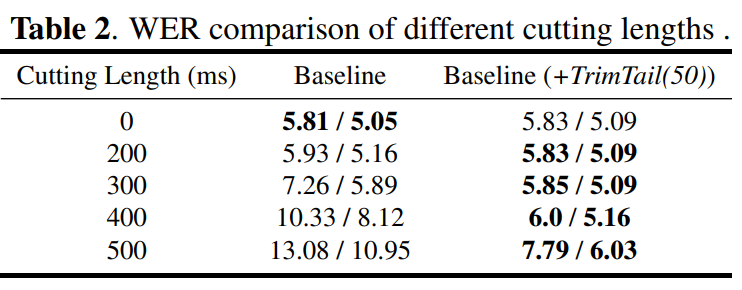
5. 尾记1:简洁与统一
麦克斯韦方程组以一种近乎完美的方式统一了电和磁,将人类的认知从粒子跳脱到电磁波,并预言了光就是电磁波的一种形式;而 TrimTail 则是用一种最简洁最接近问题本质的方式统一了 CTC 和 Transducer 的尖峰漂移,将 ASR 研究的目光从损失函数转移到数据,并开创了一门崭新的数据流派玩法。你问 TrimTail 蕴含了什么东西,让人这么着迷?答:数据。你看到的,你摸到的,你想到的,都是数据,都在深度学习的道里。
6. 尾记2:Max Well, But not Perfect.
当然,这个世界上没有完美的事物,即便是神之方程组,也存在着一定程度的“不对称性(主要是因为磁场没有磁单核)”。TrimTail 同理,但是这种 “数据”视角的思考方式和解决方案,相比 “损失函数”的视角,其可塑性可玩性(简单易实现)、可扩展性(不同的trim玩法)和可结合性(与数据增强结合做到既大幅提点又前移尖峰)的 想象空间无疑是巨大的。WeNet 在此抛砖引玉,期待未来能基于此涌现出一批更优秀的方案,造福整个语音识别领域,彻底吹散那朵晴朗天空中的乌云。
[1]Yu J, Chiu C C, Li B, et al. Fastemit: Low-latency streaming asr with sequence-level emission regularization[C]//ICASSP 2021-2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2021: 6004-6008.[2]Kang W, Yao Z, Kuang F, et al. Delay-penalized transducer for low-latency streaming ASR[J]. arXiv preprint arXiv:2211.00490, 2022.
 语音小管家
