TIOBE场景测试:华语大学生辩论赛

1、素材来源 YouYube爬取,华语大学生辩论世界杯,现场视频,原始时长约2小时 2、场景特点 1)环境 辩论赛现场,室内场馆会场,有观众 有掌声噪声 拾音设备 专业麦克风 麦克风距离说话人约一臂距离,或者手持,近场
184 0 0

1、素材来源 YouYube爬取,华语大学生辩论世界杯,现场视频,原始时长约2小时 2、场景特点 1)环境 辩论赛现场,室内场馆会场,有观众 有掌声噪声 拾音设备 专业麦克风 麦克风距离说话人约一臂距离,或者手持,近场
1、素材来源 YouTube 抓取“张震鬼故事” 往期节目,原始音频约3小时 2、场景特点 1)环境 • 播音间,周围环境安静 • 节日制作实时 & 后期混入各种配乐及恐怖音效 • 噪声非平稳,且音量较大 2)拾音设备 • 专业麦克风,近场…
前沿 本文大家一个完整的中文语音识别系统,包括声学模型和语言模型,能够将输入的音频信号识别为汉子 该系统实现了基于深度框架的语音识别中的声学模型和语言模型建模,其中声学模型包括CNN-CTC、GRU-CTC、CNN-RNN-CTC,语言模型…
语音识别的全程是自动语音识别(Automatic Speech Recognition,ASR),说得多了,就把“自动”省去了,认为“自动”是理所当然的了。语音识别属于序列转换技术,它将语音序列转换为文本序列。大体来说,这是一次搬运,是吧一…
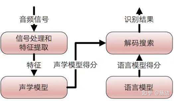
1、概述 声音从本质是一种波,这种波可以作为一种信号来处理,所以语音识别的输入实际上就是一段随时简播放的信号序列而输出则是一段文本序列。将语音片段输入转化为文本输出的过程就是语音识别。 一个完成的语音识别系统通常包括信号处理和特征提取、声学…
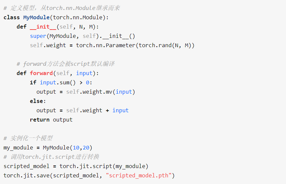
今天我们先看一下通用的模型部署场景,然后讨论一下Libtorch模型转换。 深度学习模型部署 深度学习模型训练完成后,需要将模型部署应用,该部门一般无需再考虑如何修改训练方式或者修改网络结构以提高模型精度,更多的是需要明确部署的场景、部署方…
首先语音识别系统对收集到的目标语音进行预处理,这个过程就已经十分复杂,包含语音信号采样、反混叠带通滤波、去除个体发音差异和设备、环境引起的噪声影响等等。之后对处理的语音进行特征提取。 语音识别的原理其实并不难理解,原理上和指纹识别的原理相同…
端到端语音识别技术,如何更好的落地? 出门问问开源端到端语音识别框架 WeNet GitHub star 数已超 1300 今年2月,中国人工智能公司出门问问联合西北工业大学推出了全球首个面向产品和工业界的端到端语音识别开源工具 —— We…
文章转载请标明出处:微信公众号 低调奋进 个人网站http://yqli.tech/本来整理语音合成相关的文章、数据以及开源工具等等。现在,我对资料进行整理,添加了语音识别模块,在这里分享给大家,节省读者查找资料的时间。接下来,我给大家详细…
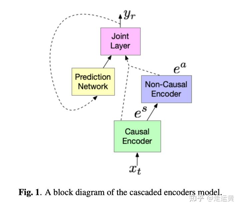
受到 Google 一篇论文CASCADED ENCODERS FOR UNIFYING STREAMING AND NON-STREAMING ASR的启发,准备采用级联编码来改善 Second Pass 的识别效果。 最近也有其他离在线…