阿里开源Qwen-Image,中文最好模型,精准搞定复杂字体排版,硬刚字节OpenAI

来源丨AIGC开放社区 今天,阿里开源了最新文生图模型 Qwen-Image 。 Qwen-Image是一个200亿参数的MMDiT模型,可生成写实、动漫、赛博朋克、科幻、极简、复古、超现实、水墨等几十种类型的图片,支持图片的风格迁移、增删…
14 0 0

来源丨AIGC开放社区 今天,阿里开源了最新文生图模型 Qwen-Image 。 Qwen-Image是一个200亿参数的MMDiT模型,可生成写实、动漫、赛博朋克、科幻、极简、复古、超现实、水墨等几十种类型的图片,支持图片的风格迁移、增删…
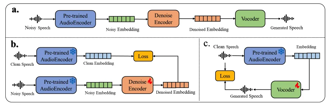
来源丨小米技术 音频理解是构建全场景智能生态的关键领域,在智能座舱、家居交互等场景均有广泛应用。今天小米发布和全量开源了 MiDashengLM-7B 模型。MiDashengLM-7B 基于 Xiaomi Dasheng 作为音频编码器和…
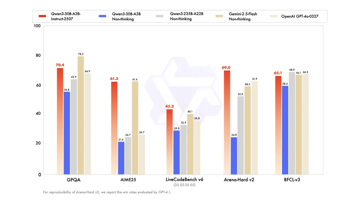
通义千问Qwen团队宣布本周进入“Flash week”,第一弹推出了更新版本的Qwen3-30B-A3B 非思考和思考模式,命名为Qwen3-30B-A3B-Instruct-2507 和 Qwen3-30B-A3B-Thinking-2…
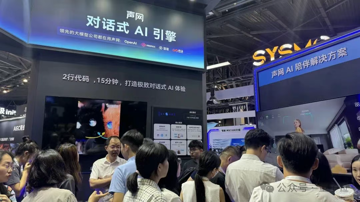
近日,声网在2025世界人工智能大会发布新版对话式 AI 引擎,该版本新增声纹识别、数字人与视觉理解三项功能,实现对话式 AI 音视频交互体验的全新升级。同时,口袋 AI 毛绒宠物—芙崽 Fuzozo、家庭陪伴机器人—赋之 EBO Air…
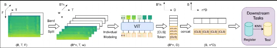
近期,来自清华大学、上海交通大学、北京华控智加科技有限公司和华北电力大学的研究者联合发布首个多模态工业信号基座模型FISHER,采用搭积木的方法对异质工业信号进行统一建模。目前技术报告和权重均已开源,欢迎使用! 论文链接:https://a…
7月23日,夸克健康大模型在业界引起广泛关注:其成功通过了中国12门核心学科的主任医师笔试评测,成为国内首个完成此项专业考核的AI大模型。这一成果不仅凸显了AI在严肃医疗和C端的应用潜力,也引发了行业对其背后技术逻辑与工程实践的深入探讨。…
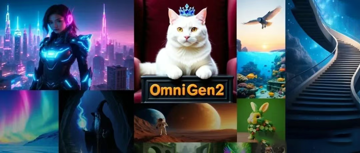
来源丨新智元 智源统一图像生成模型OmniGen2发布后,立刻在AI图像生成领域掀起巨响,多模态技术生态进一步打通。才一周,GitHub星标就已经破了2000,X上的话题浏览数直接破数十万。 刚刚,统一图像生成模型OmniGen2携重大升级…

来源丨AI音频时代 SkyReels-Audio 是 Skywork AI 团队开发的一款创新框架,能够将静态图像或视频与语音输入相结合,生成高度逼真且唇形同步的说话人像视频。 该框架基于预训练的视频扩散变换器构建,支持无限长度的视频生成和…
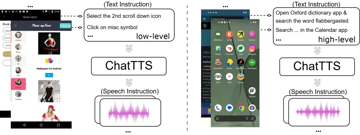
GUIRoboTron-Speech团队 投稿 来源 |量子位 由美团和浙江大学联合推出的GUIRoboTron-Speech——让用户解放双手,直接对计算机“发号施令”。 联系方式:wenkangh@zju.edu.cn 论文链接:htt…
来源丨21db声学人 随着生成模型的快速发展,4D场景生成技术(即动态3D场景生成)在近年来取得了显著进展。4D生成技术能够从任意相机视角生成时空一致的渲染效果,广泛应用于增强现实(AR)、虚拟现实(VR)、机器人技术和自动驾驶等领域。 尽…