
2022年11月15日,由语音之家打造的AI语音技术相关的前沿论文成果分享平台—SH SSS(SH Symposium Series on Speech)第七期成功举办。本期是由牛树同进行论文解读:《 ISSD: 基于迭代式语音分离的说话人日志系统》。
下面是本次论文解读的回顾:
2022年11月15日,由语音之家打造的AI语音技术相关的前沿论文成果分享平台—SH SSS(SH Symposium Series on Speech)第七期成功举办。本期是由牛树同进行论文解读:《 ISSD: 基于迭代式语音分离的说话人日志系统》。
下面是本次论文解读的回顾:
VIDEO POSTER
POSTER
概述 Abstract
本文提出了一种基于迭代式语音分离的说话人日志(Iterative separation-based speaker diarization, ISSD)方法来处理真实的测试数据。在ISSD方法中,我们根据说话人先验迭代地产生自适应数据来提高分离模型的泛化能力,这可以使得模型性能逐步提升。为了进一步减少说话人先验中一些不可避免的检测错误带来的影响,我们利用说话人的声纹信息提出了两种后处理方法,即说话人过滤以及说话人恢复。我们在真实的两人电话语音(Conversational telephone speech, CTS)上对提出的方法进行了测试。实验结果表明,与最先进的基于聚类的说话人日志系统(Clustering-based speaker diarization, CSD)相比,我们提出的方法在开发集和测试集上分别取得了47.72%和46.97%的相对提升。ISSD也是我们在DIHARD III挑战赛冠军系统中应用的一个关键技术。 
研究方法 & 模型介绍 Methods & Data analysis
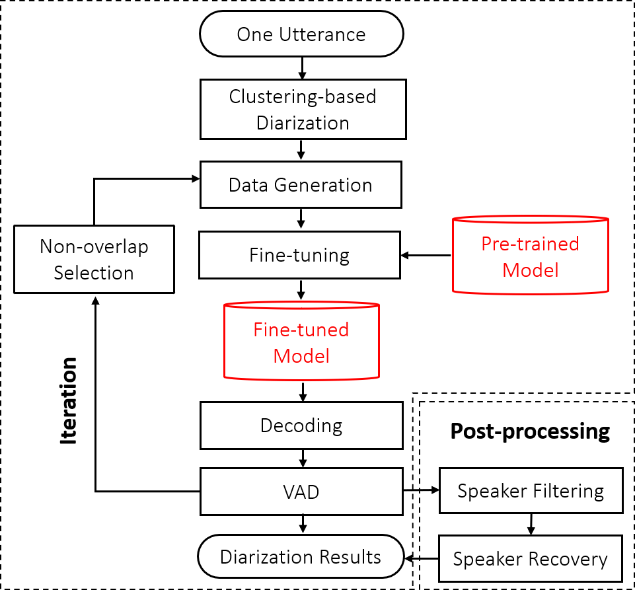
图1 基于迭代式语音分离的说话人日志系统
ISSD的系统框图如图1所示,其主要目标是利用基于聚类的说话人日志系统(CSD)的结果作为先验信息,使分离模型在实际数据上也具有较强的泛化能力。它可以分为三个部分:数据更新部分,模型自适应部分和结果生成部分。首先,我们使用基于聚类的说话人日志结果来生成自适应数据。然后,我们对预训练的分离模型进行微调,使其适应于测试语句。最终,我们使用微调模型生成的结果来更新下一个迭代的自适应数据。通过这个过程,系统可以迭代地改进说话人日志的结果。
此外,由于说话人先验信息存在一定的错误,这会导致仿真的自适应数据中存在一些误导信息。因此,我们利用说话人的声纹信息对ISSD的结果进行了优化,包括两个方法:
说话人过滤(Speaker filtering,SF):由于说话人先验中存在错误信息,这会导致ISSD结果中存在一些虚警误差,如图2中的SPK1所示。针对这种错误,我们采用声纹模型对每个片段提取对应的声纹信息,通过比较片段间的相似性找出异常片段,从而将其进行剔除。 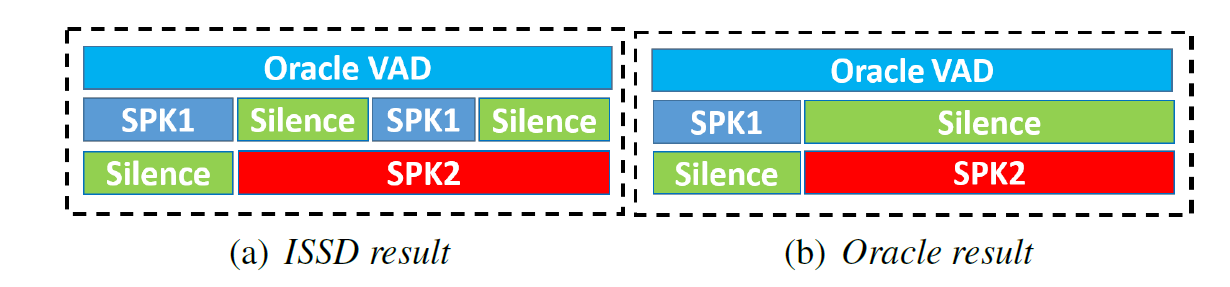
图2 ISSD结果中的残差
说话人恢复(Speaker recovery,SR):ISSD中出现的另一种问题是存在说话人片段的漏检,如下图中SPK2所示,ISSD并未检测出全部的语音片段。对于这种情况,我们利用声纹信息,将最有可能的说话人在对应片段上进行恢复。
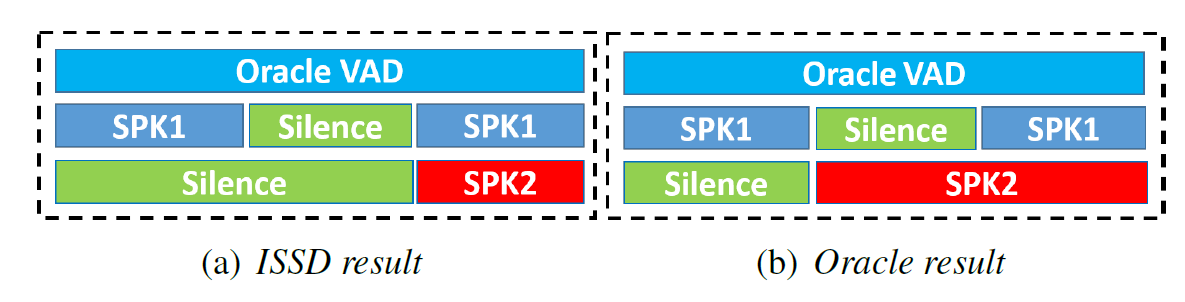
图3 ISSD结果中的漏检错误
实验结果 Results
本文在DIHARD-III挑战赛的开发集和测试集电话数据(CTS)上分别验证了所提出方法的效果。表1比较了不同的说话人日志系统在两人电话数据上的性能,从表中可以看出,在最先进的基于聚类的说话人日志系统CSD上,说话人日志错误率DER主要来自于漏检(miss, MI)项,达到12.0%。这是由于CSD方法无法处理重叠语音段而导致的漏检错误。对于本文提出的ISSD来说,表1中NI和NE分别代表ISSD的迭代次数以及微调训练的epoch数,DL代表Dover-lap融合方法。可以看出,随着迭代次数的增多,ISSD结果的错误率DER逐渐降低,且不同迭代结果之间具有一定的互补性,可以用于融合。
表1 不同的说话人日志系统在DIHARD-III两人电话数据上的性能比较
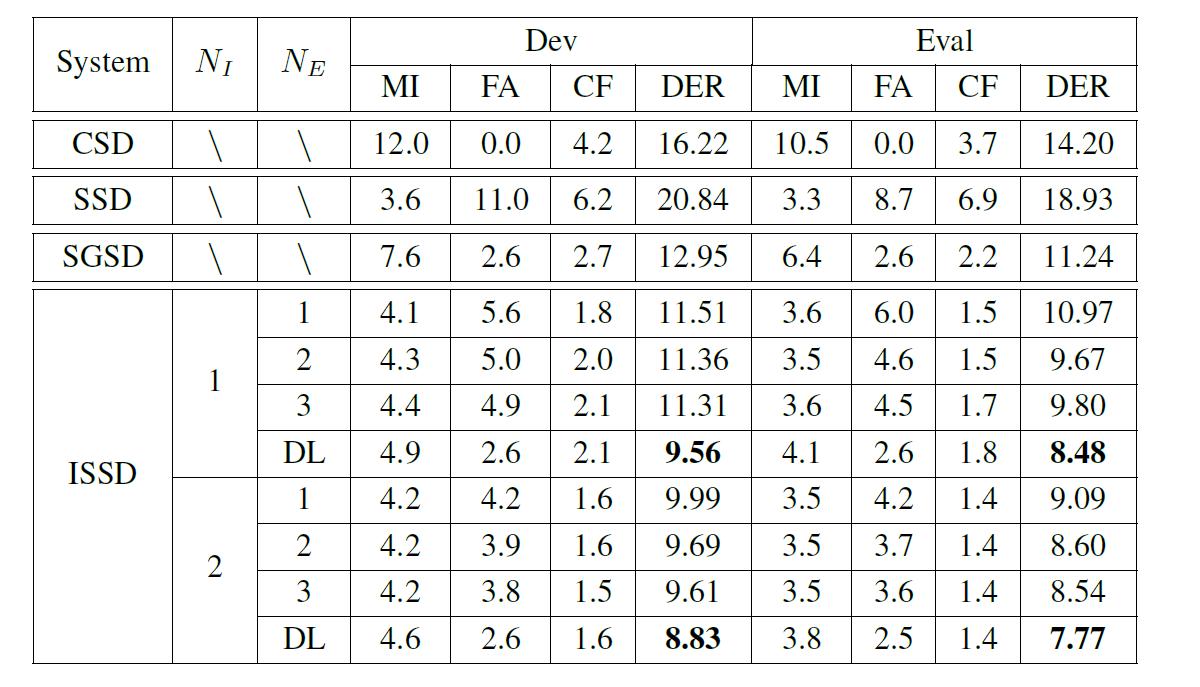
表2 不同的后处理方法在DIHARD-III两人电话数据上的性能比较
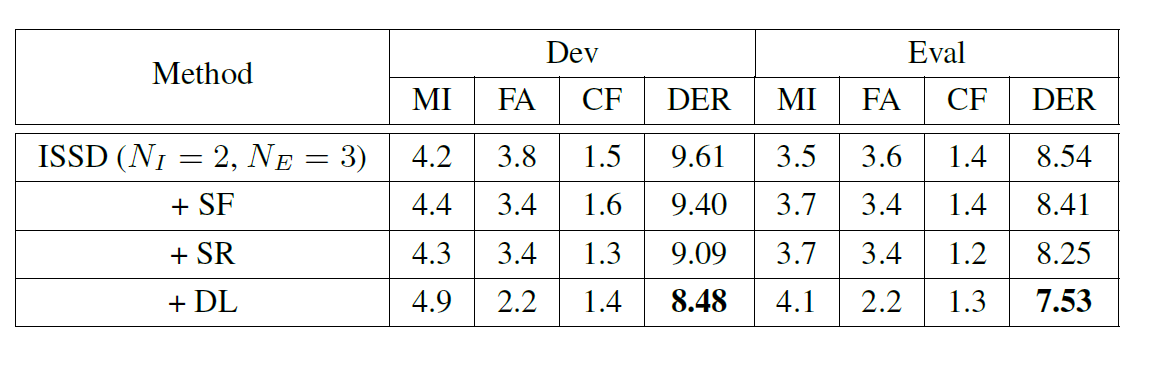
表2比较了不同的后处理方法在DIHARD-III两人电话数据上的性能,可以看出两种基于声纹的后处理方法SF和SR均能够在性能上帮助ISSD获得进一步提升。相比CSD方法,我们最终的系统在开发集和测试集上分别取得了相对47.72%和46.97%的提升。
Abstract
Methods & Data analysis
图2 ISSD结果中的残差
说话人恢复(Speaker recovery,SR):ISSD中出现的另一种问题是存在说话人片段的漏检,如下图中SPK2所示,ISSD并未检测出全部的语音片段。对于这种情况,我们利用声纹信息,将最有可能的说话人在对应片段上进行恢复。
图3 ISSD结果中的漏检错误
Results
本文在DIHARD-III挑战赛的开发集和测试集电话数据(CTS)上分别验证了所提出方法的效果。表1比较了不同的说话人日志系统在两人电话数据上的性能,从表中可以看出,在最先进的基于聚类的说话人日志系统CSD上,说话人日志错误率DER主要来自于漏检(miss, MI)项,达到12.0%。这是由于CSD方法无法处理重叠语音段而导致的漏检错误。对于本文提出的ISSD来说,表1中NI和NE分别代表ISSD的迭代次数以及微调训练的epoch数,DL代表Dover-lap融合方法。可以看出,随着迭代次数的增多,ISSD结果的错误率DER逐渐降低,且不同迭代结果之间具有一定的互补性,可以用于融合。
表2 不同的后处理方法在DIHARD-III两人电话数据上的性能比较
表2比较了不同的后处理方法在DIHARD-III两人电话数据上的性能,可以看出两种基于声纹的后处理方法SF和SR均能够在性能上帮助ISSD获得进一步提升。相比CSD方法,我们最终的系统在开发集和测试集上分别取得了相对47.72%和46.97%的提升。