ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会邀请到昆山杜克大学在3月10日和3月12日分别做两期专场分享,本文介绍第一场相关内容,欢迎大家预约观看。
实验室概况
昆山杜克大学是一所非营利性的中美合作办学机构,由美国杜克大学和中国武汉大学联合在中国江苏省昆山市创办,旨在开创世界一流的研究型综合性大学,为来自中国及全球的学生提供多样化的学术项目。语音及多模态智能信息处理实验室,Speech and Multimodal Intelligent Information Processing (SMIIP) Lab, 隶属于大数据研究中心,PI为李明老师,目前共3个研究方向,分别为智能语音处理、多模态行为信号分析、病理语音分析。
昆山杜克大学(一)【专场】
时间:3月10日(周日)10:00 ~ 11:40
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
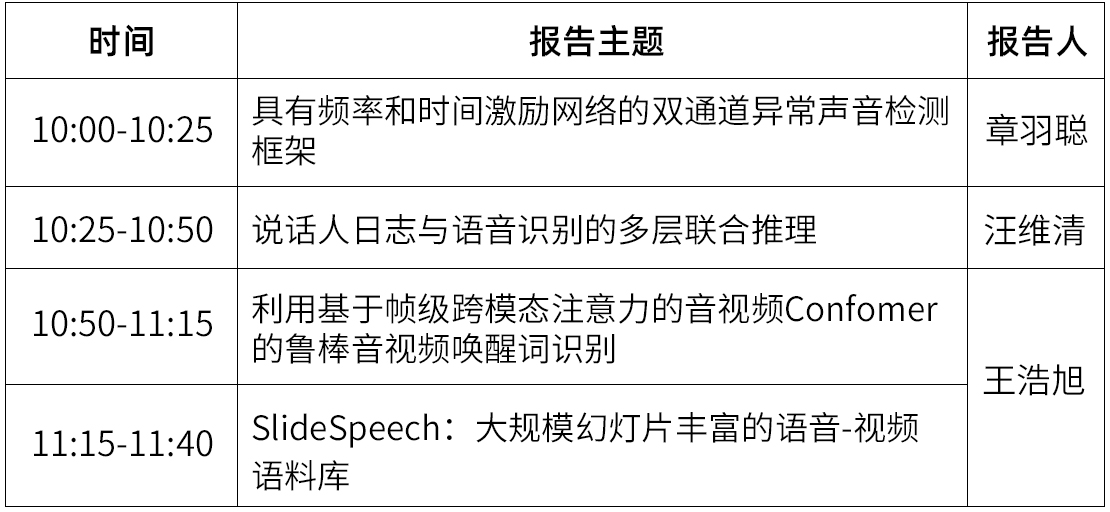
分享主题:具有频率和时间激励网络的双通道异常声音检测框架
摘要:与人类语音相比,同类型的机器生成声音通常表现出一致的频率特征和可辨识的时间周期性。然而,在异常检测中利用这些双重属性仍然相对未被充分探索。本文提出了一种自动化的双通道框架,用于学习不同类型机器的突出频率和时间模式。其中一条路径使用一种新颖的频率和时间激励网络(FTE-Net)来学习频谱图中频率和时间轴上的显著特征。它包括一个频率和时间分块编码器(FTC-Encoder)和一个激励网络。另一条路径使用一维卷积网络进行话语级别的频谱处理。在DCASE 2023任务2数据集上的实验结果显示了我们提出的方法的最新性能。此外,我们提供了激励网络中间特征图的可视化,以说明我们方法的有效性。
摘要:在本文中,我们介绍了一种新颖的方法,将语音识别(ASR)和说话人日志结合在一个统一的框架中。利用两个任务之间的协同作用,我们的方法有效地从预训练的Conformer-based ASR模型的较低层中提取说话人特定信息,同时利用较高层来增强日志性能。这种将ASR的上下文细节整合到日志过程中被证明是非常有效的。DIHARD III数据集的结果表明,我们的方法实现了10.52%的分离错误率(DER),将ASR特征整合到分离模型中后,可以进一步降低到10.39%。这些结果表明我们提出的系统与其他最先进系统相比具有较好的性能。此外,本文提出的框架可以同时为每个说话人生成文本,这进一步增强了ASR输出的效果,并且今后可以将其拓展到一个包括ASR和说话人日志的端到端多任务框架。
论文链接:https://sites.duke.edu/dkusmiip/files/2024/03/icassp24_weiqing.pdf
嘉宾简介:王浩旭,武汉大学计算机学院三年级硕士生,昆山杜克大学语音及多模态智能信息处理实验室研究实习生,研究方向为语音识别,语音唤醒,多模态语音唤醒/识别。已在领域内重要会议以第一作者身份发表论文4篇,其中ICASSP论文3篇,于ICASSP 2022的语音信号处理挑战赛(MISP Challenge)取得赛道一音视频唤醒亚军的成绩。
分享主题1:利用基于帧级跨模态注意力的音视频Confomer的鲁棒音视频唤醒词识别
摘要:近年来,基于神经网络的唤醒词发现在干净的音频样本上取得了良好的性能,但在嘈杂的环境中却性能下降。音视频唤醒词识别(AVWWS)受到了很多关注,因为视觉嘴唇运动信息不受复杂声学场景的影响。以前的方法通常使用简单的加法或连接进行多模态融合。模态间相关性仍然相对未得到充分探索。在本文中,我们提出了一个名为帧级跨模态注意(Frame-Level Cross-Modal Attention, FLCMA)的新模块,以提高AVWWS系统的性能。该模块可以通过同步的嘴唇运动和语音信号来帮助在帧级对多模态信息进行建模。我们训练基于端到端FLCMA的Conformer,并通过微调预训练单模态模型来进一步提高AVWWS任务的性能。所提出的系统在远场MISP数据集上实现了新的最先进的结果(2.02%的错误拒绝率和2.55%的错误报警率及4.57%的WWS分数)。
论文链接:https://sites.duke.edu/dkusmiip/files/2024/03/icassp24_haoxu_wws.pdf
分享主题2:SlideSpeech:大规模幻灯片丰富的语音-视频语料库
摘要:多模态自动语音识别(Automatic Speech Recognition,ASR)技术旨在利用更多模态来提高语音识别系统的性能。虽然现有一些多模态方法主要关注视频或上下文信息,但却忽视了对额外补充文本信息的利用。在线会议视频中包含大量幻灯片,这些幻灯片以文本和图像的形式提供了丰富的特定领域信息,有鉴于此,我们发布了 SlideSpeech,这是一个富有幻灯片的大规模音视频多模态语料库。该语料库包含 1,705 个视频,1,000 多个小时,以及 473 个小时的高质量自动生成的语音转录抄本。同时该语料库还包含大量实时同步幻灯片。在这项工作中,我们介绍了构建语料库的流水线,并提出了在可视上下文幻灯片中利用文本信息的基准方法。通过在基准系统中应用关键词提取和上下文自动语音识别(Contextual ASR)方法,我们展示了通过整合补充视频幻灯片中的文本信息来提高语音识别性能的潜力。
数据库开源地址:https://slidespeech.github.io/
直播将通过语音之家微信视频号进行直播
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信