ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会第十四期邀请到4位嘉宾,共报告分享6篇论文,欢迎大家观看。
第十四期
北京工业大学信息学部语音与音频信息处理研究所 & 清华大学多媒体信号与智能信息处理实验室 & 天津大学天津市认知计算与应用重点实验室
时间:3月22日(周五)19:00 ~ 21:30
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
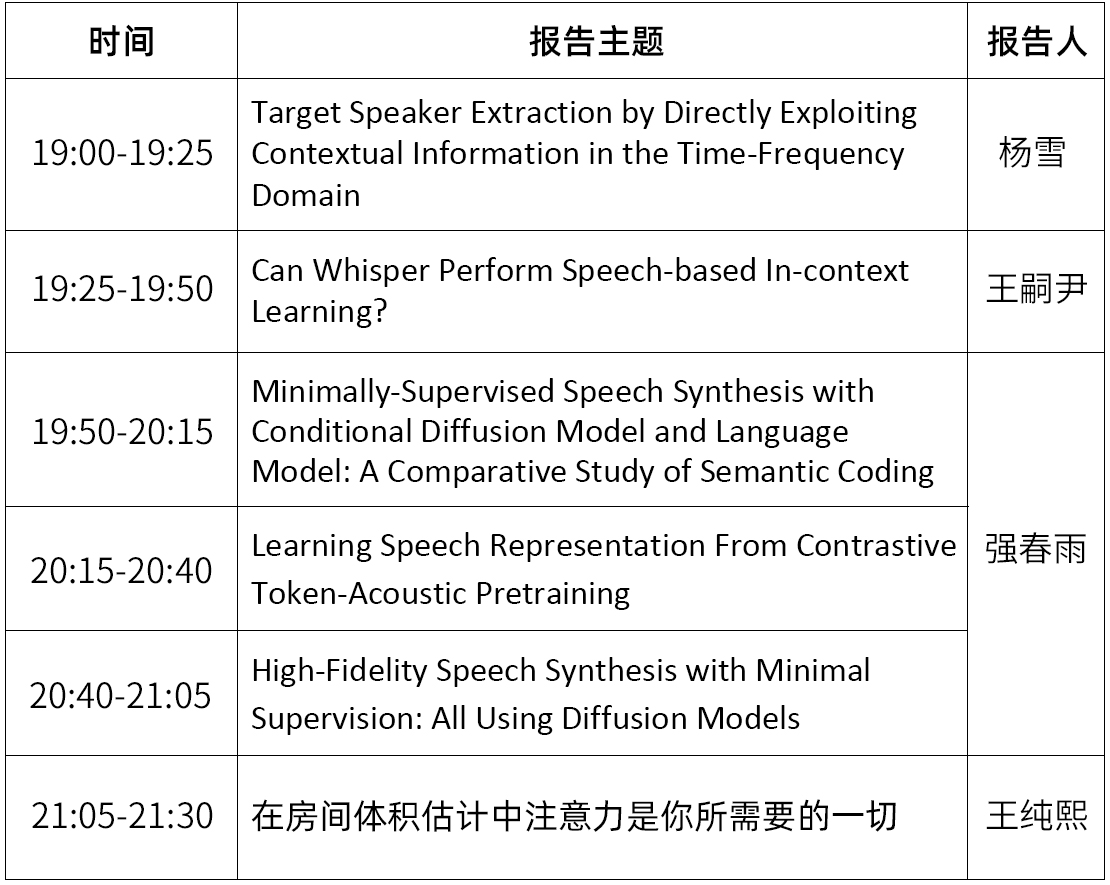
嘉宾&主题
嘉宾简介:杨雪,北京工业大学信息学部语音与音频信息处理研究所二年级博士研究生,主要研究方向为语音分离、目标说话人提取。合作文章发表于ICASSP、Interspeech、Speech Communication等语音领域会议与期刊。分享主题:Target Speaker Extraction by Directly Exploiting Contextual Information in the Time-Frequency Domain
摘要:现有的目标说话人提取(Target Speaker Extraction, TSE)方法通常以目标说话人的嵌入(Embedding)作为指导,从混合信号中提取目标说话人的语音。然而,这些方法往往无法充分利用目标说话人注册语音中的上下文信息。为解决这一问题,我们提出了一种新的TSE方法,该方法可以直接在时频域内利用注册语音的上下文信息。具体而言,我们设计了一个交互模块,通过注意力机制使注册语音与混合信号的时频表示进行交互,进而生成一个与混合信号语谱模式一致且在一定程度上保留目标说话人特征的一致时频表示。以该一致时频表示作为指导,所提TSE方法可以更有效地利用注册语音中的上下文信息,并在基准数据集上取得了出色的性能。
嘉宾简介:王嗣尹,清华大学多媒体信号与智能信息处理实验室2023级博士研究生,导师张超教授,研究方向为语音模态的上下文学习。分享主题:Can Whisper Perform Speech-based In-context Learning?摘要:在这篇工作中,我们研究了OpenAI的语音模型Whisper的上下文学习(In-context Learning)能力。我们提出了一种可在测试时使用的适应方法——基于语音的上下文学习(Speech-based In-context Learning)。这一方法无需梯度下降,仅需几个标注好的语音样本即可使用。我们将这一方法应用到了汉语方言的孤立词识别上,在两种方言、四种大小的Whisper模型上获得了平均32.3%的字错误率(CER)下降。使用基于k-最近邻(kNN)的上下文样本选择算法,可以进一步获得36.4%的字错误率下降。同时我们也在连续语音上验证了我们方法的有效性。详细的定量实验也表明了基于语音的上下文学习可以帮助语音识别模型学习到特定方言词汇和音位变化。嘉宾简介:强春雨,快手科技有限公司语音算法工程师,天津大学天津市认知计算与应用重点实验室博士生,中科院自动化所模式识别国家重点实验室硕士毕业生,研究方向为语音合成。分享主题1:Minimally-Supervised Speech Synthesis with Conditional Diffusion Model and Language Model: A Comparative Study of Semantic Coding
摘要1:现有小监督语音合成方法存在三个问题:离散语音表征的高频波形失真、非自回归框架中的韵律平均,以及现有语义编码方法的信息冗余和维度爆炸。针对这些问题,我们提出了三种演进式方案。首先,我们提出了基于LM和Diffuison的自回归结构 Diff-LM-Speech,实现了更高的音频质量。我们还引入了基于VAE和Prosody Bottleneck的Prompt Encoder,以提高表征能力。其次,在其基础上提出了非自回归结构Tetra-Diff-Speech,以实现多样化的韵律表达。最后,我们提出了 Tri-Diff-Speech,它验证了现有语义编码模型的非必要性。
分享主题2:Learning Speech Representation From Contrastive Token-Acoustic Pretraining
摘要2:对于语音的细粒度生成和识别任务,如小监督语音合成(TTS)、语音转换(VC)和语音识别(ASR),从语音中提取的中间表征应作为文本和声学信息之间的 "桥梁",包含两种模态的信息。语义内容突出,而诸如说话人身份和声音细节等副语言信息则应淡化。在报告1的工作中验证了,从语音中提取细粒度中间表征的现有方法存在信息冗余和维度爆炸的问题。对比学习广泛应用于计算机视觉领域进行表征学习。然而,音频领域现有的对比学习方法侧重于为下游音频分类任务提取全局描述性信息,不适合 TTS、VC 和 ASR 任务。为了解决这些问题,我们提出了一种名为 "Contrastive Token-Acoustic Pretraining (CTAP)" 的语义表征学习方法,该方法使用两个编码器将音素和语音引入联合多模态空间,学习如何在帧级别连接音素和语音。所提出的 CTAP 方法为语音处理中的细粒度生成和识别下游任务提供了一种全新的解决方案。分享主题3:High-Fidelity Speech Synthesis with Minimal Supervision: All Using Diffusion Models摘要3:小监督语音合成将两类离散语音表征(语义和声学)结合在一起,并使用两个序列到序列任务,从而将 TTS 解耦,实现小监督下的训练。在报告1的工作中验证了,现有方法在语义表征方面存在信息冗余和维度爆炸问题,在离散声学表征方面存在高频波形失真问题。自回归框架表现出典型的不稳定性和不可控性问题。而非自回归框架则由于时长预测模型导致韵律平均化。为了解决这些问题,我们提出了一种小监督高保真语音合成方法,其中所有模块都是基于Diffusion模型构建的。非自回归框架增强了可控性,时长扩散模型实现了多样化的韵律表达。CTAP被用作中间语义表征,以解决现有语义编码方法中的信息冗余和维度爆炸问题。Mel用作声学表征,语义表征和声学表征都通过连续变量回归任务进行预测,以解决高频细粒度波形失真的问题。嘉宾简介:王纯熙,北京工业大学电子科学与技术专业二年级研究生,主要研究方向为语音分离、房间参数估计等。摘要:近年来,声学环境动态参数化在音频处理领域引起了越来越多的关注。在独立于源和接收器方向性的情况下,用于表征局部房间声学的关键参数之一是几何房间体积。卷积神经网络(CNNs)已被广泛选择为进行盲目房间声学参数估计的主要模型,其目标是学习从音频频谱图到相应标签的直接映射。随着自注意机制的最新趋势,本文介绍了一种纯注意力模型,用于基于单声道噪声语音信号盲室房间参数体积。我们证明了在这项任务中消除对CNNs的依赖的可行性,并且提出的Transformer架构将Gammatone幅度谱系数和相位频谱图作为输入。为了增强模型在特定任务数据集上的性能,还应用了跨模态迁移学习。实验结果表明,提出的模型在广泛范围的真实世界声学空间中优于传统的CNN模型,尤其在专门的预训练和数据增强方案的帮助下。
参与方式
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群
ICASSP 2024 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。

为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信