ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。

ICASSP 2024 论文预讲会第十五期邀请到罗切斯特大学AIR Lab做本次会议的专场分享,欢迎大家观看。


实验室概况

罗切斯特大学音频信息实验室(Audio Information Research Lab, AIR),由段志尧教授带领,我们的研究兴趣主要集中在计算机听觉这一新兴领域,这一领域致力于设计智能算法和系统,使之能够理解包括音乐、语音和环境声音在内的声音。这是一个跨学科领域,融合了信号处理、机器学习、心理声学、音乐理论等多个领域的知识。我们解决的基本问题包括解析多声部听觉场景(鸡尾酒会效应),以及设计新颖的应用,如声音检索和音乐信息检索。我们还将声音分析与文本和视频等其他信号模态的分析结合起来,进行多模态场景分析。我们一直在研究的各种项目包括音频源分离、自动音乐转录、音频-乐谱对齐、语音增强、语音日志记录和情绪识别、声音检索、声音事件检测和音频视觉场景理解。
实验室官网:https://labsites.rochester.edu/air/


第十五期

罗切斯特大学AIR Lab【专场】

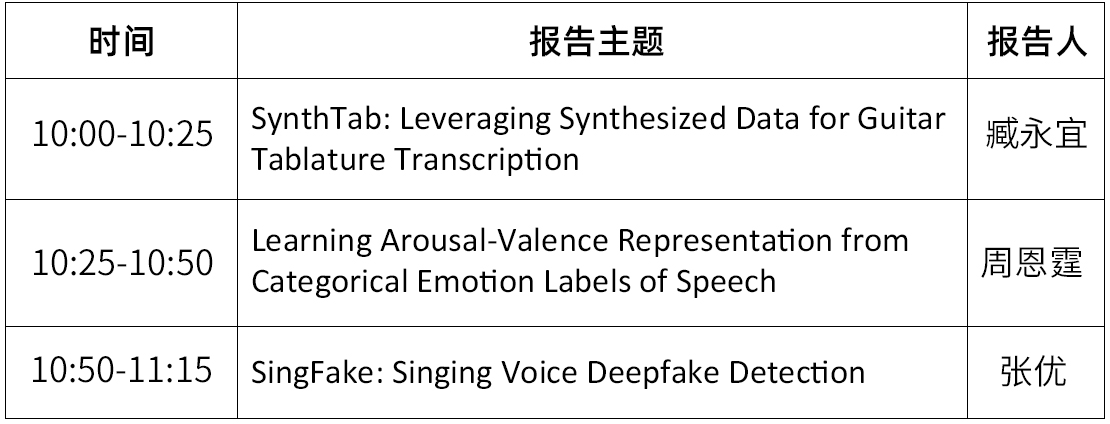
时间:3月23日(周六)10:00 ~ 11:15

形式:线上

议程:每位嘉宾分享25分钟(含5分钟QA)


嘉宾&主题

嘉宾简介:臧永宜,罗切斯特大学 (University of Rochester) 音频工程专业本科毕业生,现在 Neosensory 担任机器学习工程师。臧永宜的研究兴趣在于音频信号相关的应用机器学习领域,包括多模态和空间音频,合成歌声和语音识别,及音乐信息检索方向。同时,他的工作方向主要在于轻量化的音频识别模型的开发、对大模型的压缩及端侧部署。他的研究成果已在 ICASSP, INTERSPEECH, AES, JAES 等国际知名会议或期刊上发表。他同时是一名编曲/音乐制作人。

分享主题:SynthTab: Leveraging Synthesized Data for Guitar Tablature Transcription
摘要:吉他谱是一种广泛使用的乐谱记谱形式,它不止记录下了音符内容,还包括了其具体的演奏弦位和演奏法。因此,吉他谱转录(GTT)是一个具有广泛应用的重要任务,在音乐教育、作曲和文化方面都有其价值。但是,现有的GTT数据集在规模和范围上相当有限,导致在这些数据集上训练的模型容易过拟合,无法泛化到领域外的数据。为了解决这个问题,我们提出了一种利用商业电吉他音源合成大规模GTT音频的方法。我们提供 SynthTab;它来自于 DaDaGP,一个庞大且多样化的,包含丰富演奏法的吉他谱集合。我们提出的合成管线忠实地遵循了原始吉他谱的指法中指定的一部分技巧,并涵盖了多种吉他和曲风。实验显示,在 SynthTab 上预训练基础GTT模型,再对单个数据集进行微调,可以在测试时显著提高转录性能。跨数据集实验表明,在 SynthTab 上的预训练显著减轻了过拟合问题。


嘉宾简介:周恩霆,加州大学圣地亚哥分校(University of California, San Diego)电气与计算机工程系的在读硕士,本科毕业于罗切斯特大学(University of Rochester)计算机专业。他的研究兴趣在应用机器学习,特别是自然语言处理和语音处理方面。他的研究成果在ICASSP,IEEE Big Data上发表。他还通过在亚马逊公司的实习,继续探索机器学习在工业级的大规模应用和部署。
分享主题:Learning Arousal-Valence Representation from Categorical Emotion Labels of Speech
摘要:情绪的维度表示,如激活-价值(AV)表示,提供了一个连续和细粒度的描述和控制,比它们的类别对应物更为精细。它们在动态情绪理解和表达性文本到语音合成等任务中有广泛应用。现有的从语音预测维度情绪表示的方法将其视为一个监督回归任务。这些方法面临数据稀缺问题,因为维度注释比类别标签更难获得。在这项工作中,我们提出从语音的类别情绪标签学习AV表示。我们首先通过自监督预训练和情绪分类微调学习一个丰富且与情绪相关的高维语音特征表示。然后,根据心理学发现,通过锚定的降维将此表示映射到2D AV空间。实验表明,我们的方法在IEMOCAP上达到了与最先进的监督回归方法相当的一致性相关系数(CCC)性能,而在训练过程中不利用真实的AV注释。这验证了我们提出的AV预测方法。此外,对MEAD和EmoDB数据集上的AV预测进行可视化显示了学习到的AV表示的可解释性。

嘉宾简介:张优,罗切斯特大学(University of Rochester)电气与计算机工程系的在读博士生。张优的研究兴趣在应用机器学习,特别是语音与音频处理方面。他的研究课题涵盖音频鉴伪、空间音频和音视频多模态分析等。他的研究成果已在ICASSP、Interspeech、WASPAA、SPL、TMM等国际知名会议及期刊上发表。张优在ICASSP2023的信号处理新星计划中获得表彰,并获得国家司法研究所(National Institute of Justice)的研究生奖学金。他还通过在字节跳动、腾讯和微软等公司的实习,将他的研究成果成功应用于实际问题。

个人网站:https://yzyouzhang.com

分享主题:SingFake: Singing Voice Deepfake Detection
摘要:合成歌声的兴起对艺术家和行业利益相关者提出了关于未经授权使用声音的重大挑战。不同于合成语音,合成歌声通常发布在包含强烈背景音乐的歌曲中,这种背景音乐可能隐藏了合成的痕迹。此外,歌声与语音表达在声学和语言特性上存在差异。这些特性使得歌声深度伪造检测成为一个相关但与合成语音检测有着显著差异的问题。本研究提出了歌声深度伪造检测任务,并首次介绍了 SingFake,这是一个包含 28.93 小时真实和 29.40 小时深度伪造歌曲片段的在野数据集,涵盖五种语言和 40 位歌手。我们为数据集提供了训练/验证/测试分割,测试集包含多种情境。利用 SingFake,我们评估了四种基于语音表达训练的最先进的对抗系统,发现这些系统在歌声数据上的性能明显不足。当使用 SingFake 训练,无论是分离的人声轨还是混合歌曲,系统性能均显著提高。然而,我们的评估也揭示了未知歌手、通信编解码器、语言和音乐背景等方面的挑战,表明需要专门研究歌声深度伪造检测。SingFake 数据集及相关资源已通过https:www.singfake.org提供。


参与方式

直播将通过语音之家微信视频号进行直播

手机端、PC端可同步观看
👇👇👇


讨论群


扫码添加语音小管家,进入语音之家讨论群


预讲论文征集
ICASSP 2024 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。


为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。


预讲论文报名方式

联系人邮箱

bd@speechhome.com


联系人微信