ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会第十六期邀请到香港中文大学(深圳)做本次会议的专场分享,欢迎大家观看。
第十六期
香港中文大学(深圳)【专场】
时间:3月25日(周一)19:00 ~ 21:05
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
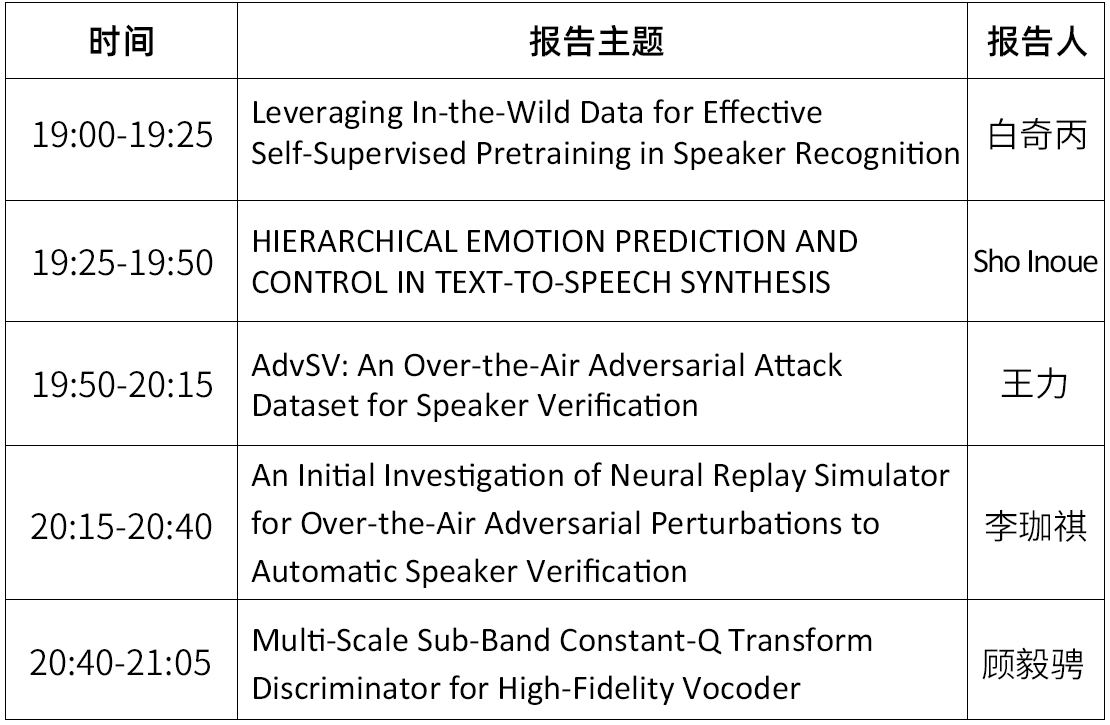
嘉宾&主题
分享主题:Leveraging In-the-Wild Data for Effective Self-Supervised Pretraining in Speaker Recognition
嘉宾简介:My name is Sho Inoue. I’m a second year phd student supervised by Professor Li Haizhou. My research topic is text-to-speech model.
摘要:It remains a challenge to effectively control the emotion rendering in text-to-speech (TTS) synthesis. Prior studies have primarily focused on learning a global prosodic representation at the utterance level, which strongly correlates with linguistic prosody. Our goal is to construct a hierarchical emotion distribution (ED) that effectively encapsulates intensity variations of emotions at various levels of granularity, encompassing phonemes, words, and utterances. During TTS training, the hierarchical ED is extracted from the ground-truth audio and guides the predictor to establish a connection between emotional and linguistic prosody. At run-time inference, the TTS model generates emotional speech and, at the same time, provides quantitative control of emotion over the speech constituents. Both objective and subjective evaluations validate the effectiveness of the proposed framework in terms of emotion prediction and control.
摘要:基于生成对抗网络(GAN)的声码器在从声学表示中重建可听波形方面具有优越的推理速度和合成质量。本研究着重于改进判别器部分以促进基于GAN的声码器的合成质量。现有的基于时频域表征的判别器大多数根植于短时傅里叶变换(STFT),STFT频谱图中的时频域分辨率是固定的,这使其与需要对不同频段施加灵活注意力的信号(如歌声)不兼容。受此启发,我们的研究利用了常数Q变换(CQT),它在频谱上具有动态的时频域分辨率,有助于更好地提升音高建模的准确性和高频谐波的跟踪能力。具体而言,我们提出了一种多尺度子带CQT(MS-SB-CQT)判别器,它在多个尺度上对CQT频谱图进行操作,并根据不同的八度进行子带处理。在语音和歌声上进行的实验证实了我们提出的方法的有效性。此外,我们还验证了基于CQT和基于STFT的判别器在联合训练下可以做到信息的相互补充,从而进一步提升合成效果。具体而言,通过提出的MS-SB-CQT和现有的MS-STFT判别器的增强,HiFi-GAN的MOS评分可以从3.27提升到3.87(对于集内歌手)和从3.40提升到3.78(对于集外歌手)。
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群

为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信