ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会邀请到清华大学深圳国际研究生院在3月26日和3月27日分别做两期专场分享,本文介绍第二场相关内容,欢迎大家预约观看。
第十八期
清华大学深圳国际研究生院(二)【专场】
时间:3月27日(周三)19:00 ~ 20:40
形式:线上
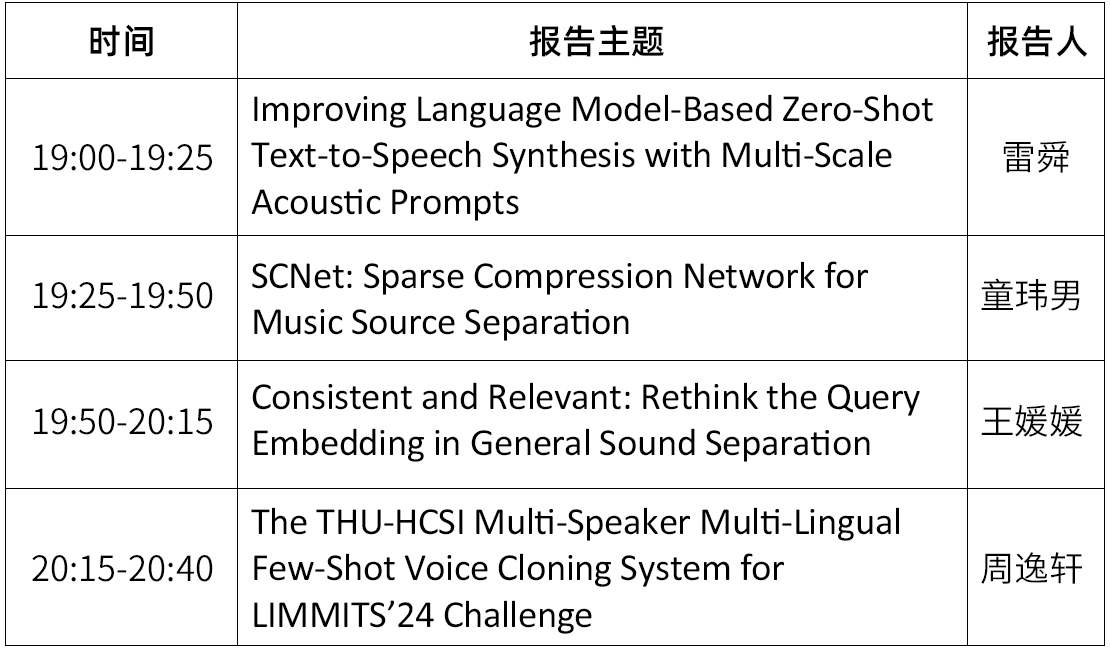
议程:每位嘉宾分享25分钟(含5分钟QA)
嘉宾&主题
嘉宾简介:雷舜,清华大学人机语音交互实验室三年级硕士研究生,主要研究方向包括语音合成、音乐生成、歌唱合成、舞蹈生成等多个方向,已在TASLP、ICASSP、INTERSPEECH等语音顶级期刊或会议发表一作论文多篇,目前主要关注于语音大模型和音乐大模型的研究。
分享主题:Improving Language Model-Based Zero-Shot Text-to-Speech Synthesis with Multi-Scale Acoustic Prompts
摘要:基于语言模型的语音合成系统(如VALL-E)在最近展现出了强大的零样本音色克隆能力,只需要任意说话人3秒的语音作为声学提示就能实现音色克隆。但这些工作受限于声学提示长度的限制,很难克隆个性化的说话风格。本文针对该问题提出了一种利用多尺度声学提示同时捕捉目标说话人的音色和个性化说话风格的方案。我们的模型包含一个说话人感知的文本编码器和一个声学解码器,前者利用参考注意力模块从由多个句子组成的风格提示中学习个性化说话风格,后者则利用语言模型从音色提示中学习音色。实验结果表明,我们提出的方法生成的语音具有更好的自然度和说话人相似度,并且可以通过扩展风格提示的长度获得更好的性能。
摘要: 基于深度学习的方法在音乐源分离技术上取得了显著进展。尽管如此,在处理超宽带音乐源分离时,要实现优异的分离效果并同时保持模型的低复杂性依然具有挑战性。以往的研究要么未能充分考虑不同子带间的差异,要么在生成子带特征时未能有效解决信息损失问题。本文提出了一种新的频域网络SCNet,它显式地将混合音频的频谱分解为数个子带,并引入一种基于稀疏性原理的编码器来处理不同的频带。我们对信息量较少的子带使用更高的压缩比,以此提高信息密度,并集中处理信息量更丰富的子带。通过这种方法,我们能够在较低的计算成本下显著提升分离性能。实验结果显示,该模型在不依赖额外数据的情况下,在MUSDB18-HQ数据集上达到了9.0分贝的信号失真比(SDR),超越了当前最先进的方法。同时,SCNet在CPU上的推理时间仅为之前最先进方法HT Demucs的48%。
嘉宾简介:王媛媛,清华大学人机语音交互实验室三年级硕士研究生,主要研究方向包括说话人识别,音频分离等,相关工作发表于ICASSP。
摘要:基于查询的音频分离通常使用特定的查询特征从混合音频信号中提取目标源。目前,大多数基于查询的分离模型需要额外的网络来获得查询特征,并根据这些查询特征进行分离任务的训练。然而,由于结构和信息的不一致,查询特征可能与分离模型不匹配。在本文中,我们从查询特征的角度出发,提出了一个一致且相关的特征网络 CaRE-SEP,用于通用声音分离。我们从两个方面缓解了查询和分离之间的不匹配问题,包括共享网络结构和共享特征信息。首先,我们使用一个具有共享编码器的模型,将查询特征编码器和分离编码器整合到一个模型中,消除了网络架构差异,有利于生成一致的特征分布;其次,通过使用预训练的分类网络初始化编码器并动态训练,进一步缓解了特征不匹配问题。实验结果表明,所提出的模型显著提高了分离任务的性能,可视化分析也验证了不匹配问题的存在以及我们提出模型的有效性。
嘉宾简介:周逸轩,清华大学深圳国际研究生院计算机科学与技术专业2023级博士研究生。研究方向包括个性化及表现力语音合成、篇章语音生成等,曾在ICASSP、INTERSPEECH、TASLP等语音领域会议和期刊上发表论文多篇,目前主要关注语音生成大模型的研究。
摘要:本报告展示了清华大学人机语音交互实验室(THU-HCSI)团队提交到多说话人、多语言音色克隆语音合成比赛LIMMITS'24的参赛系统。该比赛是ICASSP 2024 系列挑战赛之一,关注英语和多个不同印度语的少数据量的跨语言音色克隆与生成。我们提交的系统基于端到端的语音合成架构YourTTS,融入了VITS-2的相关改进模块以提升说话人相似度和语音质量;此外,为提升少数据量说话人(5 min)在跨语言场景下的稳定性和克隆效果,也尝试了一些训练策略和流程优化。该系统在LIMMIT‘24挑战赛的Track-1赛道的官方评测中取得了最好的说话人相似度(MOS 4.25)和较优的语音自然度(MOS 3.97),展现出该系统在有限训练语料下良好的跨语言音色克隆能力。本报告将主要从工程实现角度出发,分享该参赛系统的数据处理流程、模型结构设计、训练微调策略和实验探究思路。
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信