ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会第二十期邀请到内蒙古大学语音信号处理组做本次会议的专场分享,欢迎大家观看。
实验室概况
第二十期
内蒙古大学语音信号处理组【专场】
时间:3月30日(周六)14:00 ~ 16:05
形式:线上
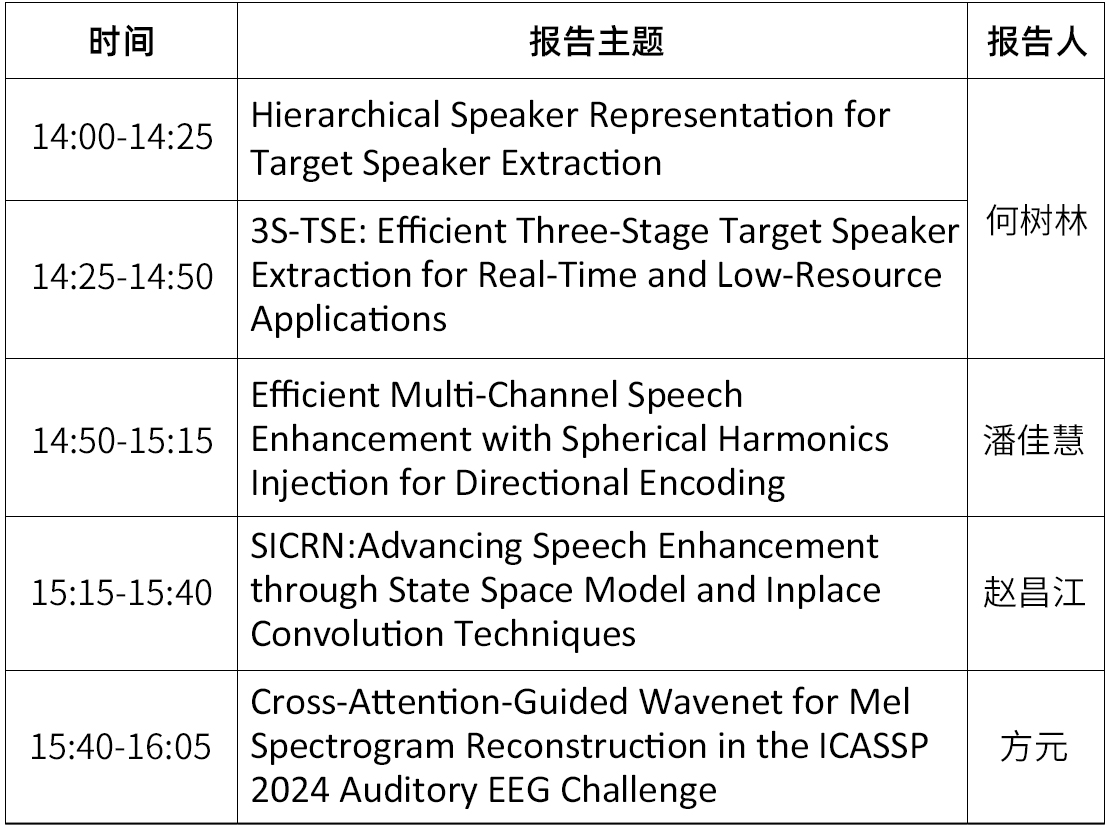
议程:每位嘉宾分享25分钟(含5分钟QA)
嘉宾&主题
嘉宾简介:何树林,内蒙古大学语音信号处理组 博士三年级 导师张学良教授 主要研究方向:目标说话人提取,语音增强。
分享主题1:Hierarchical Speaker Representation for Target Speaker Extraction
摘要1:目标说话人提取的目的是在注册语音或称为锚点语音的指导下,从多个声源的组合中分离出特定说话人的声音。当前的方法主要从锚点语音导出说话人嵌入并将其集成到分离网络中以分离目标说话人的语音。然而,说话人嵌入的表示过于简单,通常只是一个 1×1024 的向量。这种密集的信息使得分离网络难以有效利用。为了解决这一问题,我们引入了一种称为分层表示(HR)的开创性方法,该方法可以跨分离网络的细粒层和总体层无缝融合锚数据,从而提高目标提取的精度。HR 增强了锚点语音的功效,以改善目标说话者的隔离度。在 Libri-2talker 数据集上,HR 大大优于最先进的时频域技术。我们在著名的 ICASSP 2023 深度噪声抑制挑战赛中获得第一名,进一步展示了 HR 的能力。所提出的 HR 方法显示出通过增强锚点语音利用率来推进目标说话人提取的巨大前景。
分享主题2:3S-TSE: Efficient Three-Stage Target Speaker Extraction for Real-Time and Low-Resource Applications
摘要2:目标说话人提取(TSE)旨在根据注册样本从多个混合说话人中分离出特定的声音。由于声纹特征通常变化很大,当前的端到端神经网络需要大量的模型参数,庞大的计算复杂度对于实时应用来说是不切实际的,特别是在资源受限的平台上。在本文中,我们使用麦克风阵列解决 TSE 任务,并引入一种新颖的三阶段解决方案,系统地解耦该过程,降低任务难度:首先,训练神经网络来估计目标说话者的方向。第二步,确定方向后,使用广义旁瓣消除器(GSC)提取目标语音。第三,就地卷积循环神经网络 (ICRN) 充当去噪后处理器,改进 GSC 输出以产生最终的分离语音。我们的方法提供了卓越的性能,同时大大减少了计算负载,为高效的实时目标说话人提取树立了新标准。
嘉宾简介:潘佳慧,内蒙古大学语音信号处理组,博士三年级,导师张学良教授,研究方向为多通道语音增强、语音伪造检测。
摘要:多通道语音增强使用多个捕获空间线索的麦克风来提取语音。有效利用方向信息是多通道增强的关键。深度学习在多通道语音增强方面显示出巨大的潜力,并且通常直接采用短时傅立叶变换(STFT)作为输入。为了充分利用空间信息,我们引入了一种使用球谐变换(SHT)系数作为辅助模型输入的方法。这些系数简明地代表了空间分布。具体来说,我们的模型有两个编码器,一个用于 STFT,另一个用于 SHT。通过融合解码器中的两个编码器来估计增强的 STFT,我们有效地合并了空间上下文。在不同噪声和混响下对 TIMIT 的评估表明我们的模型优于既定基准。值得注意的是,这是通过更少的计算和参数来实现的。通过利用球谐函数合并方向提示,我们的模型有效地提高了多通道语音增强的性能。
嘉宾简介:赵昌江,内蒙古大学语音信号处理组,硕士二年级,导师张学良教授,研究方向为语音增强。
摘要:语音增强旨在提高语音质量和可懂度,特别是在嘈杂环境中,会降低语音的质量和可懂度。目前,深度学习方法在语音增强方面取得了巨大成功,例如,具有代表性的卷积循环神经网络(CRN)及其变体。然而,CRN 通常采用连续下采样和上采样卷积进行频率建模,这破坏了信号随频率变化的固有结构。此外,卷积层缺乏时间建模能力。为了解决这些问题,我们提出了一种创新的模块,结合了状态空间模型(SSM)和inplace卷积,并取代了CRN中的传统卷积,称为SICRN。具体来说,双路径多维状态空间模型捕获全局频率依赖性和长期时间依赖性。2D-inplace卷积实质就是将卷积核的步幅调为1,使用它来捕获局部结构,放弃了下采样和上采样。对公共 INTERSPEECH 2020 DNS 挑战数据集的系统评估证明了SICRN的有效性。与强基线相比,SICRN 实现了接近最先进的性能,同时模型有着较小的参数量和计算量。所提出的 SICRN 展示了改进语音增强的巨大前景。
嘉宾简介:方元,内蒙古大学语音信号处理组,硕士二年级,导师张学良教授,研究方向为EEG脑电信号转换语音。
摘要:我们在ICASSP 2024 Signal Processing Grand Challenge (SPGC)的听觉脑电信号挑战赛任务2中的方案。我们引入了一种采用交叉注意力引导的WaveNet,从粗粒度到细粒度的生成策略,旨在增强从时域EEG中重建梅尔频谱的效果。该模型利用WaveNet按顺序从粗到细的粒度水平重建包络、10个频带的梅尔谱、80个频带的梅尔谱和幅度谱。为了弥合不同模态之间的差距,我们引入了交叉注意力机制,探索不同模态之间的相关性。我们在验证集上实现了0.0651±0.0153的皮尔森相关系数值,在测试集上实现了0.0413±0.0169的皮尔森相关系数值,获得了竞赛的第二名。
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信