INTERSPEECH 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。本次论文预讲会按照技术领域投稿和实验室专场两种形式进行招募,欢迎大家投稿报名!
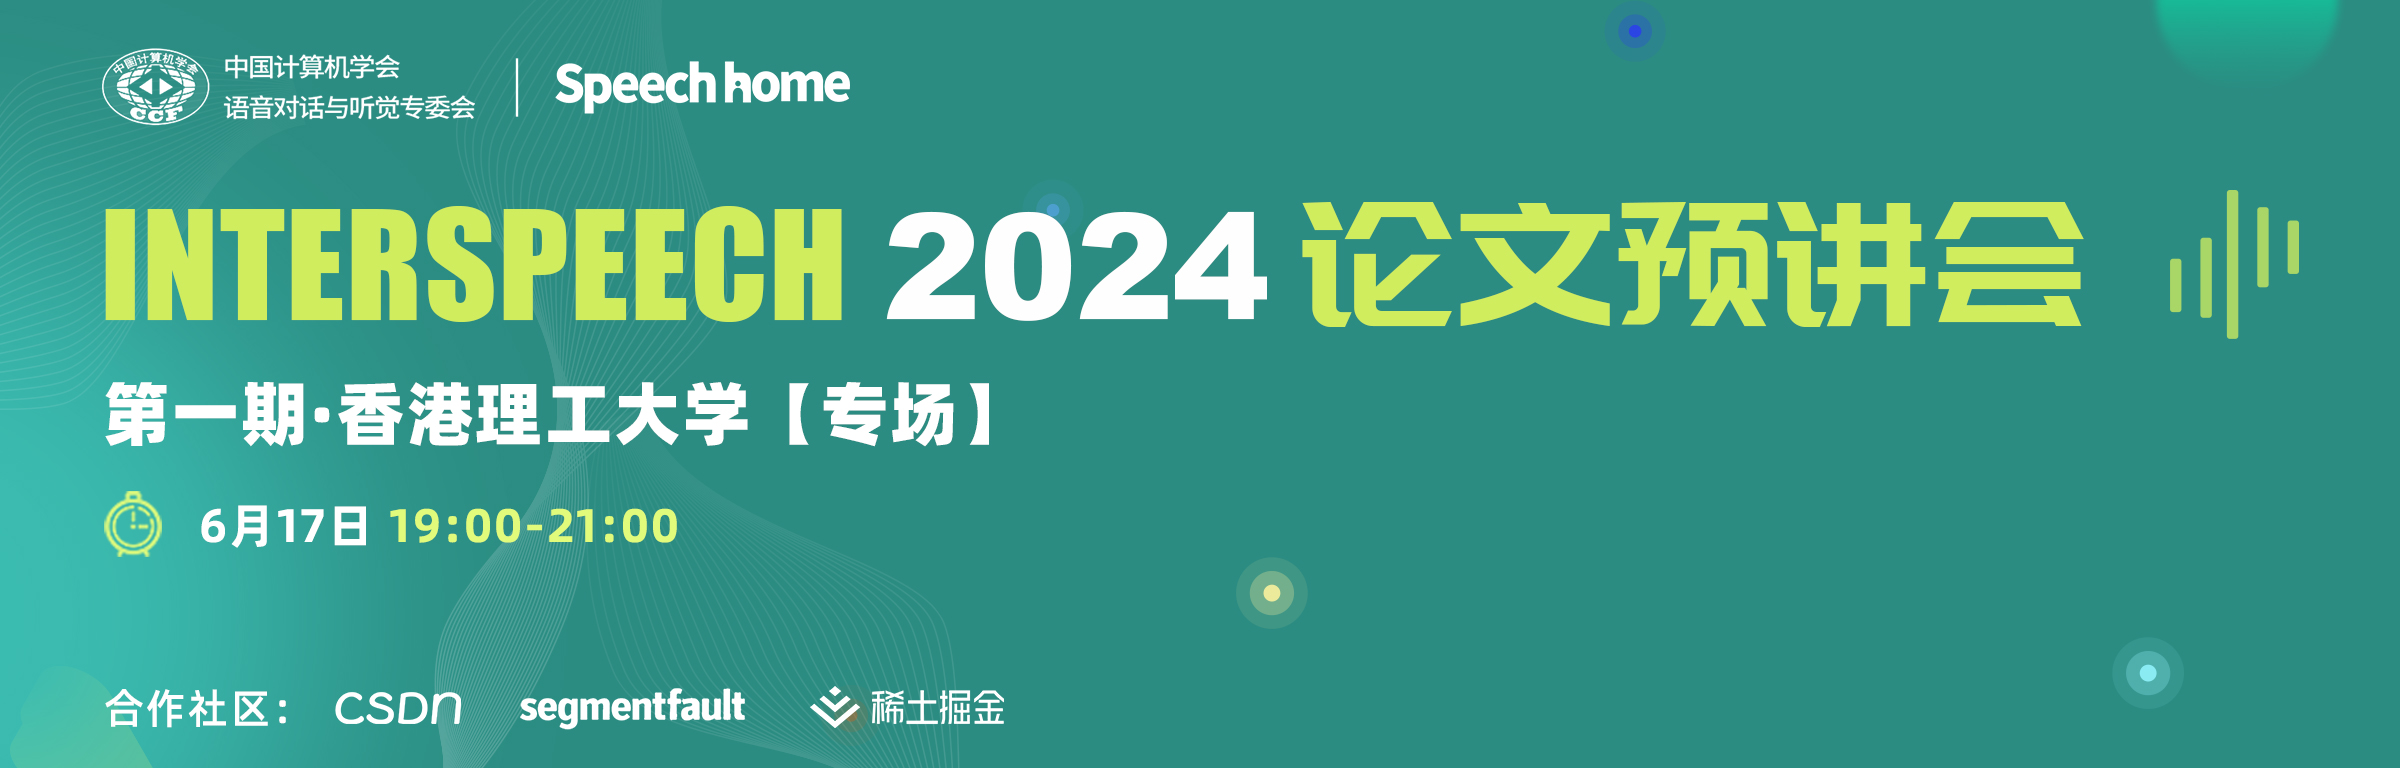
INTERSPEECH 2024 论文预讲会第一期邀请到香港理工大学做本次会议的专场分享,欢迎大家观看。
香港理工大学【专场】
时间:6月17日(周一)19:00 ~ 21:00
形式:线上
议程:每位嘉宾分享30分钟(含5分钟QA)
嘉宾简介:李哲,香港理工大学在读博士,美国斯坦福大学访问学生学者。IEEE会员,中国人工智能学会会员。曾主持研究生科研创新项目1项,参与多项多语种智能信息处理相关的国家重点研发计划,国家自然科学基金以及香港资助局项目。获得中国人工智能学会优秀科技成果奖1项。发表CCF会议、SCI、EI及中文核心论文共计36篇,获得发明专利2项,软件著作权1项。分享主题:Parameter-efficient Fine-tuning of Speaker-Aware Dynamic Prompts for Speaker Verification摘要:提示微调 (Prompt tuning) 可以有效减少预训练Transformer中的可调参数。然而,它在捕捉说话人特征方面较弱,因为提示很容易过拟合适应性语音样本,导致无法很好地泛化到未见过的说话人。本文引入了一个包含可学习提示的提示池来解决这个问题。与传统方法学习每个训练语音样本的一组固定提示不同,我们的方法使用动态选择策略,从提示池中选择最匹配的提示,使每个提示都由高度匹配的说话人微调。目标是使池中的提示形成说话人聚类,增强下游分类器中的说话人预测能力,同时保持预训练Transformer的可塑性。我们在说话人验证的语言不匹配实验中证明,动态提示池提供了一种高效的内存和计算解决方案,用于微调预训练Transformer以实现帧级别的说话人表征。
嘉宾简介:金泽众,香港理工大学电机及电子工程学系博士研究生。分别在河北大学和香港理工大学获得学士学位和硕士学位。研究方向包括声纹识别,自监督学习,语音识别和语音克隆。
分享主题 1:W-GVKT: Within-Global-View Knowledge Transfer for Speaker Verification
摘要:自监督对比学习在说话人验证(SV)中发挥了重要作用。然而,这类方法存在假负样本的问题。为了解决这个问题,我们增强了非对比的DINO框架,通过多样化的全局视图版本实现教师网络向学生网络的知识迁移,并将该方法称为Within-Global-View Knowledge Transfer(W-GVKT)DINO。我们发现,在给定整个话语的全局视图的情况下,通过对全局视图应用谱增强和特征多样化来在学生网络的输出中制造差异,可以促进教师网络向学生网络的知识转移。几乎没有增加计算资源的情况下,W-GVKT在没有使用VoxCeleb1上的说话人标签的情况下,实现了令人印象深刻的4.11%的EER。当与RDNIO框架结合使用时,W-GVKT实现了2.89%的EER。分享主题 2:Self-Supervised Learning with Multi-Head Multi-Mode Knowledge Distillation for Speaker Verification
摘要:训练无标签数据的说话人验证(SV)系统具有挑战性。为了应对这一挑战,我们提出了基于知识蒸馏的多头多模式(MeMo)自监督学习方法。与DINO不同,MeMo中的教师网络使用两种不同的架构进行协作学习,学生网络也是如此。MeMo采用两种蒸馏模式:自蒸馏和交叉蒸馏,其中教师和学生分别采用相同和不同的架构。为了减少由不同架构引起的输出差异,我们将投影头分为自投影头和交叉投影头,使每个投影头负责其相应模式下的蒸馏。我们还发现,在嵌入级别的对比学习只在训练初期阶段有帮助。为了解决这个问题,我们提出在继续知识蒸馏的同时动态停止对比学习。使用小型ECAPA-TDNN骨干网络,MeMo在VoxCeleb1上实现了令人印象深刻的EER 3.10%。
嘉宾简介:黄梓龙,香港理工大学电机及电子工程学系一年级博士研究生。研究兴趣包括情感计算、多模态交互等。分享主题:MM-NodeFormer: Node Transformer Multimodal Fusion for Emotion Recognition in Conversation摘要:对话情感识别(ERC)在人机交互和医疗咨询中具有巨大的应用前景。现有的ERC方法主要关注文本和语音模态中的信息,并且通常仅对多模态特征进行简单地拼接,忽视了各个模态中情感信息的丰富度差异。为了解决上述问题,我们提出了一种名为MM-NodeFormer的多模态模型,该模型利用Transformer编码器在不同编码阶段的特点,根据各模态的情感丰富度融合文本、音频与视觉模态的情感特征。模型将文本视为主要模态,音频和视觉作为辅助模态,通过利用主要模态与辅助模态之间的互补性,提升情绪特征融合的质量。我们在两个公开的基准数据集IEMOCAP和MELD上进行了广泛的实验,分别实现了74.24%和67.86%的准确率,表明了所提出方法的有效性。
直播将通过语音之家微信视频号进行直播
扫码添加语音小管家,进入语音之家讨论群
INTERSPEECH 2024 论文预讲会按照技术领域投稿和实验室专场两种形式进行招募。

为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信